서버 일을 하다 보면 “어느 클라우드 쓰세요?”라는 질문을 자주 받습니다. 대답은 대개 기술이 아니라 사정으로 정해집니다. 회사가 이미 Microsoft 365 를 쓰고 있다거나, 첫 서비스를 AWS 로 올렸다거나, 앱이 Firebase 위에서 돌고 있다거나 하는 식입니다. 세 곳 모두 가상 머신, 객체 스토리지, 관리형 DB, 서버리스, 컨테이너 오케스트레이션을 다 갖고 있어서 “이 기능은 여기에만 있다”로 갈리는 경우는 드뭅니다. 이 글에서는 서비스 이름이 어떻게 대응되는지, 구조와 과금 모델이 어디서 달라지는지, 그래서 어떤 상황에 어디를 먼저 보면 되는지를 적었습니다.
시장에서의 위치
Synergy Research Group 이 2025년 11월 19일에 낸 보고서에 따르면 2025년 3분기 전 세계 클라우드 인프라 서비스 매출은 약 1,070억 달러였고, 점유율은 Amazon 29%, Microsoft 20%, Google 13% 였습니다. 세 곳을 합치면 63% 입니다. 1위는 Amazon 이지만 2위와 3위도 합쳐서 3분의 1 이상을 차지하니, “AWS 하나로 통일” 이 정답인 시장은 아닙니다. 점유율이 곧 서비스 품질은 아닙니다. 다만 채용 시장, 자료, 서드파티 도구의 지원 범위는 점유율을 꽤 따라갑니다.
서비스 대응표
아래 표는 자주 쓰는 영역만 골라 맞춰 본 것입니다. 이름이 비슷하다고 동작까지 같다는 뜻은 아니어서, 대응표는 검색어를 찾는 용도로만 쓰시는 편이 안전합니다.
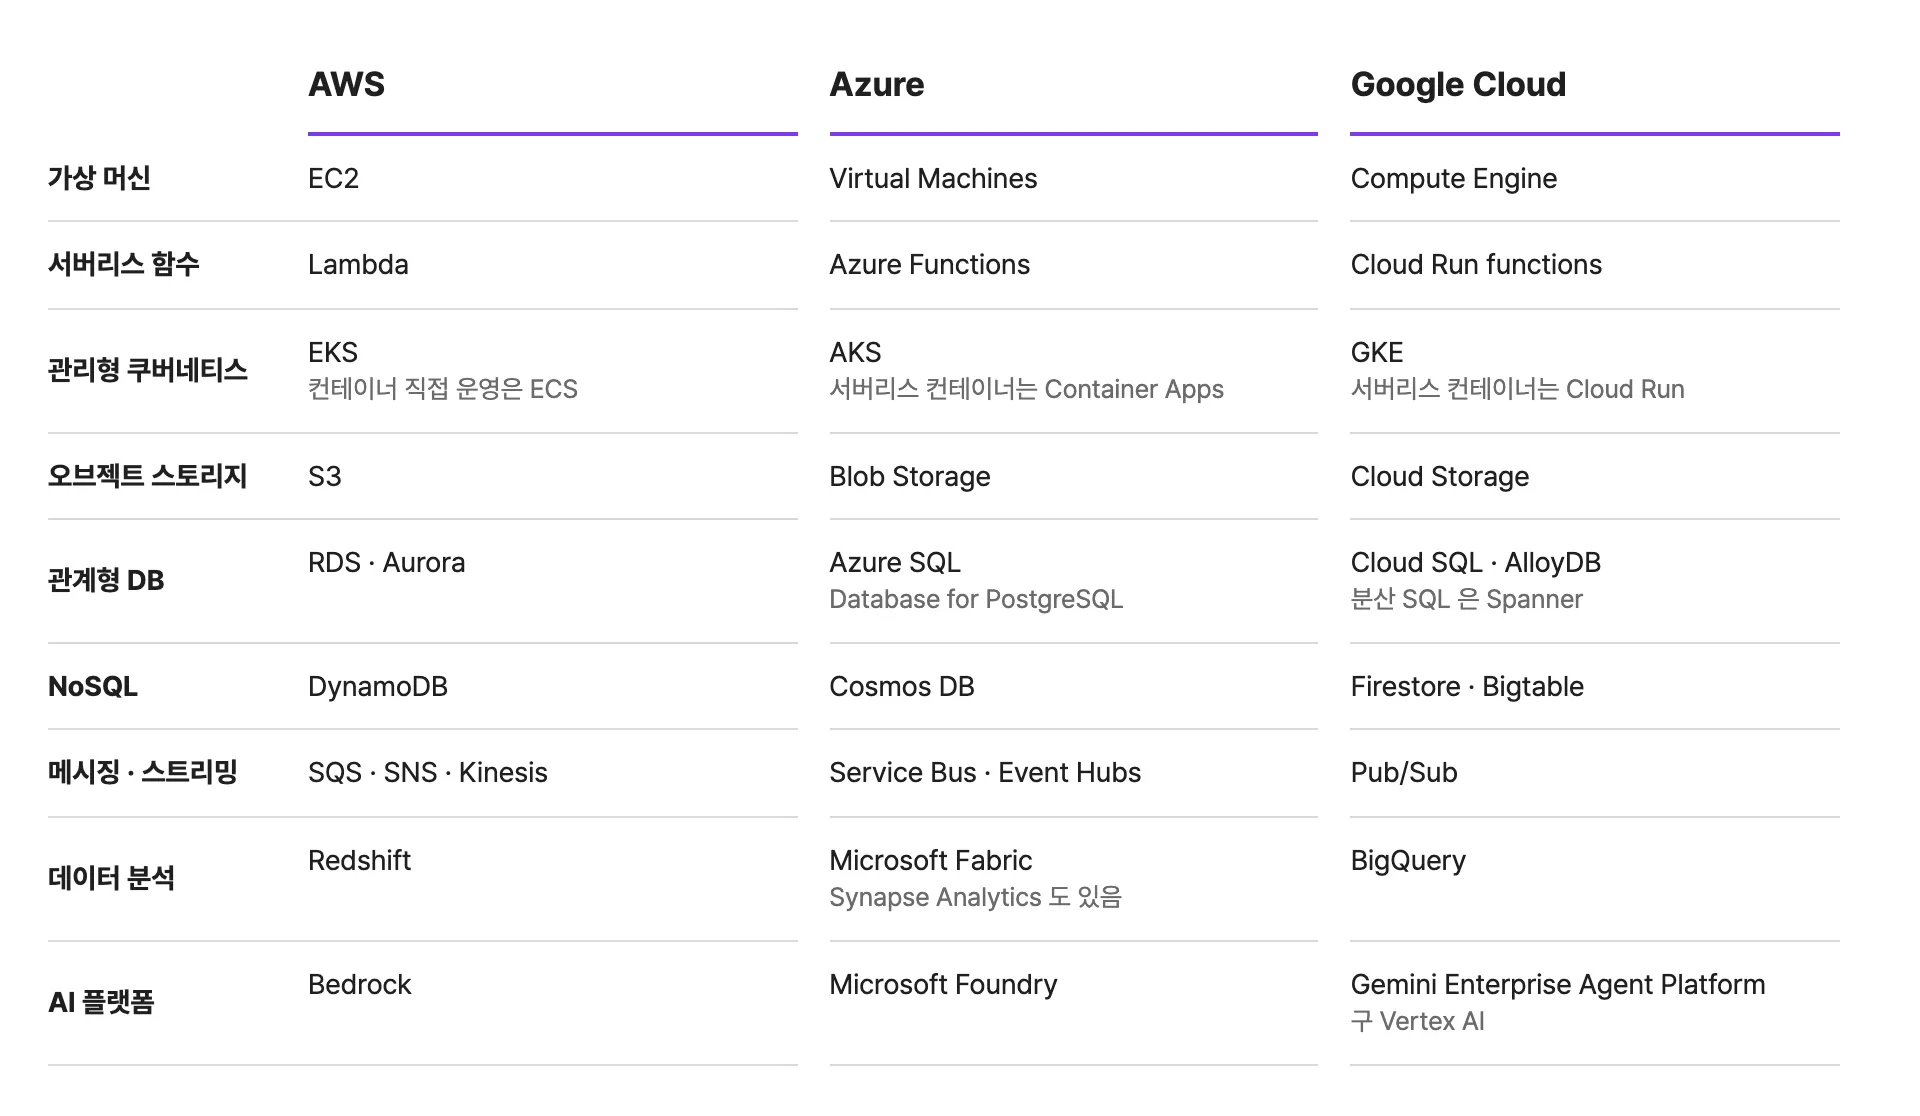
몇 가지는 이름이 최근에 바뀌어서 옛 글을 보면 헷갈립니다.
- Google 의 서버리스 함수는 Cloud Run functions 입니다. 공식 문서가 이전 이름을 Cloud Functions (2nd gen) 으로 적어 둡니다.
- Azure 의 AI 플랫폼은 Azure AI Studio, Azure AI Foundry 를 거쳐 지금은 Microsoft Foundry 입니다. 기존 Azure OpenAI 리소스를 Foundry 리소스로 올리는 경로도 문서에 있습니다.
- Google 은 2026년 4월 22일에 Vertex AI 를 Gemini Enterprise Agent Platform 의 일부로 편입하면서 하위 제품 이름도 같이 바꿨습니다. 릴리스 노트에 Vertex AI Studio 가 Agent Studio 가 되었다는 매핑표가 있습니다. 예전 링크는 리다이렉트로 이어집니다.
- Azure 의 분석 쪽에는 Synapse Analytics 와 Microsoft Fabric 이 같이 있습니다. Fabric 은 OneLake 라는 단일 논리 데이터 레이크 위에 데이터 엔지니어링, 웨어하우스, 실시간 분석, Power BI 를 얹은 SaaS 이고, 문서도 Azure 계정 없이 쓸 수 있다고 적습니다.
AI 모델 쪽은 예전처럼 “OpenAI 는 Azure, Claude 는 AWS, Gemini 는 GCP” 로 단순하게 나뉘지 않습니다. AWS Bedrock 문서는 Anthropic 과 OpenAI 를 포함해 100개 이상의 모델을 제공한다고 적고, Microsoft Foundry 는 Microsoft, OpenAI, Anthropic, Meta 등의 모델 1만 개 이상을 카탈로그에 올려 두었다고 합니다. 어느 클라우드에서 어느 모델을 쓸 수 있느냐는 도입 직전에 각 카탈로그에서 확인하는 항목이 되었습니다.
데이터베이스 영역은 제품 철학 차이가 더 큽니다. DynamoDB 나 Cosmos DB 를 고를 때 데이터 모델을 어떻게 잡느냐는 RDBMS 와 NoSQL 글에서 다뤘고, 메시징에서 Kinesis, Event Hubs, Pub/Sub 이 Kafka 와 어떻게 다른지는 Apache Kafka 글을 보시면 됩니다.
계정과 리소스를 묶는 방식
대응표보다 실무에서 오래 영향을 주는 건 조직 구조입니다. 나중에 바꾸기 어렵기 때문입니다.
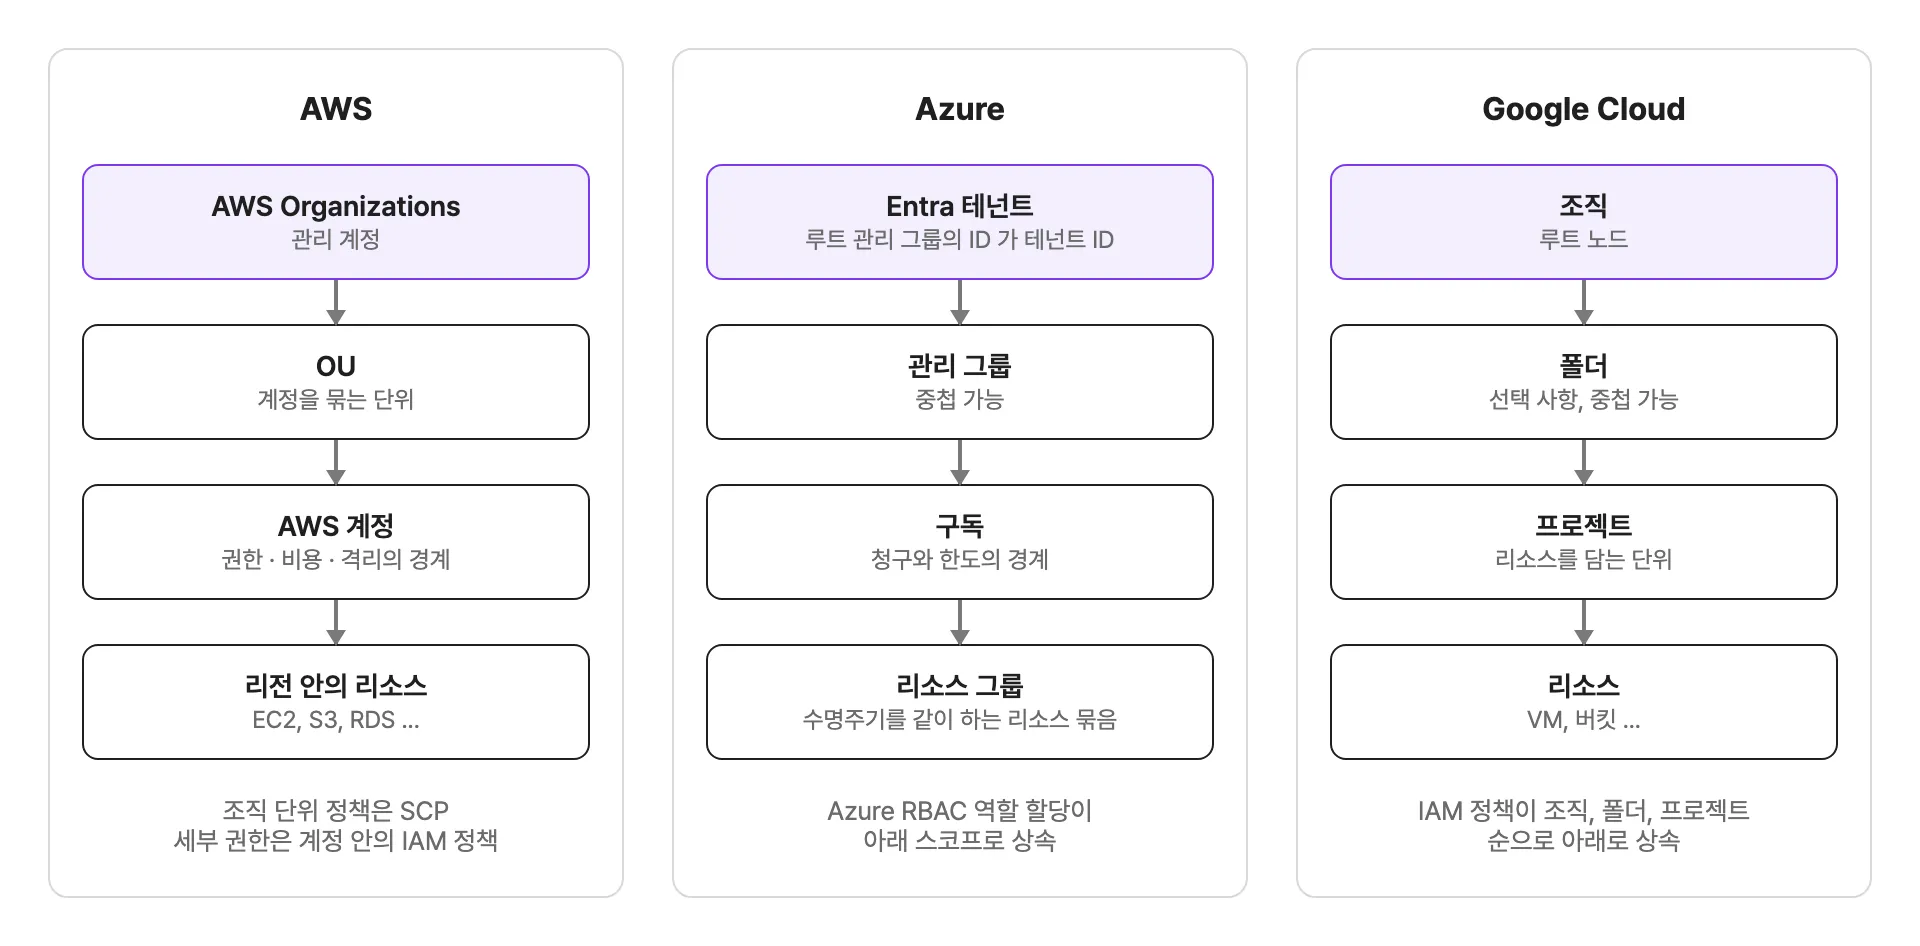
AWS 에서 격리의 기본 단위는 계정입니다. AWS Organizations 문서가 계정을 권한, 보안, 비용, 워크로드의 자연스러운 경계라고 부르고, 운영과 개발을 계정으로 나누는 멀티 계정 구성을 권합니다. 계정은 OU 로 묶고 그 위에 SCP 같은 조직 정책을 겁니다.
Azure 는 Entra 테넌트 가 최상단입니다. 테넌트마다 루트 관리 그룹이 하나 있고, 그 ID 가 테넌트 ID 와 같습니다. 그 아래로 관리 그룹이 최대 6단계 깊이까지 중첩되고, 구독이 달리고, 구독 안에서 리소스 그룹으로 묶습니다. 모든 구독은 같은 Entra 테넌트를 신뢰해야 하므로 사용자 디렉터리와 리소스 계층이 한 몸입니다.
GCP 는 조직, 폴더, 프로젝트 입니다. 폴더는 선택 사항이고, 프로젝트가 서비스 리소스를 담는 단위입니다. 프로젝트의 소유자가 회사를 떠나도 프로젝트는 조직에 남아 있습니다.
IAM 이 다르게 생겼습니다
세 곳 모두 “누가 무엇을 어디에” 를 정하지만 표현 방식이 다릅니다.
AWS IAM 은 JSON 정책 문서가 중심입니다. 명시적으로 허용하지 않은 것은 기본적으로 거부되고, 정책을 사용자, 그룹, 역할 같은 아이덴티티에 붙이거나(identity-based) S3 버킷처럼 리소스에 붙입니다(resource-based). 계정을 넘나드는 접근은 역할을 맡는 방식(AssumeRole)이 기본 패턴입니다. 서비스가 서비스를 호출할 때도 역할이 쓰이니 처음에는 “역할이 사람이 아니라 권한 묶음이구나” 하는 감각을 잡는 데 시간이 걸립니다.
Azure 는 역할 할당이 핵심 개념입니다. 보안 주체(사용자, 그룹, 서비스 주체, 관리 ID), 역할 정의, 스코프 세 요소로 할당이 만들어지고, 스코프는 관리 그룹, 구독, 리소스 그룹, 리소스 중 어느 층이든 가능하며 아래로 상속됩니다. 여러 할당이 겹치면 합산되는 가산 모델이고, deny assignment 가 걸리면 차단됩니다. 사용자와 그룹은 Entra ID 에서 오기 때문에, 회사가 이미 Entra ID 로 계정을 관리한다면 입사와 퇴사 처리가 그대로 클라우드 권한까지 이어집니다.
GCP 는 정책이 리소스 계층을 따라 내려옵니다. 조직에서 Network Admin 을 주면 모든 프로젝트의 네트워크에 적용되고, 한 리소스의 유효 정책은 거기에 직접 붙은 정책과 상위에서 상속된 정책의 합입니다. 구조가 단순해서 읽기 쉬운 대신, 높은 곳에서 준 권한이 아래로 다 스며든다는 점을 늘 의식해야 합니다.
요금 모델의 뼈대
단가는 이 글에서 다루지 않습니다. 가격표는 자주 바뀌고 리전마다 다르니 계산기로 직접 뽑아 보셔야 합니다. 구조는 세 곳이 닮았습니다.
- 온디맨드: 쓴 만큼 냅니다. 약정이 없어서 가장 비싸고 가장 자유롭습니다.
- 약정 할인: AWS Savings Plans 는 시간당 사용량을 1년 또는 3년 약정하고, Compute Savings Plans 는 인스턴스 패밀리, 크기, 리전과 무관하게 EC2 와 Fargate, Lambda 에 적용됩니다. Azure 의 savings plan 도 시간당 금액을 약정하는 방식이고, 특정 리소스, 크기, 리전을 고정하는 reservation 은 할인폭이 더 큰 대신 사용량이 안정적일 때 맞습니다. GCP 의 committed use discount 는 지출 기반과 리소스 기반이 있고, 리소스 기반은 Compute Engine 에만 적용됩니다.
- 사용 시간 자동 할인: GCP 의 sustained use discount 는 약정 없이 한 달 사용량에 따라 붙는 할인인데, 문서가 적용 대상 머신 시리즈를 한정합니다. N1, N2, N2D, C2, M1, M2 같은 시리즈가 대상이고 E2 는 목록에 없습니다. “GCP 는 쓰면 자동으로 깎아 준다” 는 말을 그대로 믿고 E2 를 쓰면 기대와 다릅니다.
- 스팟 계열: 세 곳 모두 남는 용량을 싸게 쓰는 대신 회수될 수 있는 인스턴스를 제공합니다. 중단돼도 괜찮은 배치 작업이나 CI 워커에 맞습니다.
그리고 가격표에서 가장 늦게 보이는 항목이 나가는 트래픽(egress) 입니다. 인터넷으로 나가거나 리전과 클라우드를 넘나드는 트래픽에는 요금이 붙는데, 서비스가 커질수록 이 항목이 눈에 띄게 됩니다. 멀티 클라우드를 구상한다면 데이터가 어디서 어디로 얼마나 흐르는지를 먼저 그려 봐야 합니다. Fabric 이 S3 나 Cloud Storage 를 복사 없이 가리키는 shortcut 을 제공하면서 egress 비용을 줄이는 캐싱을 내세우는 것도 같은 문제의식입니다.
서울 리전
국내 서비스라면 지연 시간과 데이터 거주 요건 때문에 서울 리전이 사실상 출발점입니다.
| 클라우드 | 서울 리전 | 비고 |
|---|---|---|
| AWS | Asia Pacific (Seoul), ap-northeast-2 | 기본 활성화 리전이라 계정을 만들면 바로 씁니다 |
| Azure | Korea Central (서울), Korea South (부산) | Korea Central 은 가용성 영역 3개, Korea South 는 가용성 영역 지원 없음. 둘이 짝 리전 |
| GCP | Seoul, asia-northeast3 | 영역 a, b, c 3개 |
Azure 는 서울 외에 부산에도 리전이 있어서, 재해 복구를 한국 안에서 끝내려는 요구가 있으면 이 짝 리전 구성이 근거가 됩니다. 다만 리전이 있다고 모든 서비스가 있는 건 아닙니다. 새 서비스는 서울에 늦게 들어오는 경우가 흔해서, 쓰려는 서비스의 리전 지원 표를 먼저 확인해야 합니다. GCP 문서는 새 리전에서 Compute Engine, GKE, Cloud Storage, Cloud SQL 같은 기본 제품이 처음부터 제공되고, Cloud Run, Bigtable, Spanner, BigQuery, Pub/Sub 같은 제품은 출시 후 6개월 안에 추가된다는 정책을 적어 둡니다.
프리티어는 서울에서 안 통할 수 있습니다
학습용이나 사이드 프로젝트로 시작할 때는 무료 범위가 결정 요소가 됩니다. 조건은 세 곳이 다 다릅니다.
| 클라우드 | 신규 계정 크레딧 | 상시 무료 |
|---|---|---|
| AWS | 무료 플랜 가입 시 $100, 서비스를 써 보면 최대 $100 추가(총 $200). 계정은 6개월 뒤 또는 크레딧 소진 시 닫힘 | 30개 이상 서비스가 월 사용 한도 내 무료 |
| Azure | $200, 30일 안에 사용 | 12개월 동안 20개 이상 서비스의 월 무료 분량, 65개 이상 서비스 상시 무료 |
| GCP | $300, 가입 후 90일 | Compute Engine e2-micro 1대, BigQuery 월 1 TiB 쿼리와 10 GiB 저장, Cloud Run 월 200만 요청 등 |
여기서 GCP 쪽 함정이 하나 있습니다. Compute Engine 의 무료 e2-micro 는 us-west1, us-central1, us-east1 에서만 적용되고, Cloud Storage 무료 5 GB 도 미국 리전에 한정됩니다. 서울에 올리면 이 무료 혜택을 못 받습니다. 학습용이라면 지연 시간은 포기하고 미국 리전을 쓰거나, 아니면 처음부터 유료로 생각해야 합니다. AWS 무료 플랜은 6개월 뒤 계정이 닫히니, 방치해 둔 실습 계정이 그대로 남아 있을 거라고 기대하면 안 됩니다.
모바일 개발자 입장에서
저처럼 Android 를 하다 서버를 겸하는 사람은 클라우드를 Firebase 로 처음 만납니다. 그런데 Firebase 프로젝트는 별개의 서비스가 아니라 Google Cloud 프로젝트 입니다. 공식 문서도 새 Firebase 프로젝트를 만들면 뒤에서 Google Cloud 프로젝트를 만드는 것이라고 적고, IAM 권한과 결제, 고유 식별자를 둘이 공유하며 한쪽을 지우면 다른 쪽도 지워진다고 설명합니다.
이 사실은 두 가지로 이어집니다. 하나는 앱이 커질 때 Firestore 나 Cloud Storage 의 데이터를 BigQuery 로 보내 분석하고, Cloud Run 에 별도 백엔드를 올리는 식으로 같은 프로젝트 안에서 확장할 수 있다는 점입니다. 다른 하나는 IAM 과 결제가 Google Cloud 와 한 몸이라, 팀원 권한과 요금 알림을 Google Cloud 쪽에서 관리하게 된다는 점입니다. Firebase 와 Supabase 중 무엇을 고를지는 Supabase 와 Firebase 글에 따로 정리했습니다.
반대로 AWS 나 Azure 를 쓰면서 앱에서 직접 붙을 때는 SDK 를 어느 쪽이 잘 지원하는지 따져 봐야 합니다. 어느 쪽이든 모바일 앱이 클라우드 리소스에 직접 접근하게 두기보다 백엔드 API 를 한 겹 두는 쪽이 키 관리와 권한 설계에서 덜 위험합니다.
컨테이너 쪽에서 본 차이
컨테이너 이미지를 만드는 부분은 어느 클라우드든 같습니다. Docker 로 만든 이미지가 ECR, ACR, Artifact Registry 어디로든 올라갑니다. 차이는 그 위에서 굴리는 방법입니다. 쿠버네티스를 직접 쓰려면 EKS, AKS, GKE 가 있고 쿠버네티스 글의 개념이 그대로 적용됩니다. 클러스터 운영이 부담스럽다면 ECS, Azure Container Apps, Cloud Run 처럼 컨테이너만 올리면 되는 쪽이 있습니다. 이쪽은 클라우드마다 모델이 달라 이식성이 쿠버네티스보다 낮습니다. 락인을 줄이고 싶으면 이미지와 쿠버네티스 매니페스트까지만 이식 가능하다고 생각하시는 게 현실적입니다.
상황별로 먼저 볼 곳
정답표는 아니고 첫 후보를 줄이는 용도입니다.
- 회사가 Microsoft 365 와 Entra ID 를 이미 씁니다. Azure 가 제일 자연스럽습니다. 계정과 권한이 한 디렉터리에 있고, .NET 이나 SQL Server 자산이 있다면 더 그렇습니다.
- 스타트업이 서버 스택을 처음 정합니다. 자료, 채용, 서드파티 지원 면에서 AWS 가 무난합니다. 서비스가 가장 많은 만큼 고를 게 많다는 부담도 같이 옵니다.
- 분석과 데이터 파이프라인이 핵심입니다. BigQuery 가 시작점이 되는 경우가 많습니다. 쿠버네티스를 만든 Google 이라 GKE 를 선호하는 팀도 있습니다.
- 앱이 이미 Firebase 위에 있습니다. 같은 프로젝트에서 GCP 로 넓히는 것이 가장 마찰이 적습니다.
- 기존 온프레미스와 하이브리드로 가야 합니다. Azure 가 Windows 와 SQL Server 라이선스 혜택, Entra ID 연동에서 유리한 경우가 많습니다. 구체 조건은 계약 형태(EA, MCA)에 따라 달라집니다.
- 멀티 클라우드를 해야 합니다. 이유가 규제나 고객 요구가 아니라 “혹시 몰라서” 라면 말리고 싶습니다. 운영 부담과 egress 비용이 두 배가 되는데 이식성은 서비스 사이 차이 때문에 생각만큼 안 나옵니다.
한 가지 기준만 꼽으라면 이미 쓰고 있는 것과 팀이 아는 것 입니다. 서비스 목록은 거의 겹치니, 권한 구조와 과금 구조를 팀이 얼마나 빨리 이해하고 운영할 수 있느냐가 실제 비용을 좌우합니다.
참고 자료
- Synergy Research Group: Cloud Market Share Trends - Big Three Together Hold 63% while Oracle and the Neoclouds Inch Higher
- AWS: Regional endpoints (region names and codes)
- AWS: Enable or disable AWS Regions in your account
- Azure: List of Azure Regions
- Google Cloud: Cloud locations
- Google Cloud: Compute Engine regions and zones
- AWS: What is AWS Organizations?
- AWS: How permissions and policies provide access management
- Azure: What is Azure role-based access control (Azure RBAC)?
- Azure: Organize your resources with management groups
- Google Cloud: Resource hierarchy
- AWS: What are Savings Plans?
- Azure: What are savings plans?
- Google Cloud: Committed use discounts
- Google Cloud: Sustained use discounts
- AWS Free Tier
- Azure free account
- Google Cloud: Free cloud features and trial offer
- Amazon Bedrock: Overview
- Microsoft Foundry: What is Microsoft Foundry?
- Gemini Enterprise Agent Platform: Release notes
- Cloud Run functions: Comparison
- Microsoft Fabric: What is Microsoft Fabric
- Azure Synapse Analytics: What is Azure Synapse Analytics?
- Firebase: Learn more about Firebase projects