“RDBMS 는 정합성, NoSQL 은 확장성”이라는 한 줄 요약은 이제 절반만 맞습니다. 출발점은 분명 달랐습니다. 관계형은 데이터를 정규화해 두고 어떤 질문이 오든 SQL 로 풀어내는 쪽에서 시작했고, NoSQL 은 답해야 할 질문을 먼저 정한 뒤 그 모양대로 저장하는 쪽에서 시작했습니다. 그런데 지금은 PostgreSQL 이 JSON 을 인덱싱하고, MongoDB 가 다중 문서 트랜잭션을 지원하고, DynamoDB 에도 트랜잭션 API 가 있습니다. 서로의 영역을 꽤 넘나드는 셈입니다. 이 글에서는 차이가 아직 남은 곳과 흐려진 곳을 나눠서 적었습니다.
PostgreSQL 18 은 2025년 9월 25일에 나와 현재 18.6 까지 패치가 나왔고, 19 는 2026년 10월 15일에 RC 1 이 공개되었습니다. MongoDB 9.0 은 2026년 9월 28일에 출시되었고, Apache Cassandra 의 최신 GA 는 2026년 8월 7일 릴리스인 5.0.9 입니다. 전통적인 RDBMS 제품끼리의 비교는 MySQL, Oracle, PostgreSQL 비교에 따로 썼습니다.
데이터 모델
관계형 모델은 테이블, 행, 열, 외래 키로 이뤄집니다. 스키마를 먼저 정의하고, 중복을 줄이려고 정규화하고, 흩어진 데이터는 조인으로 다시 합칩니다. DynamoDB 문서가 이 철학을 잘 요약해 두었는데, RDBMS 는 구현 세부사항이나 성능보다 유연성을 위해 설계하고, 쿼리 최적화가 보통 스키마 설계에 영향을 주지 않는다는 내용입니다.
NoSQL 은 하나의 모델이 아니라 여러 모델의 묶음입니다.
| 모델 | 대표 제품 | 저장 단위 | 어울리는 접근 방식 |
|---|---|---|---|
| 문서 | MongoDB | JSON 계열(BSON) 문서 | 문서 단위 조회와 갱신, 중첩 구조 |
| 키-값 | Redis, Valkey, DynamoDB | 키와 값(또는 자료구조) | 키로 바로 찾는 조회, 캐시, 세션 |
| 와이드 컬럼 | Cassandra, ScyllaDB | 파티션 키로 묶이는 행 | 대량 쓰기, 시계열, 파티션 단위 조회 |
| 그래프 | Neo4j | 노드와 관계 | 관계를 여러 단계 따라가는 질의 |
DynamoDB 는 문서와 키-값의 성격을 둘 다 가집니다. 그래프는 관계 자체가 일급 시민이라, 조인을 여러 번 겹쳐야 하는 질의를 관계 따라가기로 표현할 수 있습니다. 키-값 구조가 낯설다면 해시 테이블에서 본 구조의 확장판이라고 생각하면 편합니다.
같은 주문을 세 가지로 모델링하기
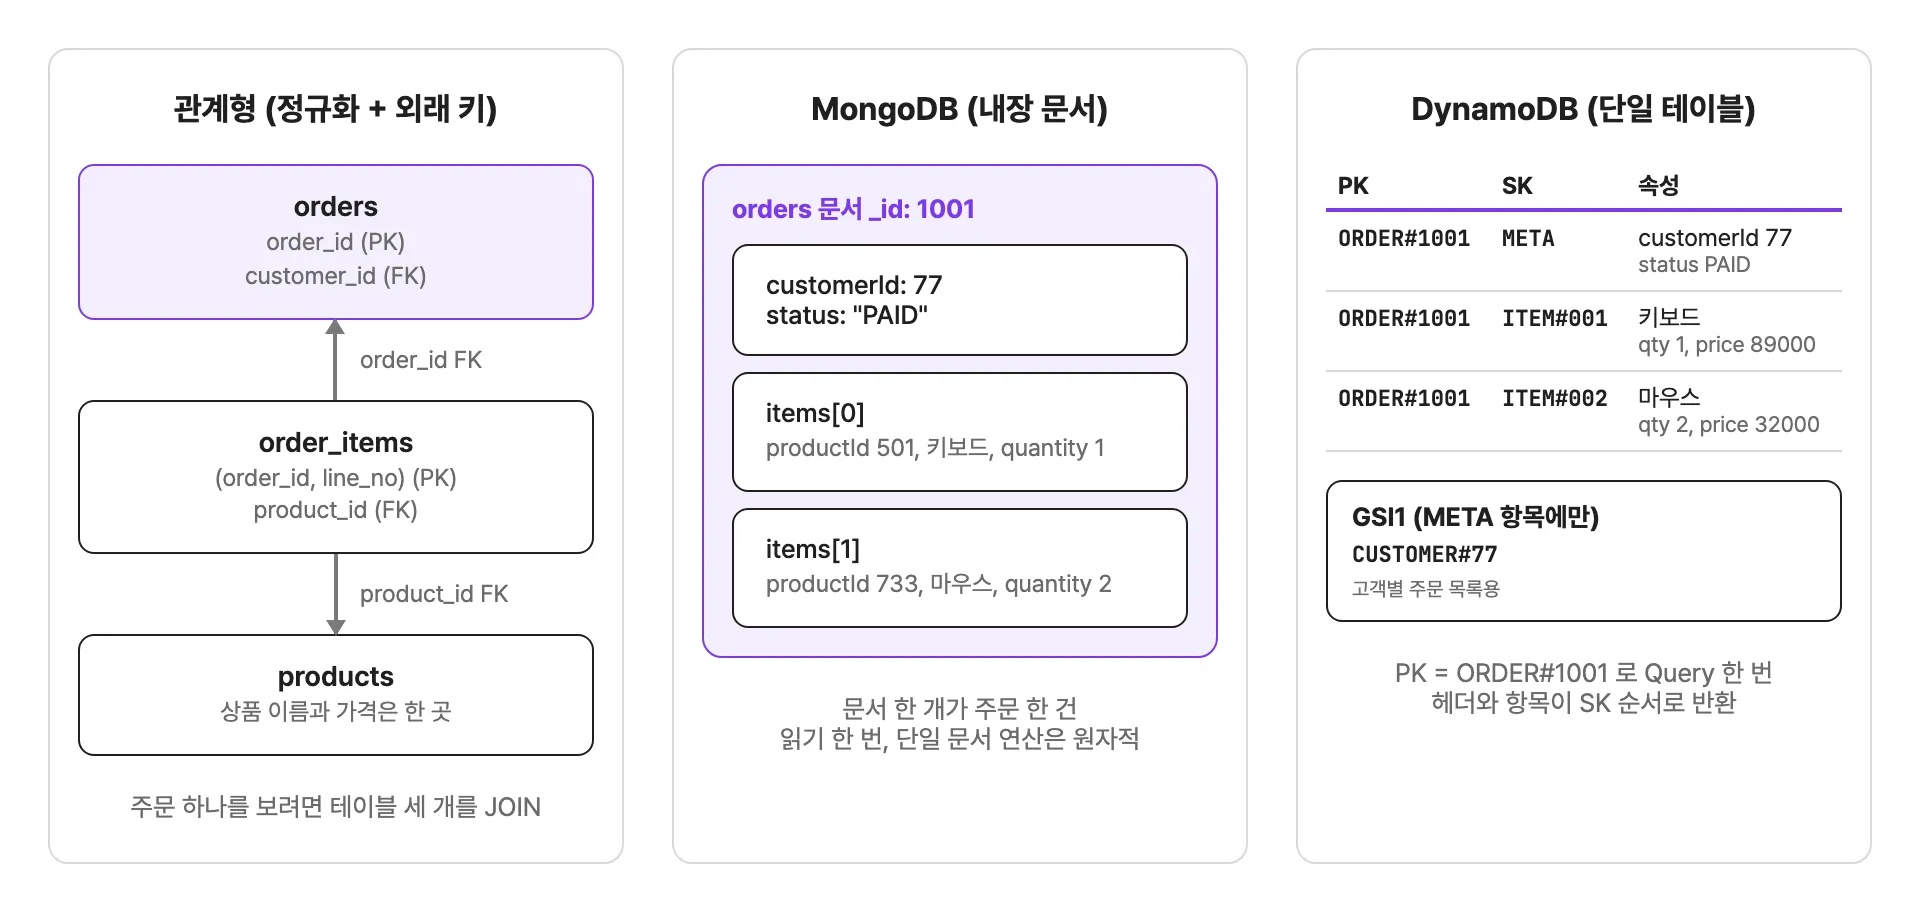
“주문과 주문 항목”을 세 방식으로 표현해 보면 차이가 가장 선명합니다. 관계형에서는 주문과 항목을 별도 테이블로 나누고 외래 키로 잇습니다.
CREATE TABLE orders (
    order_id    BIGINT PRIMARY KEY,
    customer_id BIGINT NOT NULL REFERENCES customers (customer_id),
    ordered_at  TIMESTAMPTZ NOT NULL,
    status      TEXT NOT NULL
);

CREATE TABLE order_items (
    order_id   BIGINT NOT NULL REFERENCES orders (order_id),
    line_no    INT NOT NULL,
    product_id BIGINT NOT NULL REFERENCES products (product_id),
    quantity   INT NOT NULL CHECK (quantity > 0),
    unit_price NUMERIC(12, 2) NOT NULL,
    PRIMARY KEY (order_id, line_no)
);

SELECT o.order_id, i.line_no, p.name, i.quantity
FROM orders o
JOIN order_items i ON i.order_id = o.order_id
JOIN products p ON p.product_id = i.product_id
WHERE o.order_id = 1001;
상품 이름이나 가격이 바뀌어도 products 한 곳만 고치면 되고, 질문이 어느 방향에서 들어와도 조인으로 답할 수 있습니다. 대신 주문 하나를 보여 주려면 테이블 세 개를 읽어야 합니다.
MongoDB 에서는 항목을 주문 문서 안에 내장합니다.
db.orders.insertOne({
  _id: 1001,
  customerId: 77,
  orderedAt: ISODate("2026-11-09T12:40:00Z"),
  status: "PAID",
  items: [
    { productId: 501, name: "키보드", quantity: 1, unitPrice: 89000 },
    { productId: 733, name: "마우스", quantity: 2, unitPrice: 32000 },
  ],
});
주문 한 건이 문서 한 개라서 읽기 한 번으로 끝납니다. 단일 문서 연산은 원자적이기 때문에, 관련 데이터를 내장해 두면 분산 트랜잭션이 필요한 상황 자체가 줄어듭니다. 항목에 상품명 name 을 복사해 둔 건 일부러 한 비정규화입니다. 주문 시점의 이름과 가격을 남겨야 하는 도메인이면 오히려 자연스럽지만, 상품 정보가 바뀔 때마다 모든 주문을 따라 고쳐야 한다면 부담이 됩니다.
DynamoDB 는 접근 패턴을 먼저 정하고 키를 설계합니다. “주문 한 건과 그 항목을 한 번에 가져온다”, “고객의 주문 목록을 최신순으로 본다” 두 가지가 요구사항이라면 테이블 하나에 이렇게 둘 수 있습니다.
PK              SK                    속성
ORDER#1001      META                  customerId=77, status=PAID, orderedAt=...
ORDER#1001      ITEM#001              productId=501, name=키보드, qty=1, price=89000
ORDER#1001      ITEM#002              productId=733, name=마우스, qty=2, price=32000

GSI1PK          GSI1SK
CUSTOMER#77     2026-11-09T12:40:00Z#1001     (META 항목에만 존재, 고객별 주문 목록용 GSI)
PK = ORDER#1001 로 Query 하면 주문 헤더와 항목이 정렬 키 순서대로 한 번에 돌아옵니다. 고객별 주문 목록은 글로벌 보조 인덱스(GSI)로 풉니다. 관련 데이터는 한곳에 두고, 정렬 순서를 활용하고, 트래픽이 한 파티션에 몰리지 않게 키를 분산하고, 다른 질의가 필요하면 GSI 를 만든다는 DynamoDB 문서의 원칙이 그대로 들어간 구조입니다. 문서는 테이블 수를 가능한 한 적게 유지하라고 권하고, 시계열처럼 접근 패턴이 크게 다른 경우만 예외로 둡니다. 흔히 말하는 단일 테이블 설계(single-table design)가 이것입니다.
그 대가로 새 질문이 생기면 키 설계를 다시 해야 합니다. 문서도 DynamoDB 에서 정해진 방식의 질의는 효율적이지만 그 밖의 질의는 비싸고 느릴 수 있다고 분명히 적어 둡니다.
질의 방식과 모델링 철학
세 예제를 놓고 보면 출발점이 다릅니다. 관계형은 데이터 중심입니다. 엔터티와 관계를 먼저 정리해 두면 질의는 나중에 SQL 로 얼마든지 바꿀 수 있습니다. DynamoDB 는 접근 패턴 중심입니다. 문서는 답해야 할 질문을 알기 전에는 스키마 설계를 시작하지 말라고 하고, 데이터 크기, 모양, 속도를 먼저 파악하라고 합니다. MongoDB 는 둘 사이쯤입니다. 문서 모양은 애플리케이션의 조회 단위에 맞추되, $lookup 과 집계 파이프라인으로 어느 정도 임의 질의도 됩니다.
조인과 내장 중 무엇을 고르느냐는 결국 읽기 비용과 쓰기 비용을 맞바꾸는 일입니다. 정규화하면 쓰기가 단순하고 중복이 없는 대신 읽을 때 조인 비용을 냅니다. 내장하거나 비정규화하면 읽기는 빨라지지만 같은 값이 여러 곳에 있으니 갱신할 때 일관성을 애플리케이션이 책임져야 합니다. 읽기 모델과 쓰기 모델을 아예 나누는 방법은 CQRS 와 이벤트 소싱에서 정리했습니다.
스키마 변경도 다릅니다. RDBMS 는 ALTER TABLE 로 구조를 바꾸고 기존 행도 새 구조를 따라야 합니다. NoSQL 은 대체로 스키마 없이 시작해서, 애플리케이션이 여러 버전의 문서 모양을 읽도록 만드는 쪽이 일반적입니다. 이 유연함은 장점이자 짐입니다. 그래서 MongoDB 에는 스키마 검증이 있습니다. 컬렉션에 규칙을 걸면 어긋나는 삽입과 갱신을 기본적으로 거부하고, 거부 대신 경고만 남기게 할 수도 있습니다. 9.0 릴리스 노트를 보면 컬렉션의 모든 문서가 규칙을 만족함을 보장하는 constraint 검증 수준이 새로 들어갔습니다.
일관성과 트랜잭션
RDBMS 의 기본은 ACID 입니다. 원자성, 일관성, 격리성, 지속성을 갖춘 트랜잭션 안에서 여러 테이블을 한꺼번에 바꿉니다. NoSQL 쪽에서는 BASE(Basically Available, Soft state, Eventual consistency)라는 약어가 자주 맞세워집니다. 가용성을 우선하고 복제본 사이의 일관성은 시간이 지나며 맞춰진다는 뜻입니다. 다만 BASE 는 엄밀한 정의라기보다 설계 태도를 가리키는 말이고, 요즘 NoSQL 제품은 일관성 옵션이 제품마다 훨씬 잘게 나뉘어 있습니다.
CAP 과 PACELC
CAP 정리는 네트워크 분할(partition)이 생겼을 때 일관성(C)과 가용성(A) 중 하나를 골라야 한다는 내용입니다. “셋 중 둘을 고른다”는 흔한 설명은 오해입니다. 분할은 고를 수 있는 옵션이 아니라 분산 환경에서 벌어지는 사건이라서, 실제 선택지는 분할이 났을 때 C 와 A 중 무엇을 포기하느냐뿐입니다. 분할이 없으면 둘 다 가질 수 있습니다.
PACELC 는 여기서 한 걸음 더 갑니다. 분할이 있으면(P) 가용성과 일관성 중에서(A/C) 고르고, 평상시에도(E, Else) 지연 시간(L)과 일관성(C) 사이에서 고른다는 모델입니다. 강한 일관성을 얻으려면 복제본의 확인을 기다려야 하니 평상시에도 지연이 늘어납니다. 실무에서는 CAP 보다 이쪽 교환 관계를 더 자주 체감합니다. PA/EL, PC/EC 같은 꼬리표로 제품을 분류하는 글이 많지만, 같은 제품도 설정에 따라 위치가 달라집니다.
제품별 트랜잭션과 일관성 옵션
Cassandra 는 요청마다 일관성 수준을 고르는 tunable consistency 를 제공합니다. ONE 은 복제본 하나의 응답, QUORUM 은 과반수(n/2 + 1), ALL 은 모든 복제본의 응답을 기다립니다. 읽기와 쓰기 수준의 합이 복제 계수(RF)보다 크면(W + R > RF) 최근에 확인된 쓰기를 읽는 것이 보장되고, 읽기와 쓰기에 모두 QUORUM 을 쓰면 이 조건이 충족됩니다. RF 가 3 이면 쿼럼은 2 입니다. 같은 클러스터에서 로그 적재는 ONE 으로, 잔액 같은 값은 QUORUM 으로 다루는 식의 선택이 가능합니다.
MongoDB 는 단일 문서 연산이 원자적이고, 여러 문서에 걸치는 연산은 다중 문서 트랜잭션으로 묶습니다. 리플리카 셋은 featureCompatibilityVersion 4.0 이상, 샤드 클러스터는 4.2 이상이 필요합니다. 문서는 분산 트랜잭션이 대부분 단일 문서 쓰기보다 성능 비용이 크고 좋은 스키마 설계를 대체해서는 안 된다고 경고합니다. 9.0 릴리스 노트에는 동시에 열려 있는 외부 트랜잭션 수를 maxConcurrentMultiDocumentTransactions(기본 10000)로 제한한다는 내용도 있습니다.
DynamoDB 의 TransactWriteItems 는 최대 100개의 쓰기 작업을 하나의 all-or-nothing 연산으로 묶고, 항목 크기 합계는 4 MB 를 넘을 수 없습니다. 클라이언트 토큰으로 멱등성을 줄 수 있고, 트랜잭션 연산과 일반 읽기, 쓰기 사이에는 직렬화 가능(serializable) 격리가 보장됩니다. 비용 쪽을 보면 항목마다 준비와 커밋으로 읽기 또는 쓰기가 두 번 소비되니, 같은 항목을 단순 쓰기할 때보다 용량을 두 배로 계획해야 합니다. 글로벌 테이블에서는 ACID 보장이 쓰기 API 를 호출한 리전 안에서만 유효하고 리전 간 트랜잭션은 지원하지 않습니다.
확장 방식
관계형은 전통적으로 수직 확장, 곧 더 큰 서버에서 시작합니다. 읽기 부하는 읽기 전용 복제본으로 나누고, 쓰기 부하가 한계에 닿으면 애플리케이션이나 미들웨어에서 샤딩합니다. 샤딩을 하면 샤드를 가로지르는 조인과 트랜잭션이 어려워지는데, 이걸 직접 책임져야 하는 게 비용입니다.
NoSQL 은 파티셔닝을 데이터 모델에 아예 넣어서 이 문제를 풉니다. DynamoDB 는 파티션 키로 데이터를 나누고 물리 파티션을 늘려 처리량을 확장하므로, 키를 잘 설계해 트래픽을 고르게 퍼뜨리고 핫스팟을 피하라고 강조합니다. Cassandra 는 파티션 키를 해시해 링 위의 노드에 복제합니다. 그 대신 파티션 키가 질의 방식을 제약합니다. 확장성은 공짜가 아니라 질의의 자유를 내놓고 얻은 것입니다.
지금 상황: 수렴하는 두 계열
요즘 가장 큰 흐름은 경계가 흐려지고 있다는 점입니다.
PostgreSQL 에서는 jsonb 가 문서 저장소 역할을 상당 부분 가져갔습니다. 분해된 이진 형식으로 저장해서 처리가 빠르고, GIN, btree, hash 인덱스를 지원하고, 포함 연산자 @> 로 중첩 구조를 질의할 수 있습니다. 문서도 대부분의 애플리케이션에는 JSON 을 jsonb 로 저장하라고 권합니다.
CREATE TABLE orders_doc (
    order_id BIGINT PRIMARY KEY,
    doc      JSONB NOT NULL
);
CREATE INDEX orders_doc_gin ON orders_doc USING GIN (doc jsonb_path_ops);

SELECT order_id FROM orders_doc
WHERE doc @> '{"status": "PAID", "customerId": 77}';
정형 컬럼과 유연한 문서를 한 트랜잭션 안에서 같이 다룰 수 있다는 게 이 접근의 장점입니다. 반대로 문서 하나가 아주 크거나 문서 단위 수평 확장이 핵심 요구라면 문서 DB 가 여전히 맞습니다.
분산 SQL(NewSQL)은 SQL 과 ACID 를 유지한 채 수평 확장을 노립니다. CockroachDB 는 트랜잭션을 지원하는 강한 일관성의 키-값 저장소 위에 만든 분산 SQL 데이터베이스로, Spanner 와 F1 에서 영감을 받았고 PostgreSQL 와이어 프로토콜을 지원하며 기본 격리 수준이 SERIALIZABLE 입니다. TiDB 는 MySQL 프로토콜과 생태계를 지원하는 오픈소스 분산 SQL 데이터베이스이고, 행 기반 TiKV 와 열 기반 TiFlash 로 트랜잭션과 분석을 함께 다룹니다. 문서에 표시된 stable 버전은 v8.5 입니다. Google Spanner 는 TrueTime 으로 외부 일관성(external consistency)을 제공합니다.
AWS 의 Aurora DSQL 은 서버리스 분산 관계형 데이터베이스로, PostgreSQL 16 과 호환되고 스냅샷 격리의 ACID 트랜잭션을 제공하며 단일 리전 99.99%, 다중 리전 99.999% 가용성을 내세웁니다. 다만 대륙을 넘나드는 다중 리전 클러스터는 아직 지원하지 않는다고 문서에 적혀 있습니다.
NoSQL 쪽에서는 반대 방향으로 수렴합니다. MongoDB 는 앞서 본 다중 문서 트랜잭션과 스키마 검증에 더해 벡터 검색까지 제공합니다. MongoDB Vector Search 는 벡터 임베딩을 다른 데이터와 함께 저장하고 질의하며, 근사 최근접(ANN, HNSW 알고리즘)과 정확 최근접(ENN) 검색을 지원하고 자체 관리 배포에서도 쓸 수 있습니다. PostgreSQL 에서는 확장 pgvector 가 같은 일을 하고, 최신 버전은 0.8.7 이며 HNSW 와 IVFFlat 인덱스를 제공합니다. 전용 벡터 데이터베이스를 따로 두기 전에 지금 쓰는 데이터베이스의 벡터 기능으로 충분한지부터 보는 편이 운영 부담을 줄여 줍니다.
Redis 의 라이선스 변화도 지금 상황의 일부입니다. Redis 는 2024년 3월 20일에 Redis 7.4 부터 BSD 3-Clause 대신 RSALv2 와 SSPLv1 이중 라이선스로 배포하겠다고 발표했고, 공식 FAQ 는 이것이 OSI 정의의 오픈소스가 아니라고 스스로 인정했습니다. 이후 Linux Foundation 산하의 Valkey 가 BSD 라이선스 포크로 이어졌습니다. 2025년 5월 1일에는 Redis 8 부터 OSI 승인 라이선스인 AGPLv3 를 추가 선택지로 제공한다고 발표했고, 같은 글에서 벡터 셋이라는 새 자료형과 Redis Stack 기술(JSON, Time Series, 쿼리 엔진 등)의 코어 통합도 함께 밝혔습니다. Valkey 블로그에는 2026년 5월 19일에 Valkey 9.1 이 발표되었다고 나옵니다. 지금 선택지는 Redis 8(AGPLv3 포함 다중 라이선스)과 Valkey(BSD)로 갈리는 셈이라, 라이선스 조건이 자사 서비스 형태에 영향을 주는지는 법무 쪽에 확인받아야 합니다.
선택 기준
아래 그림은 워크로드별 출발점입니다. 정답표가 아니라 첫 후보를 좁히는 용도로 보시면 됩니다.
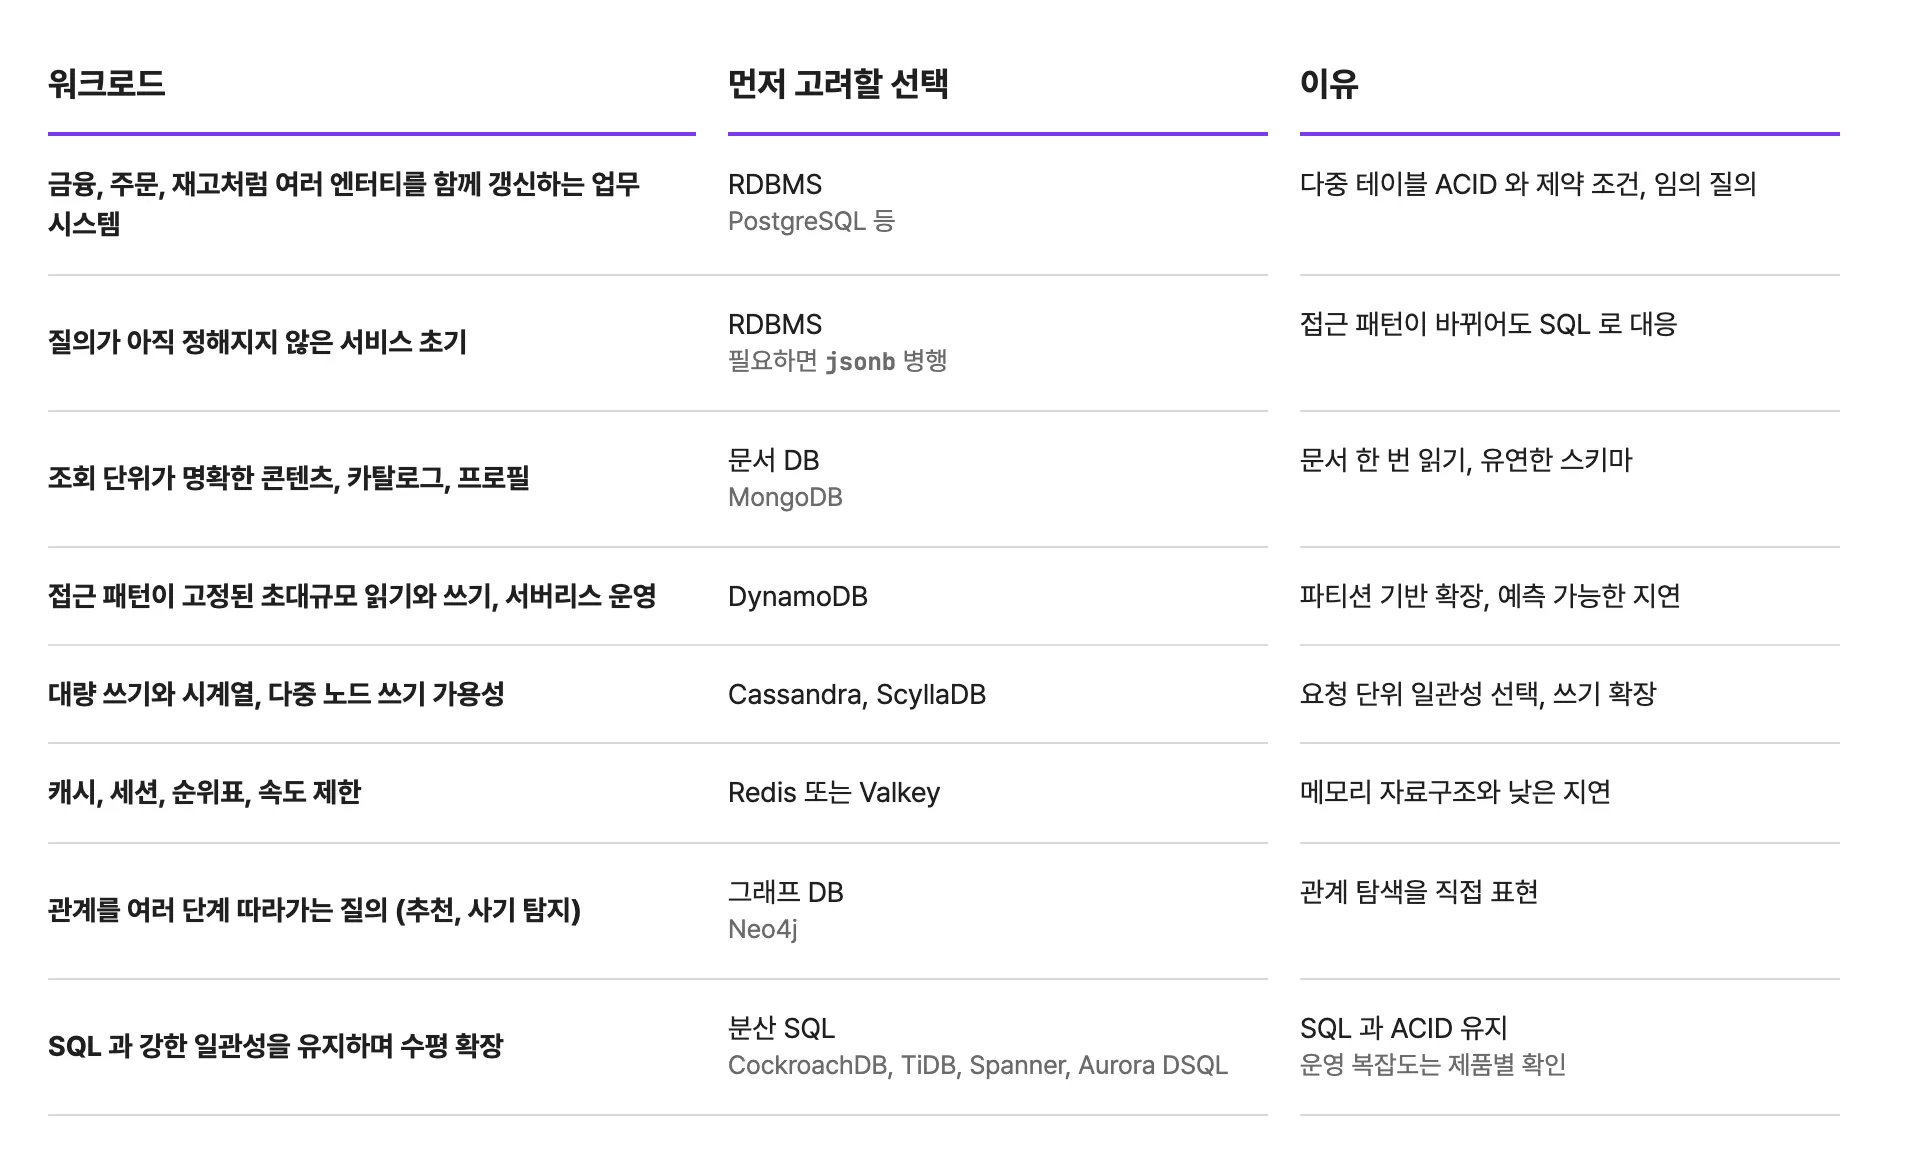
기준을 하나만 꼽으라면 접근 패턴이 얼마나 확정되어 있는가입니다. 질의가 자주 바뀌고 정합성 요구가 강하면 관계형이, 질의가 고정되어 있고 규모가 커서 파티셔닝이 불가피하면 NoSQL 이 유리합니다. 현실의 시스템은 대부분 둘을 같이 씁니다. 원장은 관계형에 두고, 세션과 캐시는 Redis 나 Valkey 에, 검색이나 추천은 별도 저장소에 두는 식입니다. 저장소 사이 동기화를 이벤트로 잇는 경우가 많으니 앞에서 링크한 CQRS 글의 구조가 참고가 될 겁니다.
참고 자료
- Amazon DynamoDB: NoSQL design for DynamoDB
- Amazon DynamoDB: Transactions
- Amazon Aurora DSQL: What is Aurora DSQL
- MongoDB Manual: Transactions
- MongoDB Manual: Schema Validation
- MongoDB Manual: Release Notes
- MongoDB Manual: Release Notes for MongoDB 9.0
- MongoDB Atlas: Vector Search Overview
- Apache Cassandra: Download
- Apache Cassandra: Dynamo
- PostgreSQL: Versioning Policy
- PostgreSQL 18: JSON Types
- pgvector (GitHub)
- Redis: Redis Adopts Dual Source-Available Licensing
- Redis: Redis is now available under the AGPLv3 open source license
- Valkey Blog
- Google Cloud Spanner: TrueTime and external consistency
- CockroachDB: Frequently Asked Questions
- TiDB: Overview