안드로이드 앱을 만들다가 서버 몇 개를 직접 배포하게 되면 컨테이너까지는 금방 익숙해집니다. Dockerfile 을 쓰고 이미지를 올리고 docker run 으로 띄우면 끝이니까요. 문제는 그다음입니다. 서버가 죽으면 누가 다시 띄우는지, 트래픽이 몰리면 몇 대로 늘리는지, 새 버전을 올리는 동안 요청이 끊기지 않게 하려면 어떻게 하는지를 직접 풀어야 합니다. Kubernetes 는 이 질문들에 대한 답을 한 곳에 모아 둔 시스템입니다. 컨테이너 자체를 만드는 법은 Docker 글에 적었고, 이 글은 그 컨테이너를 여러 대 굴릴 때 무슨 일이 벌어지는지를 다룹니다.
오케스트레이션이 해 주는 일
컨테이너 한두 개를 서버 한 대에서 돌릴 때는 오케스트레이터가 필요 없습니다. 서버가 여러 대가 되고 컨테이너가 수십 개가 되면 사람이 하던 판단을 코드로 넘겨야 합니다. Kubernetes 가 맡는 일은 크게 네 가지입니다.
- 스케줄링: 요청한 CPU 와 메모리를 기준으로 어느 노드에 컨테이너를 올릴지 정합니다.
- 자가 복구: 컨테이너가 죽거나 노드가 사라지면 다른 곳에 다시 만듭니다. 헬스 체크에 실패한 컨테이너는 재시작합니다.
- 확장: 복제본 수를 직접 바꾸거나 부하에 따라 자동으로 바꿉니다.
- 롤아웃: 새 버전으로 천천히 교체하고, 문제가 생기면 이전 버전으로 되돌립니다.
서비스 디스커버리와 로드 밸런싱, 설정과 시크릿 주입, 스토리지 연결도 같은 틀 안에서 처리합니다. 서버가 한두 대일 때 shell 스크립트와 systemd 로 하던 일을 선언 하나로 바꿔 주는 셈입니다.
구조: 컨트롤 플레인과 노드
클러스터는 컨트롤 플레인과 워커 노드로 나뉩니다. 공식 문서의 구성 요소 설명을 기준으로 보면 이렇습니다.
| 위치 | 구성 요소 | 하는 일 |
|---|---|---|
| 컨트롤 플레인 | kube-apiserver | Kubernetes HTTP API 를 노출하는 서버. 모든 요청이 여기를 거칩니다 |
| 컨트롤 플레인 | etcd | API 서버가 쓰는 데이터를 담는 일관성 있는 키-값 저장소 |
| 컨트롤 플레인 | kube-scheduler | 아직 노드에 배정되지 않은 Pod 를 적절한 노드에 배정 |
| 컨트롤 플레인 | kube-controller-manager | API 동작을 실제로 구현하는 컨트롤러들을 실행 |
| 노드 | kubelet | Pod 와 그 안의 컨테이너가 실행되고 있도록 보장 |
| 노드 | kube-proxy | Service 를 구현하기 위한 네트워크 규칙을 노드에 유지 (선택 사항) |
| 노드 | 컨테이너 런타임 | 컨테이너를 실제로 실행하는 소프트웨어 |
클라우드 사업자와 연동하는 cloud-controller-manager 도 선택 구성 요소로 있습니다.
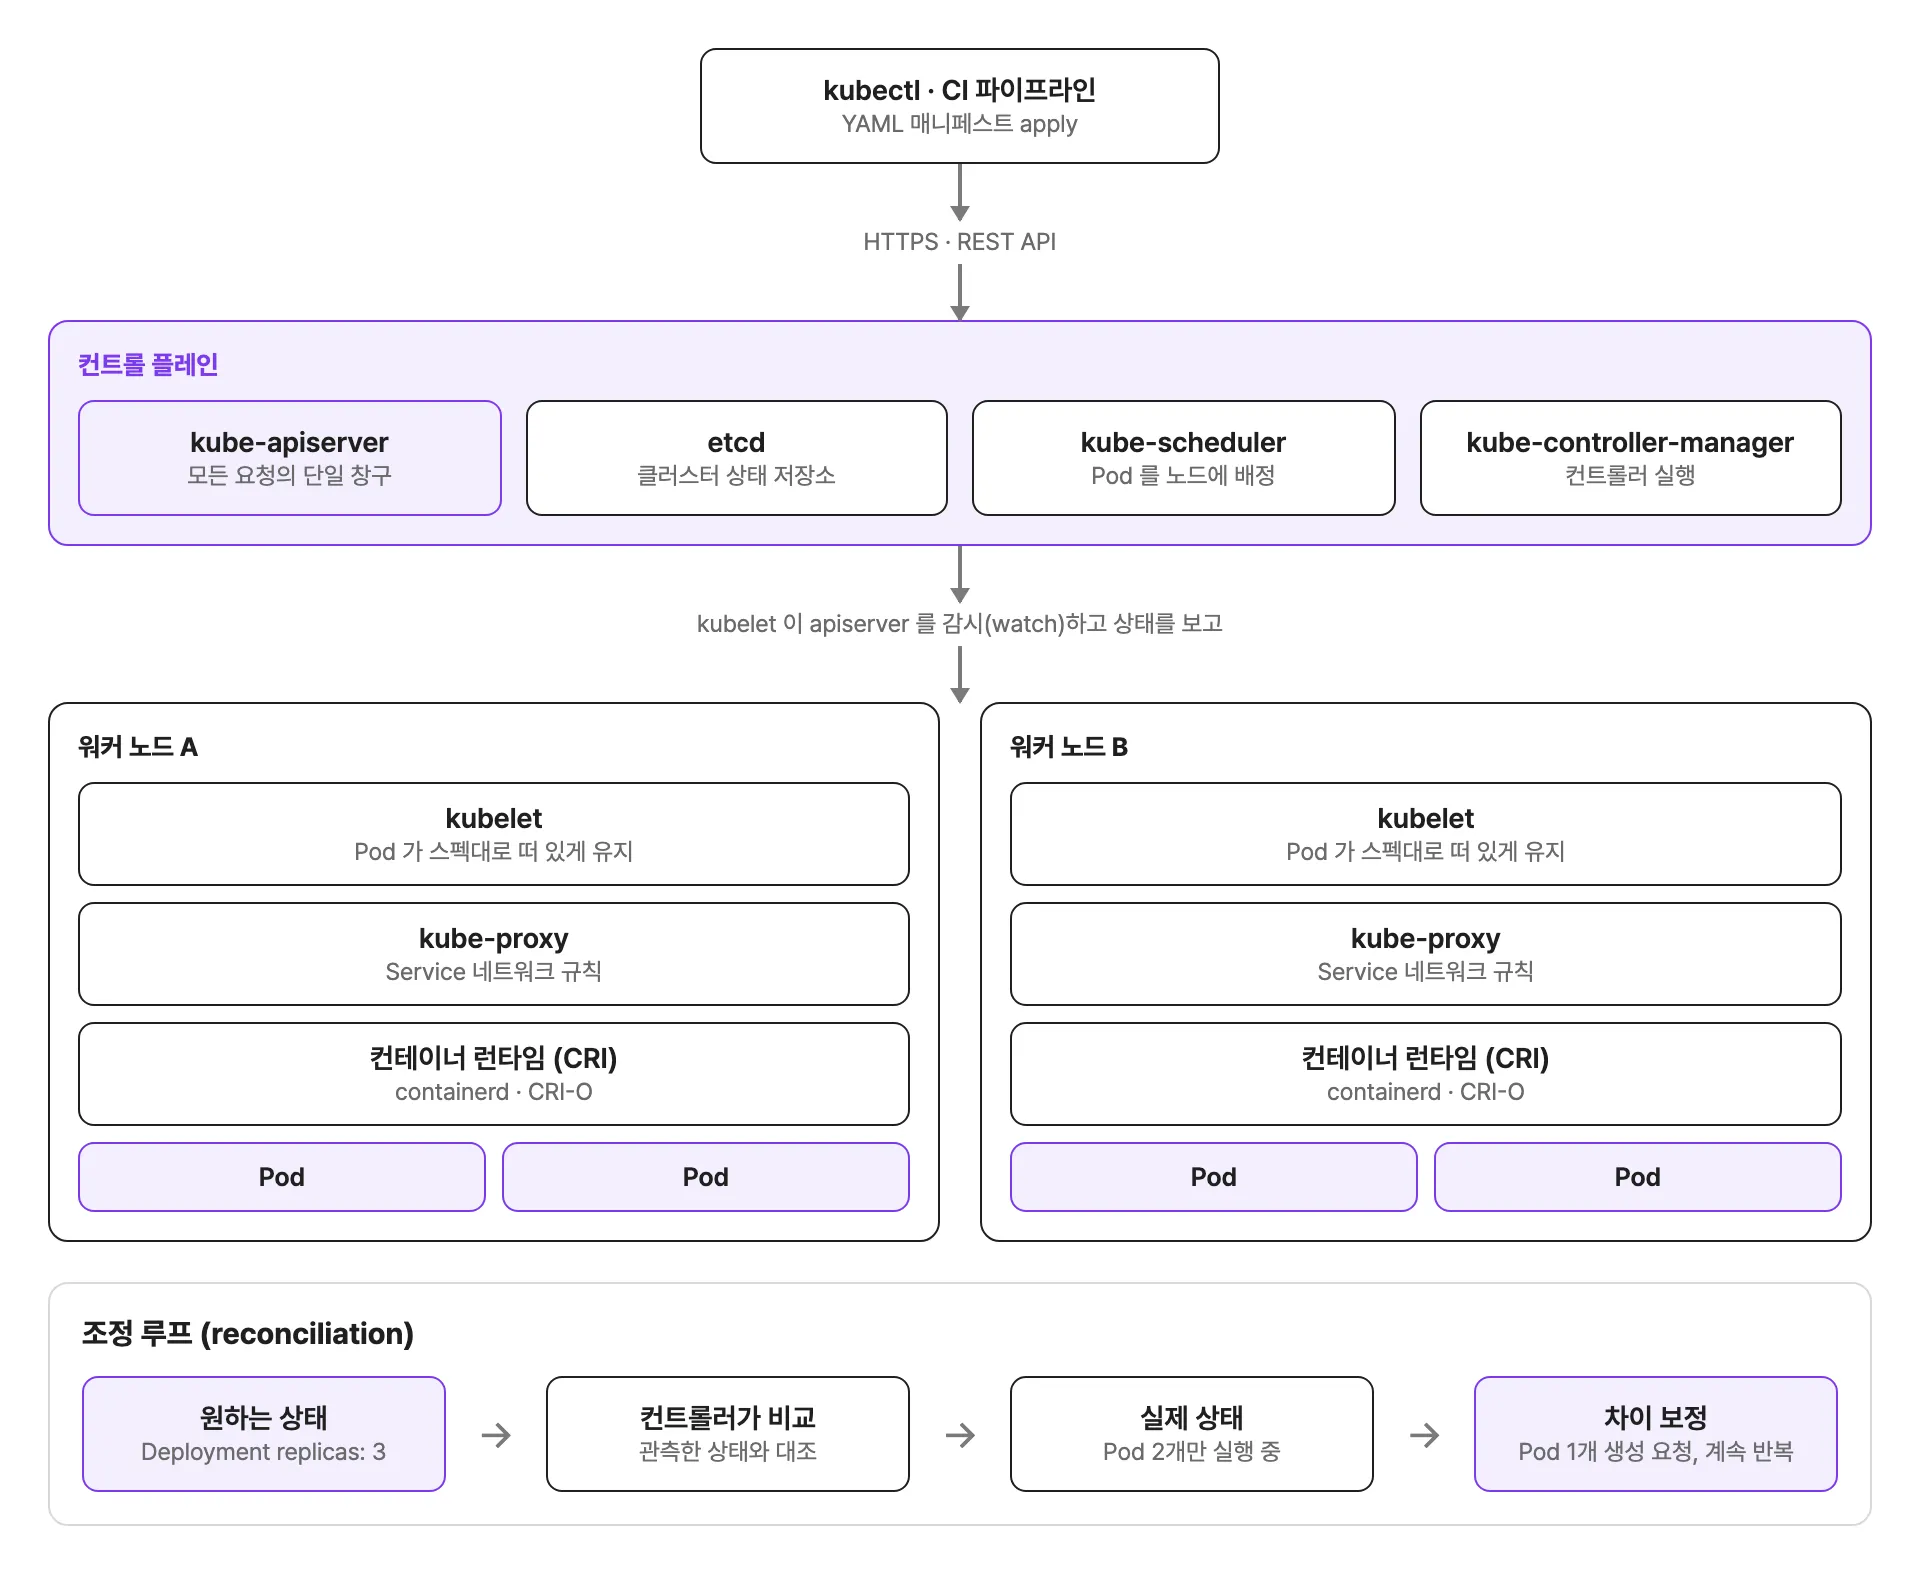
눈여겨볼 점은 컴포넌트끼리 직접 대화하지 않는다는 것입니다. 스케줄러도, kubelet 도, 컨트롤러도 전부 apiserver 하나만 바라보고 etcd 에는 apiserver 만 접근합니다. kubectl apply 를 하면 오브젝트가 apiserver 를 통해 etcd 에 저장되고, 나머지 컴포넌트는 그 변화를 감시하다가 자기 일을 합니다. 스케줄러는 노드가 없는 Pod 를 발견해 배정하고, 배정된 노드의 kubelet 이 이를 보고 컨테이너를 띄웁니다.
컨테이너 런타임과 dockershim
kubelet 은 컨테이너 런타임과 CRI(Container Runtime Interface)로 통신합니다. 그래서 containerd 나 CRI-O 처럼 CRI 를 구현한 런타임이면 무엇이든 꽂을 수 있습니다. 예전에는 kubelet 안에 Docker 를 직접 부르는 dockershim 이라는 어댑터가 들어 있었는데, 이 코드가 1.24 에서 제거되었습니다. 1.24 는 2022년 5월 3일에 나왔습니다.
이 때문에 “이제 Docker 로 만든 이미지는 못 쓰나요” 하는 걱정이 한동안 많았지만, 영향받는 것은 노드의 런타임이지 이미지가 아닙니다. Docker 로 빌드한 이미지는 OCI 이미지라서 containerd 에서도 그대로 돌아갑니다. 노드에 SSH 로 들어가 docker ps 를 치던 습관이 crictl 로 바뀐 정도가 체감되는 차이입니다.
선언형 모델과 조정 루프
Kubernetes 를 쓰면서 가장 먼저 바꿔야 하는 생각은 “명령”이 아니라 “상태”를 적는다는 점입니다. “컨테이너를 세 개 띄워라”가 아니라 “이 앱의 복제본은 세 개여야 한다”를 YAML 로 선언합니다. 그러면 컨트롤러가 현재 상태를 관측하고, 선언과 다르면 차이를 메우는 동작을 끊임없이 반복합니다. 이것이 조정 루프(reconciliation loop)입니다.
복제본이 3으로 선언된 Deployment 에서 Pod 하나가 죽었다고 해 봅시다. 관측한 상태는 2, 원하는 상태는 3이니 컨트롤러가 Pod 를 하나 더 만듭니다. 사람이 장애를 알아채고 대응하는 게 아니라 루프가 알아서 되돌립니다. 반대로 사람이 Pod 를 수동으로 하나 더 만들어도 4개가 되는 순간 컨트롤러가 하나를 지웁니다. 선언한 값이 항상 이긴다는 뜻이라, 수동으로 만진 것은 결국 원래대로 돌아간다는 점을 알고 있어야 합니다.
안드로이드 개발자에게는 Compose 의 상태 기반 UI 와 닮은 점이 많습니다. UI 를 직접 조작하는 대신 상태를 바꾸면 프레임워크가 화면을 맞추듯이, 서버 인프라를 직접 조작하는 대신 선언을 바꾸면 클러스터가 현실을 맞춥니다.
핵심 오브젝트
Pod, ReplicaSet, Deployment
Pod 는 배포의 최소 단위로, 컨테이너 하나 이상과 공유하는 네트워크, 스토리지를 묶은 것입니다. 보통은 컨테이너 하나가 들어갑니다. Pod 는 언제든 죽고 교체되는 일회용으로 보는 게 맞습니다. IP 도 바뀝니다.
Pod 를 직접 만들지는 않고 Deployment 로 만듭니다. 공식 문서 표현대로 Deployment 는 Pod 와 ReplicaSet 에 대한 선언적 업데이트를 제공합니다. Deployment 의 Pod 템플릿을 바꾸면 새 ReplicaSet 이 만들어지고, 새것은 점점 늘리고 이전 것은 점점 줄여 가며 교체합니다. 문서는 Deployment 가 소유한 ReplicaSet 을 직접 건드리지 말라고 경고합니다. 롤백은 이전 ReplicaSet 으로 되돌리는 동작이라서 kubectl rollout undo 한 줄이면 됩니다.
Service
Pod 의 IP 는 바뀌므로 앞단에 고정된 주소가 필요합니다. Service 가 라벨 셀렉터로 Pod 들을 묶고 하나의 안정된 이름과 가상 IP 를 줍니다. 타입은 세 가지를 주로 씁니다.
| 타입 | 노출 범위 | 쓰는 곳 |
|---|---|---|
| ClusterIP | 클러스터 내부 | 기본값. 서비스끼리의 호출 |
| NodePort | 각 노드의 고정 포트 | 테스트나 외부 LB 를 직접 붙일 때 |
| LoadBalancer | 클라우드 로드 밸런서 | 외부에 바로 노출 |
ClusterIP 로 만든 서비스는 클러스터 안에서 서비스이름.네임스페이스 같은 DNS 이름으로 부를 수 있습니다. 앱 설정에 다른 서비스의 주소를 적을 때 이 이름을 씁니다.
Ingress 와 Gateway API
HTTP 요청을 호스트나 경로에 따라 여러 Service 로 나눠 주려면 Ingress 를 써 왔습니다. Ingress 는 1.19 부터 stable 이고, 공식 문서는 지금 이 API 가 동결(frozen)되었다고 밝힙니다. 제거 계획은 없지만 더 이상 개발되지 않으며 새 기능도 들어오지 않고, Kubernetes 프로젝트는 Ingress 대신 Gateway 를 쓰라고 권합니다.
Gateway API 는 그 후속입니다. 인프라 담당이 다루는 GatewayClass 와 Gateway, 앱 개발자가 다루는 HTTPRoute 로 역할을 나눈 구조이고, v1.0 으로 GA 가 된 것이 2023년 10월 31일입니다. 새로 구축한다면 Gateway API 를 먼저 볼 만하지만, 이미 Ingress 로 돌아가는 클러스터를 서둘러 옮길 이유는 없습니다.
ConfigMap 과 Secret
설정은 이미지에 굽지 않고 ConfigMap 으로 분리해 환경 변수나 파일로 주입합니다. 비밀번호나 토큰은 Secret 에 둡니다. 다만 Secret 의 기본 저장 방식은 암호화가 아니라 base64 인코딩이라서, etcd 암호화와 RBAC 로 접근을 좁히지 않으면 보호가 되지 않습니다. 운영에서는 클라우드의 시크릿 매니저와 연동하는 쪽을 많이 씁니다.
StatefulSet, DaemonSet, Job, CronJob
Deployment 의 Pod 는 서로 구분이 안 되는 복제본입니다. 그렇지 않은 경우를 위한 오브젝트들이 따로 있습니다.
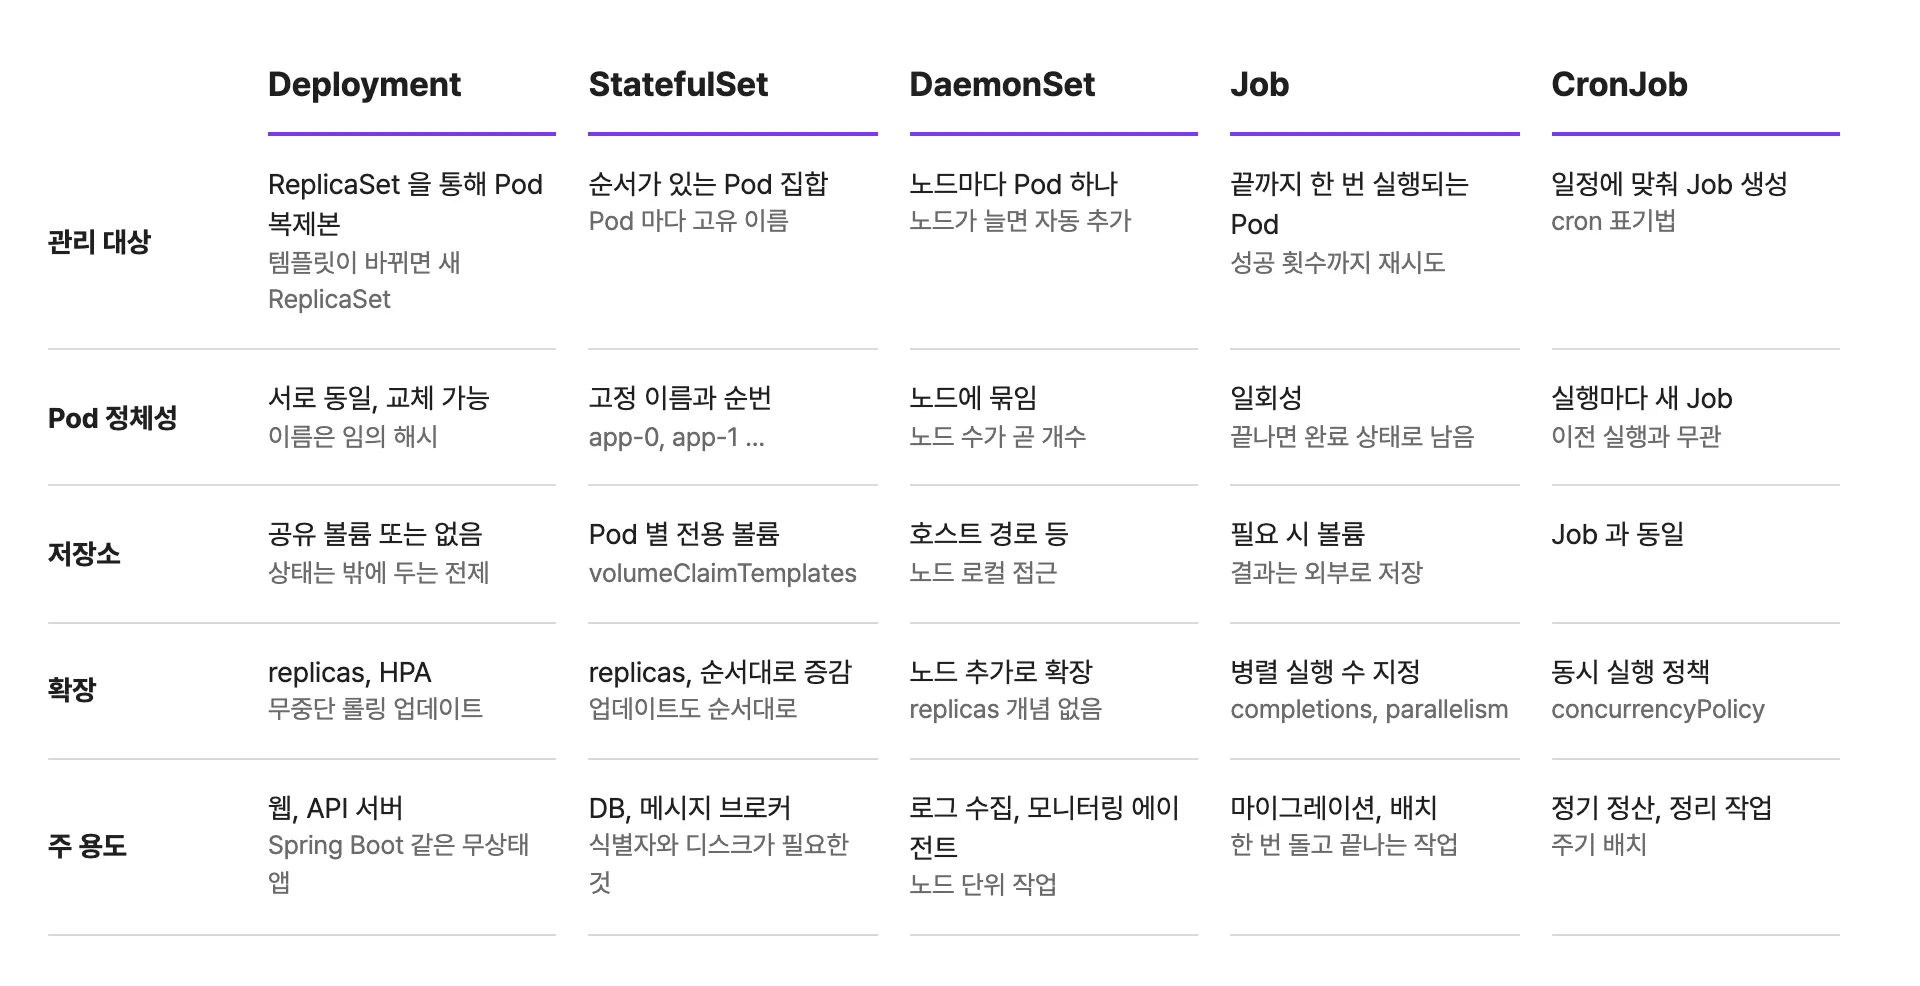
StatefulSet 은 Pod 에 고정된 이름과 순번, Pod 별 전용 볼륨을 줍니다. DB 나 메시지 브로커처럼 정체성이 있는 것에 쓰는데, 솔직히 DB 를 Kubernetes 안에서 직접 운영하는 건 만만치 않습니다. 저는 DB 는 관리형 서비스에 맡기고 클러스터에는 무상태 앱만 올리는 구성을 기본으로 생각합니다. DaemonSet 은 로그 수집기처럼 노드마다 하나씩 떠야 하는 것에, Job 과 CronJob 은 일회성 작업과 주기 배치에 씁니다.
HPA
HorizontalPodAutoscaler 는 지표를 보고 복제본 수를 자동으로 조절합니다. 계산식은 desiredReplicas = ceil[currentReplicas × (현재 지표값 / 목표 지표값)] 입니다. CPU 사용률을 목표로 쓰려면 먼저 두 가지가 맞아야 합니다. 지표를 제공하는 Metrics Server 가 별도로 설치되어 있어야 하고, 컨테이너에 CPU 요청값(requests)이 설정되어 있어야 합니다. 사용률은 요청값 대비 퍼센트로 계산하기 때문에, 요청값이 없는 컨테이너가 있으면 HPA 는 그 지표에 대해 아무 동작도 하지 않습니다. 컨트롤러는 기본적으로 15초 간격으로 지표를 확인합니다.
프로브와 리소스 설정
배포가 무중단이 되려면 앱이 “준비됐는지”를 클러스터가 알아야 합니다. 이를 위한 것이 프로브입니다.
- readiness: 트래픽을 받아도 되는지. 실패하면 Service 의 대상에서 빠지고 컨테이너는 재시작되지 않습니다.
- liveness: 컨테이너가 망가져 재시작이 필요한 상태인지. 실패하면 kubelet 이 컨테이너를 죽이고 다시 띄웁니다.
- startup: 느리게 뜨는 앱을 위한 것. 성공할 때까지 나머지 두 프로브를 미룹니다.
JVM 앱은 기동이 느려서 startup 프로브가 쓸모 있습니다. 이게 없으면 부팅 중인 앱을 liveness 가 죽였다 살리기를 반복하는 상황이 생깁니다. 그리고 liveness 에 DB 연결 같은 외부 의존성 확인을 넣으면 DB 장애 때 모든 Pod 가 한꺼번에 재시작되는 연쇄가 일어나므로, 외부 상태 확인은 readiness 쪽에 둡니다.
리소스는 requests 와 limits 로 지정합니다. requests 는 스케줄러가 노드를 고를 때 쓰는 보장량이고, limits 는 넘으면 안 되는 상한입니다. 메모리가 limit 을 넘으면 컨테이너가 OOMKilled 로 죽습니다. JVM 은 컨테이너의 메모리 제한을 인식해서 힙 크기를 정하지만, 힙 외 메모리까지 있어서 limits.memory 를 힙 크기와 같게 잡으면 죽기 쉽습니다. 여유를 넉넉히 둬야 합니다.
Spring Boot 앱 배포 예제
이미지 registry.example.com/orders-api:1.0.0 이 있다고 하고, Deployment, Service, HPA 를 묶어 보겠습니다. Spring Boot 는 Kubernetes 에서 실행되면 liveness, readiness 상태 프로브를 자동으로 켜 주고, 그렇지 않은 환경에서는 management.endpoint.health.probes.enabled=true 로 켤 수 있습니다. 아래 예제는 그 엔드포인트와 우아한 종료 설정(server.shutdown=graceful)을 전제로 합니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: orders-api
spec:
  replicas: 2
  selector:
    matchLabels:
      app: orders-api
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  template:
    metadata:
      labels:
        app: orders-api
    spec:
      containers:
        - name: app
          image: registry.example.com/orders-api:1.0.0
          ports:
            - containerPort: 8080
          envFrom:
            - configMapRef:
                name: orders-api-config
            - secretRef:
                name: orders-api-secret
          resources:
            requests:
              cpu: 250m
              memory: 512Mi
            limits:
              memory: 768Mi
          startupProbe:
            httpGet:
              path: /actuator/health/liveness
              port: 8080
            periodSeconds: 5
            failureThreshold: 30
          livenessProbe:
            httpGet:
              path: /actuator/health/liveness
              port: 8080
            periodSeconds: 10
          readinessProbe:
            httpGet:
              path: /actuator/health/readiness
              port: 8080
            periodSeconds: 5
---
apiVersion: v1
kind: Service
metadata:
  name: orders-api
spec:
  selector:
    app: orders-api
  ports:
    - port: 80
      targetPort: 8080
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: orders-api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: orders-api
  minReplicas: 2
  maxReplicas: 6
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
maxUnavailable: 0, maxSurge: 1 은 새 Pod 가 ready 가 된 뒤에야 이전 Pod 를 내리라는 설정입니다. 한 대씩 안전하게 교체되는 대신 배포가 조금 느려집니다. startup 프로브는 5초 간격으로 최대 30번, 곧 150초까지 기동을 기다려 줍니다. CPU limit 은 일부러 두지 않았는데, CPU 상한은 JVM 이 기동할 때 스로틀링으로 느려지는 원인이 되기도 해서 requests 만 지정하는 구성을 많이 씁니다. 이건 팀마다 의견이 갈리니 환경에 맞게 정하면 됩니다. HPA 가 70% 를 목표로 삼는 기준이 requests.cpu 의 250m 이므로, 이 값이 실제 사용량과 동떨어지면 확장 시점도 엉뚱해집니다.
적용과 확인은 이렇게 합니다.
kubectl apply -f orders-api.yaml
kubectl rollout status deployment/orders-api
kubectl get pods -l app=orders-api
kubectl rollout undo deployment/orders-api
네임스페이스와 RBAC
네임스페이스는 클러스터 하나를 논리적으로 나누는 단위입니다. 환경(dev, staging)이나 팀별로 나누고, 이름 충돌을 피하고, 리소스 쿼터를 걸 때 씁니다. 같은 클러스터를 여러 팀이 쓰면 접근 통제가 필요한데, 이는 RBAC 로 합니다. Role 이 “어떤 리소스에 어떤 동작을 허용하는지”를 정의하고, RoleBinding 이 그 권한을 사용자나 ServiceAccount 에 연결합니다. CI 가 배포에 쓰는 계정에는 해당 네임스페이스의 Deployment 갱신 권한만 주는 식으로 최소 권한을 지키는 것이 기본입니다. 네임스페이스는 보안 경계라기보다 관리 경계에 가깝다는 점도 알아 두셔야 합니다. 네트워크 격리는 NetworkPolicy 를 따로 걸어야 합니다.
관리형 서비스
컨트롤 플레인을 직접 설치하고 업그레이드하는 일은 사실상 피하는 게 현실적입니다. 클라우드 3사가 모두 관리형을 제공합니다. AWS 는 EKS, Azure 는 AKS, Google Cloud 는 GKE 입니다. 컨트롤 플레인 운영은 사업자가 맡고 사용자는 워커 노드와 워크로드를 다룹니다.
GKE 에는 Autopilot 모드가 있어 노드와 인프라 관리까지 Google 이 맡습니다. 일반 워크로드는 노드가 아니라 Pod 단위로 과금하는 방식이라, 노드 크기와 개수를 고민하는 부담이 줄어듭니다.
Kubernetes 가 과한 경우
솔직히 서비스가 두세 개이고 팀이 작다면 Kubernetes 는 과합니다. 클러스터 업그레이드, 애드온 관리, 네트워크와 보안 설정, 장애 때 읽어야 하는 YAML 과 이벤트까지 운영 지식이 꽤 필요합니다. 이 비용을 감수할 만큼 얻는 게 있어야 합니다.
- 컨테이너 하나를 올리고 HTTPS 만 붙이면 되는 서비스는 Cloud Run, Azure Container Apps, Heroku 류의 PaaS 로 충분합니다.
- AWS 에 머문다면 ECS 가 훨씬 단순합니다. 오케스트레이션의 핵심 기능은 대부분 갖고 있습니다.
- 서비스가 많고, 팀이 여럿이고, 배포 패턴이 다양하고, 멀티 클라우드나 온프레미스 이식성이 필요하면 그때 Kubernetes 가 값을 합니다.
서비스를 나누는 것 자체가 먼저 필요한지는 모놀리스와 마이크로서비스 글에서 다뤘습니다. 서비스가 하나뿐인데 Kubernetes 부터 도입하는 건 순서가 뒤집힌 겁니다.
릴리스 주기와 버전
Kubernetes 는 SemVer(x.y.z)를 따르고, 릴리스 브랜치는 가장 최근 minor 세 개에 대해 유지됩니다. 1.19 이후 버전은 대략 1년 동안 패치를 받습니다. 지원 중인 버전은 이렇습니다.
| minor | 최신 패치 | 지원 종료 |
|---|---|---|
| 1.37 | 1.37.1 (2026-09-15) | 2027-10-28 |
| 1.36 | 1.36.5 (2026-09-15) | 2027-06-28 |
| 1.35 | 1.35.9 (2026-09-15) | 2027-02-28 |
| 1.34 | 1.34.12 (2026-09-15) | 2026-10-27 |
가장 최신 minor 는 1.37 입니다. 지원 기간이 1년 남짓이라 직접 운영하는 클러스터는 업그레이드를 꾸준히 따라가야 하고, 이 부담도 관리형을 고르는 이유가 됩니다. 관리형 서비스도 사업자가 지원하는 버전 목록이 따로 있으므로 사용하는 서비스의 문서를 확인해야 합니다.
참고 자료
- Kubernetes: Releases
- Kubernetes: Cluster Architecture / Components
- Kubernetes: Ingress
- Kubernetes Blog: Gateway API v1.0 GA
- Kubernetes Blog: Dockershim Removal FAQ
- Kubernetes Blog: Kubernetes v1.24 Release Announcement
- Kubernetes: Deployments
- Kubernetes: Horizontal Pod Autoscaling
- Kubernetes: Configure Liveness, Readiness and Startup Probes
- Google Kubernetes Engine: Autopilot overview