Kafka 를 처음 만나면 “메시지 큐의 빠른 버전” 정도로 이해하기 쉽습니다. 저도 그랬고, 그 이해로 설정을 만지다가 컨슈머를 늘려도 처리량이 그대로인 상황을 한 번 겪었습니다. 큐처럼 보이는 것은 겉모습일 뿐이고, 안쪽은 디스크에 쌓이는 append-only 로그입니다. 이 글은 그 로그가 파티션으로 쪼개지고, 복제되고, 컨슈머 그룹이 나눠 읽는 과정을 순서대로 짚고, Kotlin 으로 프로듀서와 컨슈머를 짜 본 뒤 RabbitMQ 나 SQS 대신 Kafka 를 쓸 이유가 있는지까지 적었습니다.
버전부터 정리해 두면 이후 설명이 편합니다. ZooKeeper 모드는 Kafka 4.0 에서 제거되어 KRaft 만 남았고, 4.0.0 은 2025년 3월 18일에 나왔습니다. 가장 최근 릴리스는 2026년 10월 22일의 4.4.0 입니다. 이벤트를 상태 대신 저장하는 발상 자체가 궁금하다면 CQRS 와 이벤트 소싱 글을 먼저 보셔도 좋습니다. Kafka 가 그 발상의 인프라 쪽 구현으로 자주 쓰입니다.
로그, 토픽, 파티션, offset
Kafka 의 기본 단위는 토픽(topic) 이고, 토픽은 하나 이상의 파티션(partition) 으로 나뉩니다. 파티션 하나가 곧 순서가 있는 로그 하나입니다. 레코드가 들어오면 파티션 맨 끝에 붙고, 파티션 안에서 0, 1, 2 순으로 증가하는 번호인 offset 을 받습니다. 읽는 쪽은 “나는 offset 41 까지 읽었다”를 기억할 뿐이고, 읽었다고 레코드가 사라지지 않습니다.
여기서 두 가지 성질이 따라옵니다. 순서는 파티션 안에서만 보장되고, 파티션끼리는 순서가 없습니다. 그리고 같은 데이터를 여러 소비자가 각자의 속도로 읽거나, offset 을 뒤로 돌려 다시 읽을 수 있습니다.
디스크에서는 파티션이 세그먼트 파일의 연속입니다. 활성 세그먼트가 segment.bytes(기본 1 GiB)에 닿으면 새 세그먼트로 넘어가고, 오래된 세그먼트는 파일 단위로 지워집니다. 보존 정책은 두 갈래입니다.
| 정책 | 설정 | 동작 |
|---|---|---|
| delete | cleanup.policy=delete(기본) | retention.ms(기본 7일)나 retention.bytes(기본 제한 없음)를 넘긴 세그먼트 삭제 |
| compact | cleanup.policy=compact | key 마다 최소한 마지막 값은 남김, null 값은 삭제 표시(tombstone) |
compaction 은 offset 을 바꾸거나 순서를 섞지 않습니다. “사용자 프로필의 최신 상태”처럼 key 별 최신값만 의미 있는 토픽에 어울립니다. 컨슈머가 다시 시작해도 최신 상태를 처음부터 복원할 수 있기 때문입니다.
프로듀서: key, acks, 멱등성, 배치
프로듀서가 레코드에 key 를 주면 key 의 해시로 파티션이 정해집니다. 같은 key 는 같은 파티션으로 가므로 “사용자 한 명의 이벤트는 순서대로”가 이 방식으로 보장됩니다. key 가 없으면 파티션이 알아서 분산됩니다. 파티션 수를 나중에 늘리면 key 와 파티션의 대응이 바뀌므로, 순서가 중요한 토픽은 처음부터 여유 있게 잡는 편이 낫습니다.
acks 는 “누가 받아야 성공으로 칠 것인가”입니다.
acks=0: 기다리지 않습니다. 보내고 잊습니다.acks=1: leader 가 자기 로그에 쓰면 성공입니다. leader 가 복제 직전에 죽으면 그 레코드는 사라질 수 있습니다.acks=all: ISR 의 복제본이 모두 받아야 성공입니다. 현재 클라이언트의 기본값이 이쪽입니다.
enable.idempotence 도 기본이 true 입니다. 브로커가 프로듀서마다 ID 를 주고 시퀀스 번호로 중복을 걸러내므로, 재시도가 일어나도 같은 레코드가 두 번 쌓이지 않습니다. 이 옵션은 acks=all, retries > 0, max.in.flight.requests.per.connection ≤ 5 를 요구하고, 이 조건과 충돌하는 값을 명시적으로 켜 두면 ConfigException 이 납니다.
처리량은 배치가 좌우합니다. 프로듀서는 파티션별로 레코드를 모아 보내는데, batch.size(기본 16 KB)가 차거나 linger.ms(기본 5 ms)가 지나면 내보냅니다. linger 를 키우면 요청 수가 줄고 처리량이 늘지만 지연이 그만큼 붙습니다. 실패 처리는 retries 횟수를 만지기보다 delivery.timeout.ms(기본 2분)로 상한을 두는 쪽이 문서의 권장입니다.
컨슈머 그룹과 리밸런싱
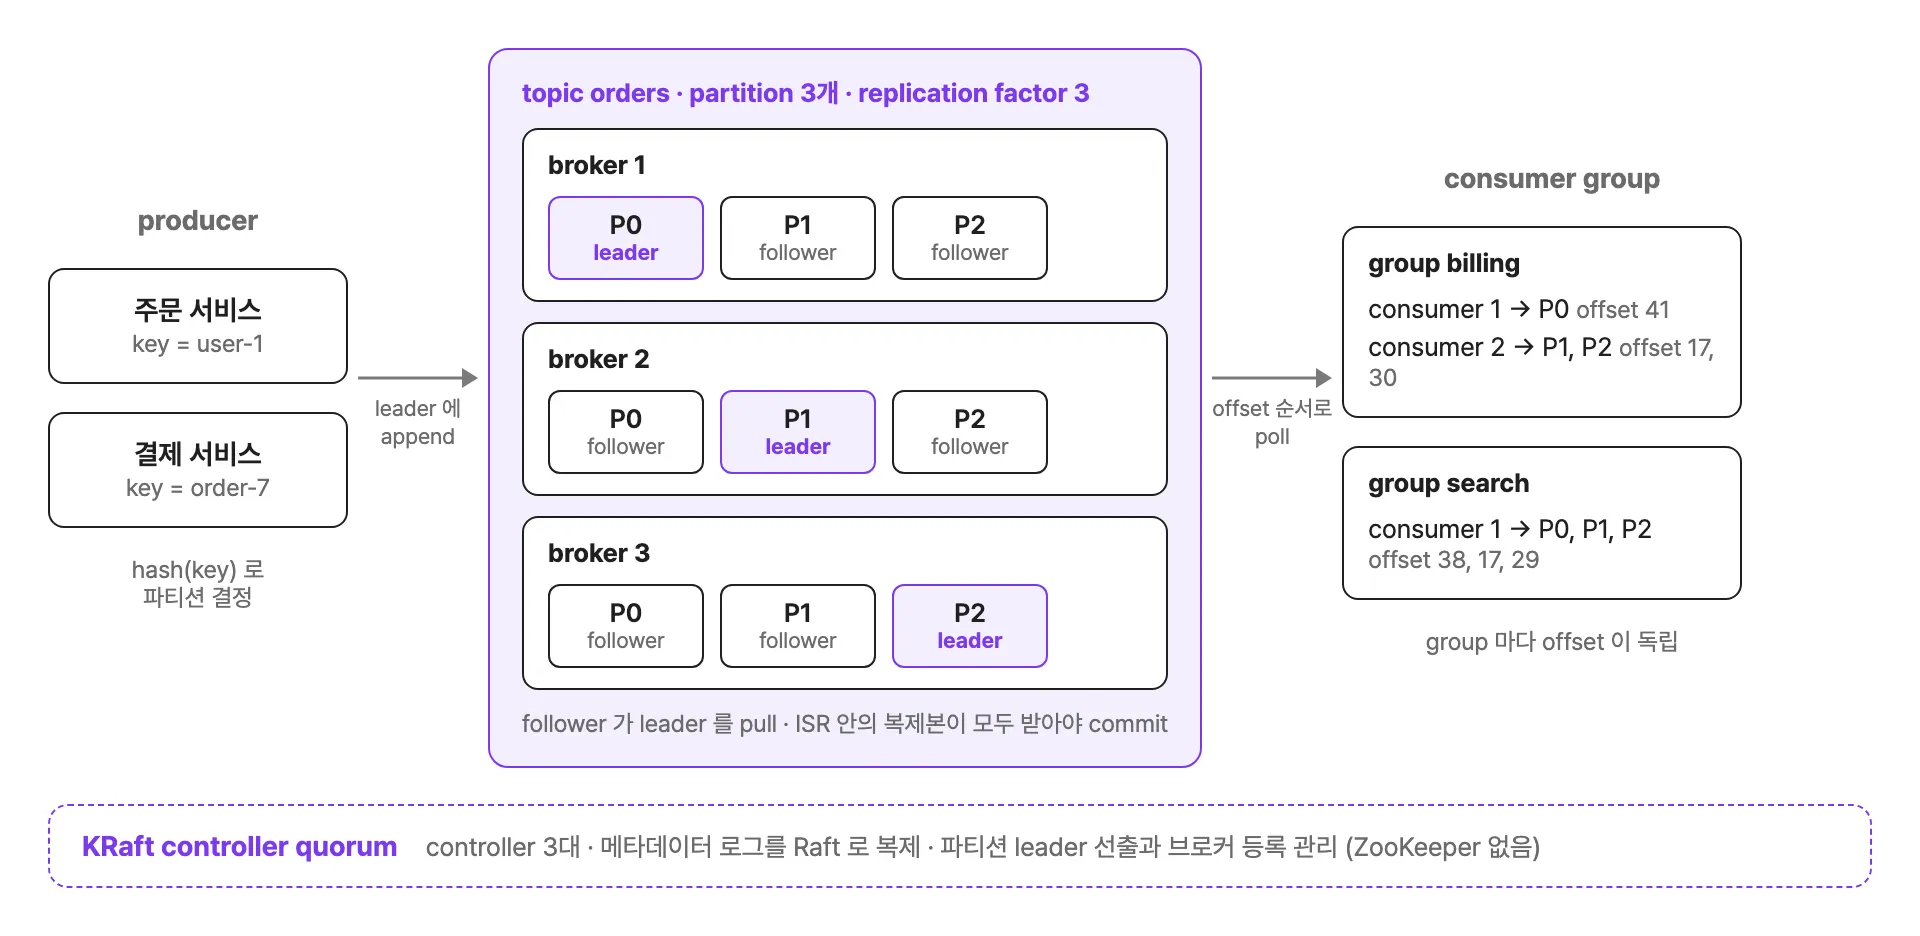
같은 group.id 를 가진 컨슈머들이 한 그룹이 되어 파티션을 나눠 맡습니다. 파티션 하나는 그룹 안에서 컨슈머 한 명에게만 할당됩니다. 그래서 파티션이 3개인 토픽에 컨슈머를 5명 붙이면 2명은 놉니다. 병렬도의 상한이 파티션 수라는 이야기이고, 앞에서 말한 “컨슈머를 늘려도 그대로”의 원인이 이것이었습니다. 반대로 다른 그룹은 같은 토픽을 완전히 독립적으로 읽습니다. 그림의 billing 과 search 처럼 offset 도 그룹별로 따로 기록됩니다.
컨슈머가 합류하거나 죽으면 파티션을 다시 나누는 리밸런싱이 일어납니다. 클래식 프로토콜에서는 리밸런싱 동안 그룹 전체가 멈추는 구간이 있어 운영에서 가장 골치 아픈 부분이었습니다. 이를 줄이는 길이 두 가지 있습니다.
- 클라이언트의
partition.assignment.strategy기본값에 들어 있는CooperativeStickyAssignor로, 바뀌지 않는 파티션은 그대로 둔 채 옮길 것만 옮기는 방식 - KIP-848 의 새 컨슈머 그룹 프로토콜. 할당 계산을 브로커의 그룹 코디네이터가 맡고 하트비트 기반으로 증분 진행되며, 4.0 에서 GA 가 되었습니다.
브로커 쪽은 4.0 부터 기본으로 켜져 있지만 클라이언트는 group.protocol=consumer 로 직접 선택해야 합니다(기본은 classic). 이 프로토콜에서는 session.timeout.ms 와 partition.assignment.strategy 를 클라이언트가 정하지 않고, 할당기는 서버의 uniform 이나 range 중에서 group.remote.assignor 로 고릅니다. 클라이언트 쪽 커스텀 할당기는 아직 지원되지 않습니다.
offset 커밋은 기본이 enable.auto.commit=true 로 5초마다 자동입니다. 처리 도중 죽으면 이미 커밋된 offset 때문에 레코드를 놓치거나, 처리는 했는데 커밋 전에 죽어서 다시 받습니다. 중요한 처리라면 자동 커밋을 끄고 처리 후에 직접 커밋합니다. auto.offset.reset 은 커밋된 offset 이 없을 때의 시작 위치이고 기본이 latest 라서, 새 그룹이 과거 데이터를 읽고 싶다면 earliest 로 바꿔야 합니다.
복제: leader, follower, ISR
파티션마다 leader 하나와 follower 들이 있습니다. 읽기와 쓰기는 모두 leader 로 가고, follower 는 leader 를 pull 해서 같은 로그를 따라갑니다. ISR(in-sync replicas) 은 leader 를 충분히 따라오고 있는 복제본의 집합이고, replica.lag.time.max.ms 를 넘겨 뒤처진 복제본은 ISR 에서 빠집니다. ISR 의 복제본이 모두 받아야 레코드가 commit 되고, 그때부터 컨슈머에게 보입니다.
여기서 min.insync.replicas(토픽 기본 1)가 안전망 역할을 합니다. acks=all 쓰기는 ISR 크기가 이 값 이상일 때만 성공하고, 모자라면 거절됩니다. replication factor 3 에 min.insync.replicas=2 로 두면 브로커 한 대가 죽어도 쓰기가 계속되고, 두 대가 죽으면 쓰기를 멈추는 대신 유실도 막습니다. 이 조합은 가용성보다 일관성을 고르는 선택입니다. leader 가 죽으면 컨트롤러가 ISR 안에서 새 leader 를 뽑고, ISR 밖의 복제본을 뽑는 unclean election 은 unclean.leader.election.enable 로 기본 꺼져 있습니다.
전달 보장과 트랜잭션
Kafka 문서는 전달 보장을 세 가지로 나눕니다.
| 보장 | 의미 | 구성 |
|---|---|---|
| at-most-once | 유실될 수 있고 중복은 없음 | 재시도 없음, 처리 전에 offset 커밋 |
| at-least-once | 유실은 없고 중복될 수 있음 | 처리 후에 offset 커밋 (기본 성향) |
| exactly-once | 정확히 한 번 처리 | 멱등 프로듀서 + 트랜잭션, 컨슈머는 read_committed |
exactly-once 는 “읽고, 처리하고, 다른 토픽에 쓰고, offset 을 커밋”하는 흐름을 하나의 트랜잭션으로 묶어서 얻습니다. 프로듀서에 transactional.id 를 주고, 컨슈머는 isolation.level=read_committed(기본은 read_uncommitted)와 enable.auto.commit=false 로 둡니다. 이 보장의 범위는 Kafka 안에서 일어나는 읽기-처리-쓰기입니다. 처리 중에 외부 DB 를 갱신하거나 HTTP 를 호출하면 그 부분은 트랜잭션 밖입니다. 외부 시스템에는 멱등한 쓰기를 설계하거나, 아웃박스 패턴처럼 다른 방법이 필요합니다.
KRaft, 그리고 ZooKeeper 의 퇴장
예전 Kafka 는 메타데이터와 컨트롤러 선출을 ZooKeeper 에 맡겨서 클러스터 둘을 함께 운영해야 했습니다. 지금은 KRaft 가 그 자리를 대신합니다. 메타데이터를 Kafka 자신의 로그에 Raft 로 복제하는 구조이고, 4.0 은 KRaft 만 지원합니다. ZooKeeper 모드 클러스터는 4.0 으로 올리기 전에 KRaft 로 먼저 옮겨야 합니다.
구성은 노드마다 process.roles 로 정합니다. broker, controller, 둘 다(broker,controller, combined 모드) 중 하나이고, combined 는 개발용으로는 편하지만 중요한 운영 환경에는 권하지 않습니다. 컨트롤러는 운영에서 3대나 5대로 두고, 3대면 1대, 5대면 2대의 장애를 견딥니다. 스토리지는 자동으로 포맷되지 않으므로 직접 해야 합니다.
KAFKA_CLUSTER_ID=$(bin/kafka-storage.sh random-uuid)
# 단일 노드 개발 환경
bin/kafka-storage.sh format --standalone -t $KAFKA_CLUSTER_ID -c config/server.properties
bin/kafka-server-start.sh config/server.properties
CLI 로 먼저 만져 보기
코드를 짜기 전에 CLI 로 토픽 구조를 눈으로 보면 이해가 빠릅니다. 로컬에서는 Docker 로 브로커를 띄우는 방법이 가장 간단합니다.
# 파티션 3개, 복제 계수 3, min.insync.replicas=2 인 토픽
bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic orders \
  --partitions 3 --replication-factor 3 --config min.insync.replicas=2

# leader, replicas, isr 확인
bin/kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic orders

# key 를 붙여 보내기 (user-1:created 형식)
bin/kafka-console-producer.sh --bootstrap-server localhost:9092 --topic orders \
  --property parse.key=true --property key.separator=:

# 그룹으로 읽기, 처음부터
bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic orders \
  --group billing --from-beginning

# 그룹의 offset 과 lag 확인
bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group billing
--describe 출력의 Leader, Replicas, Isr 세 열이 앞의 그림과 그대로 대응합니다. kafka-consumer-groups.sh 의 LAG 열은 “로그 끝 offset 에서 커밋된 offset 을 뺀 값”으로, 컨슈머가 밀리고 있는지 보는 가장 먼저 볼 지표입니다.
Kotlin 프로듀서와 컨슈머
의존성은 org.apache.kafka:kafka-clients 하나로 충분합니다.
// build.gradle.kts
dependencies {
    implementation("org.apache.kafka:kafka-clients:4.4.0")
}
프로듀서는 직렬화기와 부트스트랩 주소만 주면 되고 acks=all 과 멱등성은 이미 기본입니다. 중요한 건 key 를 정하는 것과 전송 결과를 확인하는 것입니다.
import org.apache.kafka.clients.producer.KafkaProducer
import org.apache.kafka.clients.producer.ProducerConfig
import org.apache.kafka.clients.producer.ProducerRecord
import org.apache.kafka.common.serialization.StringSerializer
import java.util.Properties

fun createProducer(): KafkaProducer<String, String> {
    val props = Properties().apply {
        put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092")
        put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer::class.java.name)
        put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer::class.java.name)
        put(ProducerConfig.LINGER_MS_CONFIG, 20)
    }
    return KafkaProducer(props)
}

fun main() {
    createProducer().use { producer ->
        val record = ProducerRecord("orders", "user-1", """{"orderId":1001,"status":"CREATED"}""")
        producer.send(record) { metadata, error ->
            if (error != null) {
                System.err.println("전송 실패: ${error.message}")
            } else {
                println("partition=${metadata.partition()} offset=${metadata.offset()}")
            }
        }
    }
}
use 블록이 끝날 때 close() 가 대기 중인 배치를 비우므로, 콜백이 불리기 전에 프로세스가 끝나는 일은 없습니다. 콜백은 프로듀서의 I/O 스레드에서 실행되니 무거운 작업을 넣으면 안 됩니다.
컨슈머는 자동 커밋을 끄고 처리가 끝난 뒤에 커밋하는 형태로 짰습니다. at-least-once 의 전형입니다.
import org.apache.kafka.clients.consumer.ConsumerConfig
import org.apache.kafka.clients.consumer.KafkaConsumer
import org.apache.kafka.common.serialization.StringDeserializer
import java.time.Duration
import java.util.Properties

fun main() {
    val props = Properties().apply {
        put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092")
        put(ConsumerConfig.GROUP_ID_CONFIG, "billing")
        put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer::class.java.name)
        put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer::class.java.name)
        put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false)
        put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest")
    }
    KafkaConsumer<String, String>(props).use { consumer ->
        consumer.subscribe(listOf("orders"))
        while (true) {
            val records = consumer.poll(Duration.ofMillis(500))
            for (record in records) {
                println("p=${record.partition()} o=${record.offset()} key=${record.key()} value=${record.value()}")
            }
            if (!records.isEmpty) consumer.commitSync()
        }
    }
}
새 프로토콜을 쓰고 싶다면 put(ConsumerConfig.GROUP_PROTOCOL_CONFIG, "consumer") 한 줄을 더하면 됩니다. poll 간격이 max.poll.interval.ms(기본 5분)를 넘기면 그 컨슈머는 죽은 것으로 간주되어 리밸런싱이 일어나므로, 처리가 오래 걸리는 작업을 poll 루프 안에 그대로 두는 건 위험합니다.
읽고 쓰는 흐름을 트랜잭션으로 묶는 경우의 뼈대는 다음과 같습니다. 컨슈머는 read_committed, 자동 커밋 끔으로 만들어 둔 상태를 가정했습니다.
import org.apache.kafka.clients.consumer.OffsetAndMetadata
import org.apache.kafka.common.TopicPartition

fun consumeTransformProduce(
    consumer: KafkaConsumer<String, String>,
    producer: KafkaProducer<String, String>, // transactional.id 지정
) {
    producer.initTransactions()
    consumer.subscribe(listOf("orders"))
    while (true) {
        val records = consumer.poll(Duration.ofMillis(500))
        if (records.isEmpty) continue
        producer.beginTransaction()
        try {
            val offsets = mutableMapOf<TopicPartition, OffsetAndMetadata>()
            for (r in records) {
                producer.send(ProducerRecord("invoices", r.key(), r.value().uppercase()))
                offsets[TopicPartition(r.topic(), r.partition())] = OffsetAndMetadata(r.offset() + 1)
            }
            producer.sendOffsetsToTransaction(offsets, consumer.groupMetadata())
            producer.commitTransaction()
        } catch (e: Exception) {
            producer.abortTransaction()
            throw e
        }
    }
}
offset 커밋이 sendOffsetsToTransaction 으로 출력 레코드와 같은 트랜잭션에 들어가는 점이 핵심입니다. 둘이 함께 확정되거나 함께 취소되기 때문에 중복 출력이 생기지 않습니다. 운영 코드라면 ProducerFencedException 같은 복구 불가능한 예외는 abort 가 아니라 프로듀서를 닫는 쪽으로 따로 다뤄야 합니다.
Streams, Connect, 그리고 큐가 된 Kafka
Kafka 는 클라이언트 라이브러리 위에 두 가지 도구를 얹어 둡니다. Kafka Streams 는 토픽을 읽어 집계, 조인, 윈도우 연산을 하는 라이브러리이고 별도 클러스터 없이 애플리케이션 안에서 돕니다. Kafka Connect 는 DB 나 객체 스토리지 같은 외부 시스템과 토픽 사이의 입출력을 코드 없이 설정으로 잇는 프레임워크입니다. 보통 “DB 변경분을 토픽으로, 토픽을 검색 엔진으로”라는 파이프라인을 이 둘로 만듭니다.
그리고 최근에 눈에 띄는 변화가 KIP-932 의 share group, 이른바 Queues for Kafka 입니다. 컨슈머 그룹에서는 파티션 하나를 컨슈머 한 명이 독점했지만, share group 에서는 여러 컨슈머가 같은 파티션의 레코드를 함께 처리하고 레코드 단위로 ack 합니다. 컨슈머가 파티션보다 많아도 되고, 레코드마다 전달 횟수를 세어 처리 못 하는 레코드를 따로 다룰 수 있습니다. 4.1 에서 프리뷰로 들어왔고 4.2(2026년 2월 17일 릴리스)에서 production-ready 가 되었습니다. 4.2 에는 처리 시간이 긴 레코드의 잠금을 연장하는 RENEW ack 타입도 함께 들어갔습니다. “작업 큐가 필요해서 Kafka 말고 별도 큐를 하나 더 운영한다”는 이유가 약해진 셈입니다. 다만 share group 은 순서 보장을 포기하는 대신 병렬도를 얻는 모델이라, 파티션 순서가 필요한 곳에는 여전히 컨슈머 그룹을 씁니다.
RabbitMQ, SQS 와 무엇이 다른가
가장 큰 차이는 “읽은 메시지가 어떻게 되는가”입니다. RabbitMQ 의 클래식 큐는 소비하고 ack 하면 메시지가 사라지는 destructive 모델입니다. SQS 도 receive 한 메시지를 처리한 뒤 delete 하는 방식입니다. Kafka 는 읽어도 남아 있고 retention 이 지나서야 지워집니다. 그래서 재처리와 다수 구독자가 자연스럽게 됩니다. RabbitMQ 에도 로그 모델의 stream 타입이 있어서 이 경계가 예전만큼 선명하지는 않습니다.
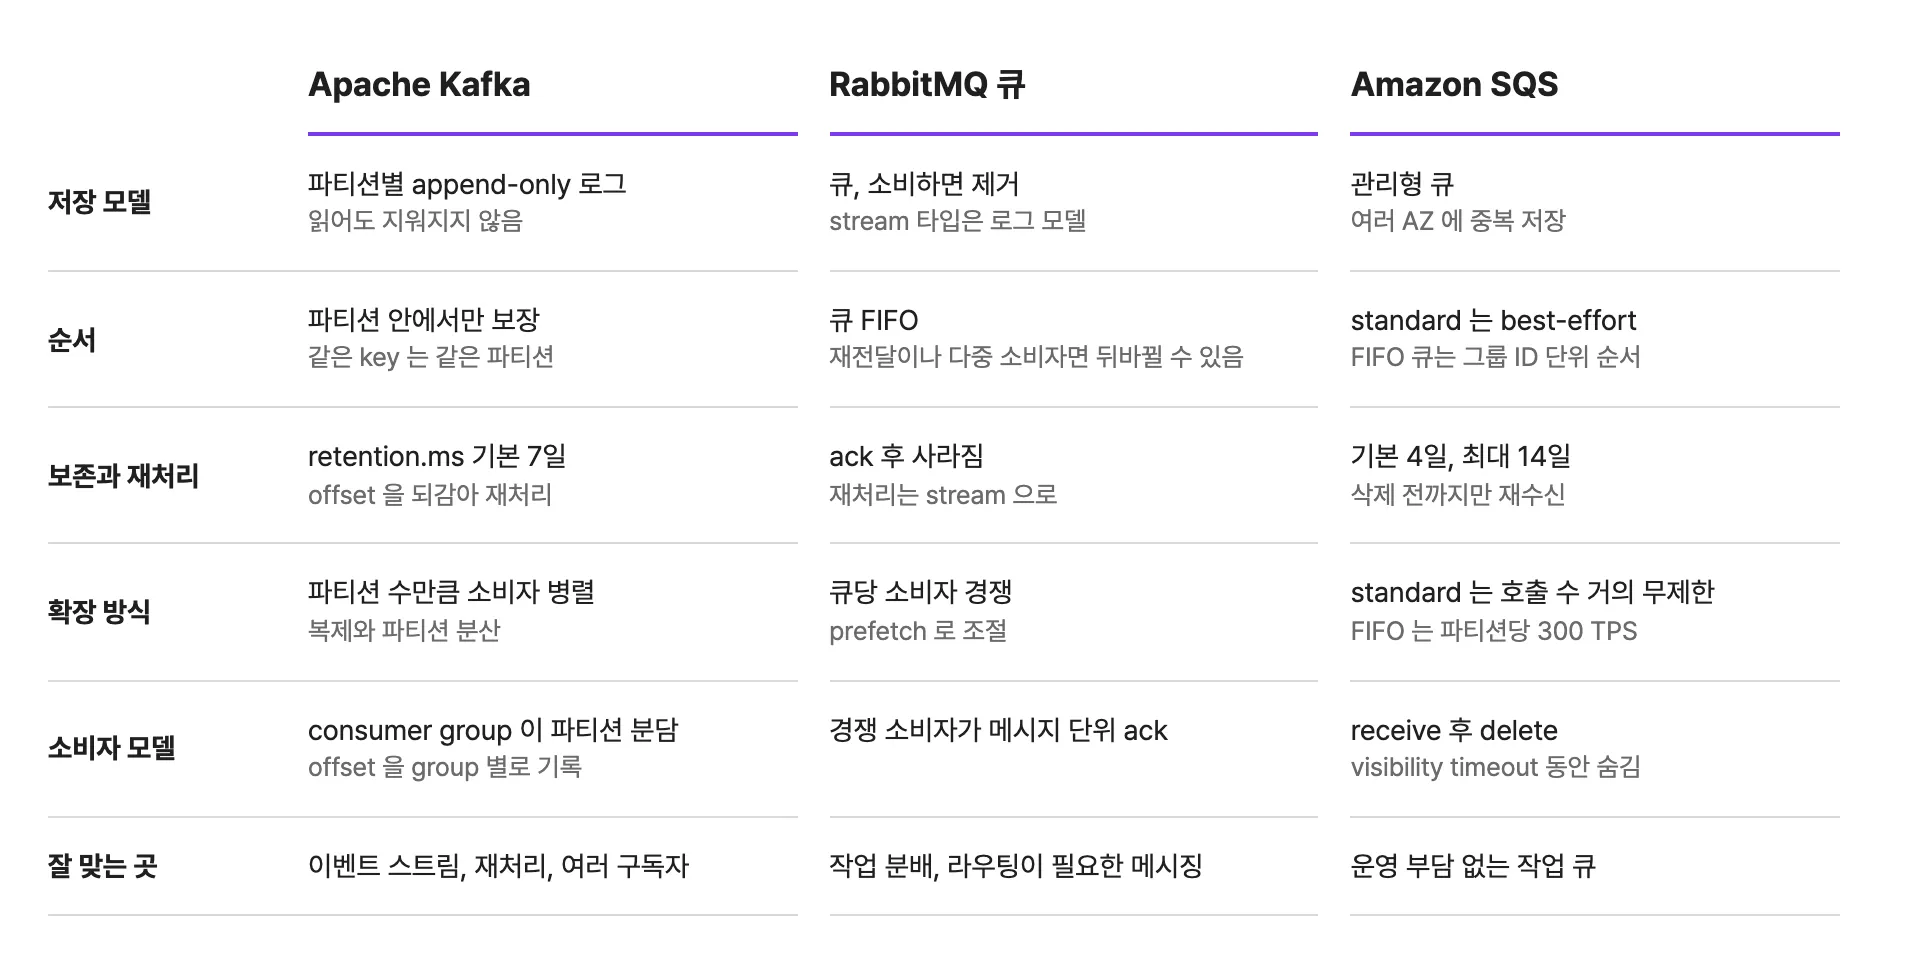
SQS 의 순서는 standard 큐에서 best-effort 이고, FIFO 큐는 비배치 호출 기준 파티션당 API 동작마다 300 TPS 가 기본 한도입니다(high throughput 모드로 올릴 수 있음). 한편 Kafka 는 처리량이 파티션 수에 비례해 늘어나는 구조라서 대량 스트림에 유리하지만, 그 확장은 브로커와 디스크, 모니터링을 직접 감당하는 대가가 붙습니다. Amazon MSK 나 Confluent Cloud 같은 관리형 서비스가 그 부담을 덜어 주는 선택지입니다.
언제 Kafka 를 쓰고 언제 쓰지 않을지
Kafka 가 값을 하는 경우는 대체로 이렇습니다. 같은 이벤트를 여러 시스템이 각자 소비해야 할 때, 장애 뒤나 새 소비자 추가 때 과거 이벤트를 다시 읽어야 할 때, key 단위의 순서가 필요하면서 처리량이 큰 스트림일 때, 변경 이력 자체가 자산인 이벤트 소싱 구조일 때입니다.
반대로 하루 몇천 건의 작업을 워커에게 나눠 주는 정도라면 SQS 나 RabbitMQ 로 충분합니다. 브로커 3대와 컨트롤러 3대를 굴리고, 파티션 수와 복제 계수와 보존 기간을 설계하고, 컨슈머 lag 을 지켜보는 일은 그 자체로 운영 비용입니다. 서비스가 한두 개이고 마이크로서비스로 쪼갠 것도 아니라면 데이터베이스 테이블을 큐처럼 쓰는 편이 오히려 낫기도 합니다. 저는 “재처리가 필요한가, 구독자가 둘 이상인가”를 먼저 묻고, 둘 다 아니라면 큐 쪽으로 기웁니다.
Kubernetes 에 올리려는 경우에도 브로커는 디스크와 네트워크 식별자가 중요한 상태 저장 워크로드라서, Kubernetes 위에서 직접 굴리기 전에 관리형 서비스나 전용 오퍼레이터를 먼저 검토하는 편이 안전합니다.
참고 자료
- Apache Kafka 공식 문서 - Design
- Apache Kafka - Producer Configs
- Apache Kafka - Consumer Configs
- Apache Kafka - Topic Configs
- Apache Kafka - KRaft
- Apache Kafka - Consumer Rebalance Protocol
- Apache Kafka 4.2 Upgrade Notes
- Apache Kafka 4.2.0 Release Announcement
- Apache Kafka Downloads
- KIP-932: Queues for Kafka
- KIP-848: The Next Generation of the Consumer Rebalance Protocol
- RabbitMQ - Streams
- RabbitMQ - Queues
- Amazon SQS - Standard queues
- Amazon SQS - Message quotas