시리즈: Effective Kotlin 정리 1편 안전성과 가독성 / 2편 재사용성과 추상화 설계 / 3편 객체 생성과 클래스 설계 / 4편 비용 줄이기와 컬렉션 처리 효율 (이 글)
이 시리즈의 Item 번호는 초판(52개 항목) 기준입니다. 2025년에 나온 개정판 『코틀린 아카데미: 이펙티브 코틀린』(인사이트)은 60개 항목으로 재구성되어 번호가 다릅니다.
4편은 『Effective Kotlin』 7장 비용 줄이기(Item 45부터 48까지)와 8장 효율적인 컬렉션 처리(Item 49부터 52까지)를 다룹니다. 이 영역의 항목은 모두 실제로 병목이 되는 곳에서 쓰라는 전제가 깔려 있습니다. 측정하지 않은 곳을 이 기법으로 일괄 치환하라는 이야기가 아닙니다.
7장 비용 줄이기
불필요한 객체를 만들지 않습니다 (Item 45)
Int 는 보통 JVM 기본형 int 로 컴파일됩니다. 그런데 널 가능(Int?)으로 만들거나 타입 인자(List<Int>)로 쓰면 Integer 객체가 됩니다. 기본형은 null 이 될 수 없고 제네릭 인자가 될 수 없기 때문입니다.
객체 생성이 늘 비싼 것은 아닙니다. HotSpot 64비트 JVM 의 기본 설정에서는 객체가 8바이트 단위로 정렬되고 헤더가 12바이트라서 빈 객체도 16바이트를 차지합니다(JDK 25 의 Compact Object Headers 를 켜면 헤더가 8바이트로 줄며 Android ART 는 수치가 다릅니다). 참조의 크기는 힙 설정에 좌우됩니다. 참조는 힙이 약 32GB 미만이면 압축 참조(compressed oops) 덕분에 4바이트, 그 이상이면 64비트 JVM 에서 8바이트입니다.
생성 비용이 크거나 가변 객체를 여러 개 돌려 써야 한다면 캐시나 객체 풀이 대안입니다. 캐시에 쓰는 참조 종류에서 차이가 납니다. WeakReference 는 다른 강한 참조가 없으면 다음 GC 때 회수됩니다. SoftReference 는 일반적인 JVM 구현에서 메모리가 부족할 때 회수되어 책은 캐시에 이쪽을 권하지만 Android 공식 문서는 소프트 참조 캐시를 피하고 LruCache 를 쓰라고 안내합니다. 무거운 클래스는 lazy 로 생성 시점을 미룰 수 있습니다.
class Screen {
    val parser by lazy { HeavyParser() }   // 처음 접근할 때만 생성
}

var best: Int? = null          // 갱신할 때마다 Integer 로 박싱(-128..127 밖이면 새 객체)
var fast = Int.MIN_VALUE       // 기본형 그대로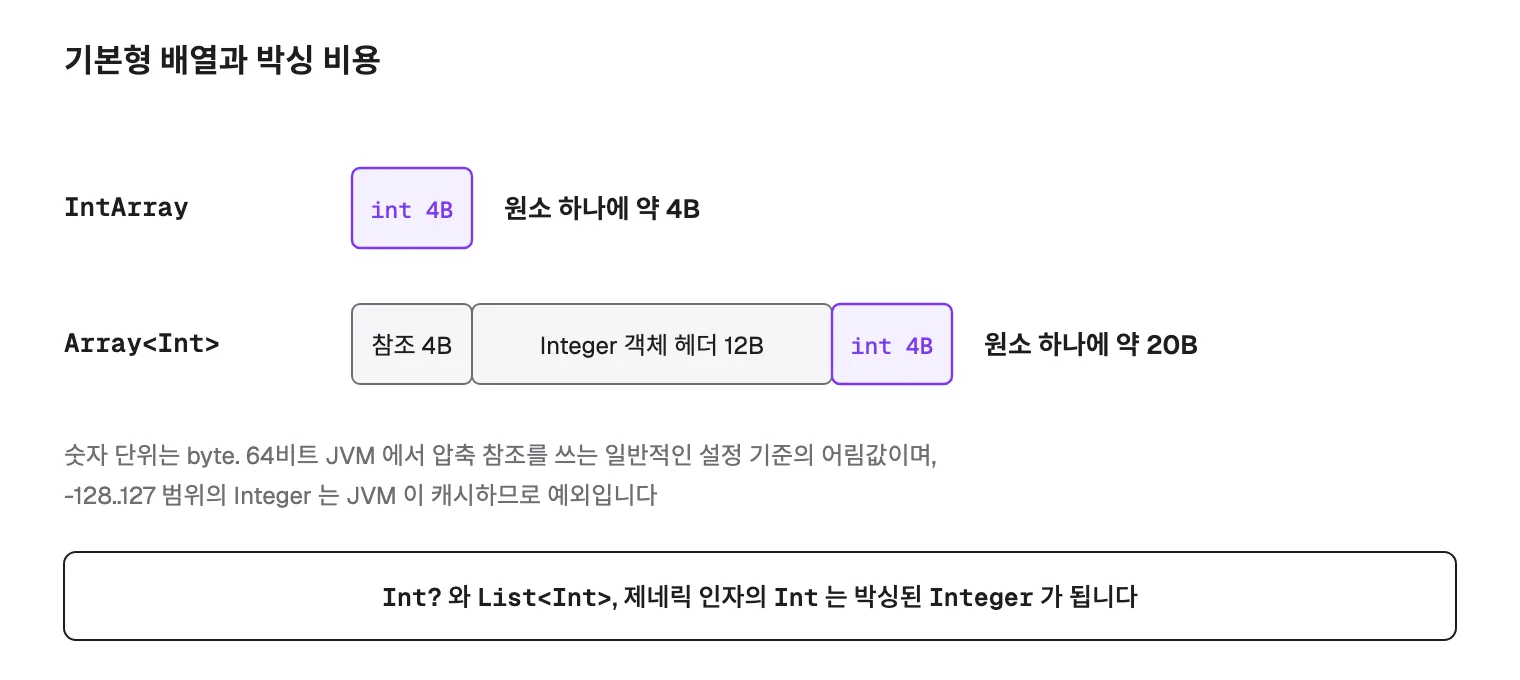
성능이 중요한 코드 안에서는 널 가능 타입보다 기본형을 쓰는 편이 낫습니다.
함수 타입 파라미터에는 inline (Item 46)
inline 을 붙이면 컴파일러가 호출문을 함수 본문으로 치환합니다. 일반 호출에 필요한 점프와 복귀 과정이 생략됩니다. 함수 타입 파라미터가 있는 함수라면 람다를 객체로 만들어 전달하는 비용도 함께 사라집니다. 호출마다 객체가 할당되는 쪽은 람다가 바깥 변수를 캡처할 때입니다.
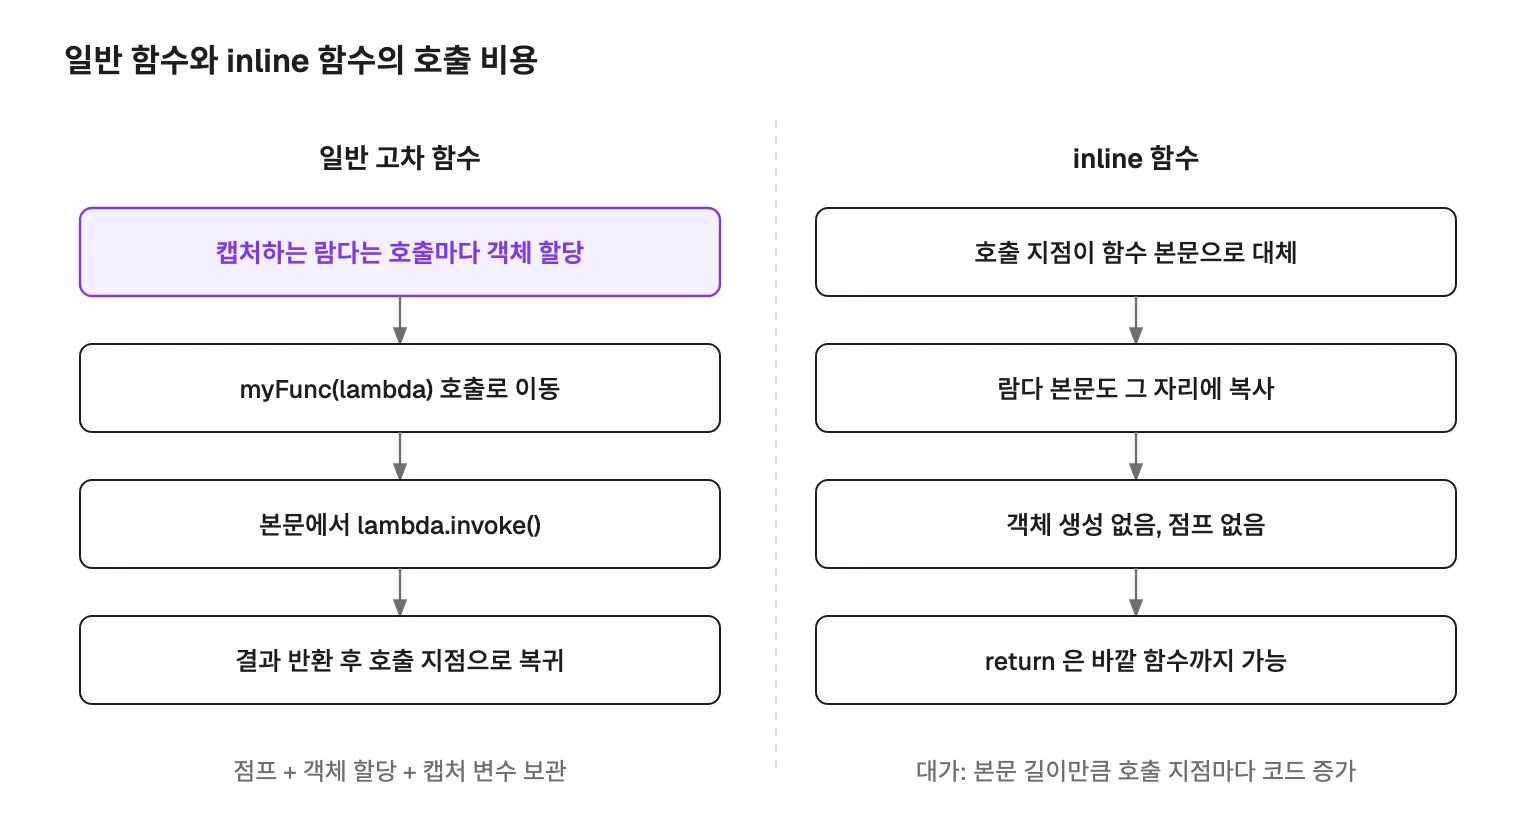
덤으로 얻는 것이 두 가지 있습니다. 타입 인자에 reified 를 붙일 수 있고 람다 안에서 바깥 함수를 끝내는 비지역 return 을 쓸 수 있습니다.
fun firstBig(list: List<Int>): Int? {
    list.forEach { if (it > 3) return it }   // forEach 가 inline 이라 가능
    return null
}

inline fun <reified T> List<*>.firstOfType(): T? = firstOrNull { it is T } as T?
한계도 있습니다. 공개된 inline 함수는 private, internal 함수와 프로퍼티를 쓰지 못합니다(internal 선언은 @PublishedApi 를 붙이면 쓸 수 있습니다). 구현을 숨길 수 없어서 클래스 멤버에는 잘 쓰이지 않고 API 를 정의할 때도 드뭅니다. 인라인 함수가 다른 인라인 함수를 부르면 코드가 기하급수적으로 늘 수 있으니 주의합니다.
인라인으로 받은 람다를 다루는 수정자가 둘 있습니다. crossinline 은 인라인 함수의 인자를 받되 비지역 return 은 막습니다. 인라인되지 않은 다른 람다 안에서 그 인자를 호출해야 할 때 문제가 생기기 때문입니다. noinline 은 그 인자만 인라인하지 않게 해서 일반 함수 인자처럼 저장하거나 넘길 수 있게 합니다.
inline 이 어울리는 곳은 print 같이 아주 자주 쓰는 함수, filterIsInstance 처럼 reified 타입 인자를 받는 함수, 함수 타입 파라미터를 받는 최상위 함수입니다. 마지막 범주에는 map, filter, flatMap 같은 컬렉션 처리 함수와 also, apply, let 같은 스코프 함수, repeat, run, with 같은 유틸리티가 들어갑니다.
값 클래스로 타입을 감쌉니다 (Item 47)
값 클래스(@JvmInline value class, 예전 이름은 인라인 클래스)는 한 값을 감싼 새 타입을 만들면서 런타임에는 감싼 값 자체를 쓰도록 컴파일됩니다. 메서드는 정적 메서드가 되므로 타입을 하나 더 두는 데 드는 오버헤드가 대부분의 경우 없습니다. 다만 제네릭 타입 인자나 인터페이스 타입, 널 가능 타입으로 쓰이면 래퍼 객체로 박싱됩니다. 활용처는 단위를 타입에 새기는 것과 같은 기본형끼리의 혼동을 막는 것입니다.
@JvmInline value class Meters(val value: Double)
@JvmInline value class UserId(val value: Int)

fun distance(from: Meters, to: Meters): Meters = Meters(to.value - from.value)
fun send(from: UserId, to: UserId) { /* ... */ }
Int 두 개를 받던 send 가 UserId 를 받게 되면 인자 순서를 뒤바꿔 넘기는 실수를 컴파일러가 잡아 줍니다. 값 클래스는 인터페이스를 구현할 수 있지만 그 인터페이스 타입으로 다루는 순간 박싱되어 이점이 줄어듭니다. 의미가 모호한 기본형 인자나 여러 단위가 섞이는 곳에서 고려할 만합니다.
쓸모없어진 참조를 없앱니다 (Item 48)
companion 이나 object 에 객체 참조가 남아 있으면 가비지 컬렉터가 그 메모리를 회수하지 못합니다. 상태를 들고 있는 동안에는 메모리 관리를 염두에 둬야 합니다. 큰 데이터를 최상위 프로퍼티나 object 선언(companion object 포함)에 저장하지 않습니다. 앱이 끝날 때까지 살아 있는 객체가 되기 때문입니다.
object ImageCache {
    val bitmaps = mutableListOf<Bitmap>()   // 프로세스가 사는 동안 계속 유지됩니다
}
8장 효율적인 컬렉션 처리
여러 단계는 Sequence 로 (Item 49)
Sequence 의 연산 함수는 결과를 바로 계산하지 않고 이전 단계를 감싼 새 시퀀스를 돌려줍니다(데코레이터 구조). 실제 계산은 first(), toList() 같은 최종 연산이 호출될 때 시작됩니다. 반면 Iterable 의 map, filter 는 호출 즉시 전체 원소를 처리해 새 List 를 만듭니다.
아래 애니메이션은 list.map { it * 2 }.filter { it > 4 }.first() 를 두 방식으로 처리하는 순서입니다. 왼쪽 Iterable 은 map 이 6개 전체에 적용되고 그 결과 리스트에 filter 가 다시 6개 전체에 적용된 뒤에야 first() 가 첫 원소를 꺼냅니다. 오른쪽 Sequence 는 원소를 하나씩 map 과 filter 에 통과시킵니다. 입력 3 이 map 을 거쳐 6 이 되어 처음으로 filter 를 통과하자마자 first() 가 멈추므로 입력 4, 5, 6 은 건드리지도 않습니다.
이 방식의 효과는 세 가지입니다. 원소가 한 개씩 끝까지 흘러가서 필요한 만큼만 계산합니다. 단계마다 중간 컬렉션이 생기지 않습니다. generateSequence 로 만든 무한 시퀀스도 takeWhile 이나 first 로 끊어 다룹니다.
val first = users.asSequence()
    .map { it.score * 2 }
    .filter { it > 100 }
    .first()

val powers = generateSequence(1) { it * 2 }.takeWhile { it < 100 }.toList()
시퀀스가 더 빠르지 않은 경우도 있습니다. sorted 는 시퀀스에서도 결국 모든 원소를 모아 정렬해야 하는 상태 유지 연산이라 지연 처리의 이점이 없습니다(책의 측정으로는 컬렉션 쪽이 더 빨랐습니다).
Java 스트림과 용도가 겹치는 부분이 있습니다. Kotlin 시퀀스는 제공하는 처리 함수가 더 많습니다. Java 스트림은 병렬 모드를 지원합니다. 병렬 처리가 필요하면 Java 스트림을, 그렇지 않으면 Kotlin 시퀀스를 고르는 것이 책의 기준입니다.
연산 수를 제한합니다 (Item 50)
컬렉션 처리 단계는 대부분 전체를 순회하는 비용과 중간 컬렉션을 만드는 비용이 듭니다. 이 둘은 단계를 하나로 합쳐 주는 적절한 함수로 줄일 수 있습니다.
| 이렇게 쓰는 대신 | 이 함수를 씁니다 |
|---|---|
.filter { it != null }.map { it!! } | .filterNotNull() |
.map { ... }.filterNotNull() | .mapNotNull { ... } |
.map { ... }.joinToString() | .joinToString { ... } |
.filter { A }.filter { B } | .filter { A && B } |
.filter { it is T }.map { it as T } | .filterIsInstance<T>() |
.sortedBy { key2 }.sortedBy { key1 } | .sortedWith(compareBy({ key1 }, { key2 })) |
listOf(...).filterNotNull() | listOfNotNull(...) |
.withIndex().filter { (i, e) -> ... }.map { it.value } | .filterIndexed { i, e -> ... } |
기본형 배열과 가변 컬렉션 (Item 51, 52)
성능이 중요한 구간에서는 기본형을 쓰는 IntArray, LongArray 같은 배열이 Array<Int> 나 List<Int> 보다 메모리를 덜 쓰고 빠릅니다(Item 51). 앞의 그림처럼 박싱된 쪽은 원소마다 참조와 객체가 따로 있기 때문입니다. 그래도 일반적인 용도에서는 훨씬 기능이 풍부하고 여러 곳에서 쓰기 편한 List 가 낫습니다.
가변 컬렉션은 원소를 추가할 때 새 컬렉션을 만들지 않으므로 읽기 전용 컬렉션에 + 를 반복하는 것보다 빠릅니다(Item 52). 지역 변수로 쓸 때는 가변 컬렉션을 고르는 것이 합리적입니다. 1편의 가변성 항목과 부딪히지 않습니다. 함수 안에서만 쓰이고 밖으로 나가지 않는 컬렉션은 상태 공유 문제가 생길 자리가 없기 때문입니다. 반면 var 에 읽기 전용 리스트를 두고 += 로 쌓으면 매번 새 리스트를 복사합니다.
var slow = emptyList<Int>()
for (x in 1..n) slow += x            // 반복마다 리스트 전체를 복사

val fast = buildList { for (x in 1..n) add(x) }   // 내부에서만 가변
참고: Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022, 초판 52개 항목 기준). 이 글은 해당 책의 항목을 요약하고 재해석한 것이며 원문을 인용한 것이 아닙니다.
참고 자료
- Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000003160882
- 『코틀린 아카데미: 이펙티브 코틀린』(강진혁·김보경 옮김, 인사이트, 2025, 60개 항목 개정판): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000011546361
- Effective Kotlin (Leanpub): https://leanpub.com/effectivekotlin
- Kotlin 문서, Inline functions: https://kotlinlang.org/docs/inline-functions.html
- Kotlin 문서, Inline value classes: https://kotlinlang.org/docs/inline-classes.html
- Kotlin 문서, Sequences: https://kotlinlang.org/docs/sequences.html
- Kotlin 문서, Collection operations: https://kotlinlang.org/docs/collection-operations.html
- Kotlin 문서, Collections overview: https://kotlinlang.org/docs/collections-overview.html
- Kotlin 문서, Numbers (boxing): https://kotlinlang.org/docs/numbers.html
- Kotlin API, joinToString: https://kotlinlang.org/api/core/kotlin-stdlib/kotlin.collections/join-to-string.html
- Java API, Integer.valueOf: https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/lang/Integer.html#valueOf(int)
- Android, SoftReference: https://developer.android.com/reference/java/lang/ref/SoftReference
- JEP 519, Compact Object Headers: https://openjdk.org/jeps/519