Marcin Moskała 의 『Effective Kotlin』 초판은 Kotlin 코드를 쓸 때 따져 볼 지점을 52개 항목으로 나누고 안전성, 가독성, 설계, 효율의 네 영역에 배치한 책입니다. 이 시리즈는 한국어 번역판 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022)을 읽으며 만든 요약 노트를 바탕으로 합니다.
이 글은 네 편으로 이어지는 시리즈의 첫 글입니다.
1편은 1장 안전성(Item 1부터 10까지)과 2장 가독성(Item 11부터 18까지)을 다룹니다.
1장 안전성
가변 상태를 줄입니다 (Item 1, 2)
상태가 바뀌는 코드는 “지금 이 값이 무엇인가”를 계속 추적해야 합니다. 상태가 늘면 서로의 관계까지 함께 이해해야 합니다. 멀티스레드에서는 값이 바뀌는 모든 지점이 충돌 후보이고 테스트해야 할 상태의 조합도 불어납니다. Kotlin 이 이를 줄이라고 내놓은 도구가 val, 읽기 전용 컬렉션, data class 의 copy 입니다.
val 이 막는 것은 재할당뿐입니다. 읽기 전용 프로퍼티가 가변 객체를 가리키면 내용은 얼마든지 바뀝니다. 커스텀 getter 가 있는 프로퍼티는 호출 시점마다 값이 달라질 수 있어서 스마트 캐스트도 되지 않습니다.
컬렉션은 인터페이스가 둘로 나뉩니다. Iterable, Collection, List, Set 은 읽기 전용이고 MutableList 같은 Mutable* 쪽이 변경 메서드를 더합니다. 읽기 전용 타입으로 받은 객체를 as MutableList 로 내려 캐스팅하면 실제 구현체에 따라 동작이 달라지고 예외가 날 수도 있으므로 피해야 합니다. 변경이 필요하면 toMutableList() 로 복사본을 만듭니다.
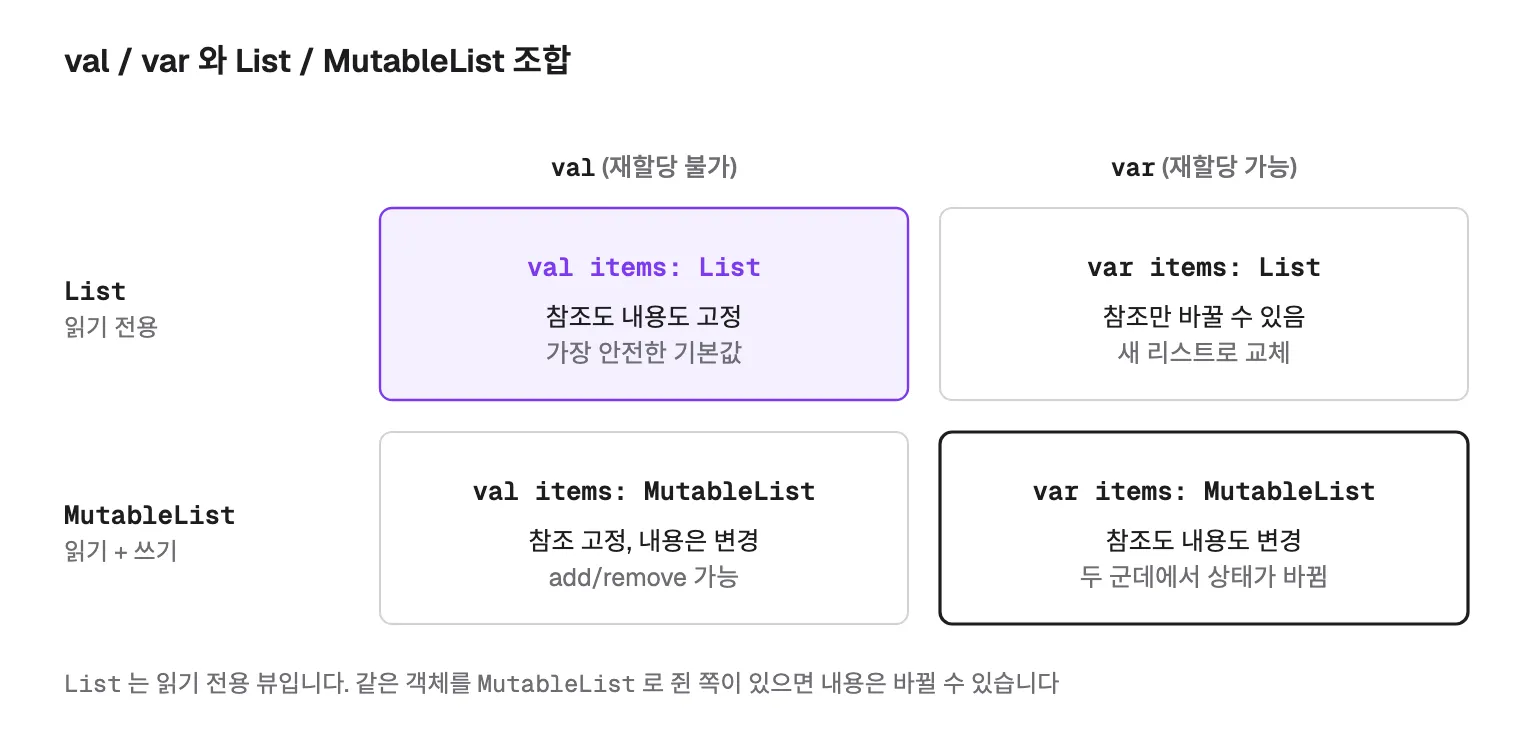
불변 객체는 여러 곳에서 공유해도 충돌하지 않습니다. 참조가 바뀌지 않으니 캐시하기 쉽고 방어적 복사도 필요 없으며 Set 이나 Map 의 키로도 안전합니다. 가변 객체를 키로 쓰다가 값을 바꾸면 해시 테이블 안에서 그 원소를 찾을 수 없게 됩니다. 그래서 바깥에 노출하는 타입은 읽기 전용으로 두고 변경 통로는 클래스 안에 가둡니다.
class Cart {
    private val _items = mutableListOf<Item>()
    val items: List<Item> get() = _items

    fun add(item: Item) { _items += item }
}

data class Player(val id: Int, val name: String)
val renamed = player.copy(name = "Thor")
가변이 꼭 필요하면 val + MutableList 보다 var + 읽기 전용 List 쪽이 변경 지점을 한 곳(재할당)으로 모아 주어 관찰하기 쉽습니다. Delegates.observable 을 붙이면 목록이 바뀔 때마다 로그를 남기는 일도 한 줄로 끝납니다.
var items: List<Item> by Delegates.observable(emptyList()) { _, old, new ->
    println("items: ${old.size} -> ${new.size}")
}
변수의 스코프(Item 2)도 같은 방향입니다. 프로퍼티보다 지역 변수, 넓은 블록보다 좁은 블록, var 보다 val 을 우선합니다. 스코프가 좁으면 변수가 바뀔 수 있는 구간이 짧아지고 읽는 사람이 확인할 범위도 줄어듭니다. 람다가 변수를 캡처할 때는 특히 주의가 필요합니다. 지연 평가되는 시퀀스 안에서 var 를 건드리면 시퀀스를 소비할 때마다 값이 바뀌어 의도와 다른 결과가 나옵니다.
var count = 0
val evens = sequenceOf(1, 2, 3, 4).filter { count++; it % 2 == 0 }
evens.toList()
evens.toList()   // count 는 이제 8
타입 정보를 정확히 남깁니다 (Item 3, 4)
Java 에서 넘어온 값은 널 가능성을 알 수 없어서 플랫폼 타입(String!)이 됩니다. 컴파일러는 널 검사를 요구하지 않으므로 null 이 들어 있어도 실행 중에 NPE 가 터집니다(Item 3). Java 쪽에 @Nullable, @NotNull 을 달 수 있다면 달고 그럴 수 없으면 Kotlin 쪽에서 받는 즉시 타입을 명시해 플랫폼 타입이 코드 안으로 퍼지지 않게 합니다.
val title: String? = javaApi.getTitle()타입 추론은 오른쪽 식의 타입을 정확히 그대로 가져옵니다. 상위 클래스나 인터페이스로 넓혀 주지 않습니다(Item 4). 지역 변수에서는 이쪽이 편하지만 공개 API 에서는 구현을 바꿀 때 타입이 같이 바뀌어 호출부가 깨질 수 있습니다. 외부에 보이는 선언은 타입을 명시하고 명시한 타입은 이유 없이 지우지 않습니다.
val defaultPet = Dog()   // 추론 타입이 Dog 라서, 나중에 Cat() 으로 바꾸면 Dog 를 기대하던 호출부가 깨집니다
val defaultAnimal: Animal = Dog()    // 구현을 바꿔도 공개 타입은 그대로입니다
기대를 코드로 적습니다 (Item 5, 6)
함수가 받아들이는 입력과 동작 가능한 상태는 문서보다 코드로 적는 편이 확실합니다. 인자에 대한 기대는 require, 객체 상태에 대한 기대는 check 로 씁니다. 전자는 IllegalArgumentException, 후자는 IllegalStateException 을 던집니다. 메시지는 람다로 넘기면 조건이 깨졌을 때만 만들어집니다. assert 는 JVM 에서 -ea 옵션이 켜져 있을 때만 AssertionError 를 던지므로 운영 코드의 검증 수단보다는 테스트 용도에 가깝습니다.
fun factorial(n: Int): Long {
    require(n >= 0) { "n 은 0 이상이어야 합니다: $n" }
    return if (n <= 1) 1 else n * factorial(n - 1)
}

fun send(message: String) {
    check(isConnected) { "연결된 뒤에만 호출할 수 있습니다" }
}
require 와 check 로 확인한 조건은 이후 코드에서 참으로 간주되므로 스마트 캐스트도 이어집니다. requireNotNull, checkNotNull 이 같은 역할을 합니다. 널 처리에서는 엘비스 연산자 오른쪽에 return 이나 throw 를 두는 형태가 자주 쓰이고 오른쪽에 여러 동작이 필요하면 run 으로 묶습니다.
val email = user.email ?: run {
    log("이메일이 없어 발송을 건너뜁니다")
    return
}
예외 종류(Item 6)는 새로 만들기보다 표준 예외를 씁니다. 많은 개발자가 이미 아는 이름이라 의미가 바로 전달됩니다.
| 예외 | 쓰는 상황 |
|---|---|
IllegalArgumentException | 인자가 잘못되었을 때 (require) |
IllegalStateException | 객체 상태가 맞지 않을 때 (check) |
IndexOutOfBoundsException | 인덱스가 범위를 벗어났을 때 |
ConcurrentModificationException | 금지된 동시 수정이 일어났을 때 |
UnsupportedOperationException | 이 객체가 지원하지 않는 메서드를 호출했을 때 |
NoSuchElementException | 요청한 원소가 없을 때 |
결과가 없을 때 (Item 7, 8)
서버 요청이 실패하거나, 조건에 맞는 원소를 못 찾거나, 문자열을 파싱할 수 없는 상황은 함수가 기대한 결과를 못 만드는 대표 사례입니다. 처리 방법은 null(또는 실패를 나타내는 sealed 클래스)을 돌려주거나 예외를 던지는 두 가지입니다. 예외는 정보를 전달하는 수단이 아니라 예외적인 상황을 위한 장치입니다. Kotlin 의 예외는 모두 unchecked 라서 호출자가 처리를 빠뜨릴 수 있습니다. 책은 예외가 명시적 검사보다 느리고 try 블록 안 코드의 최적화가 제한된다고 설명합니다(JVM 과 JIT 에 따라 차이가 있습니다).
그래서 어느 정도 예측되는 실패는 null 이나 Failure 로, 정말 예외적이고 예측하기 어려운 오류는 예외로 다루라는 것이 이 항목의 기준입니다. 둘의 차이는 실패 이유를 담느냐입니다. 이유가 필요 없으면 null, 이유를 호출자에게 알려야 하면 sealed 클래스입니다. 표준 라이브러리의 toIntOrNull, firstOrNull 같은 ~OrNull 계열이 앞의 예입니다.
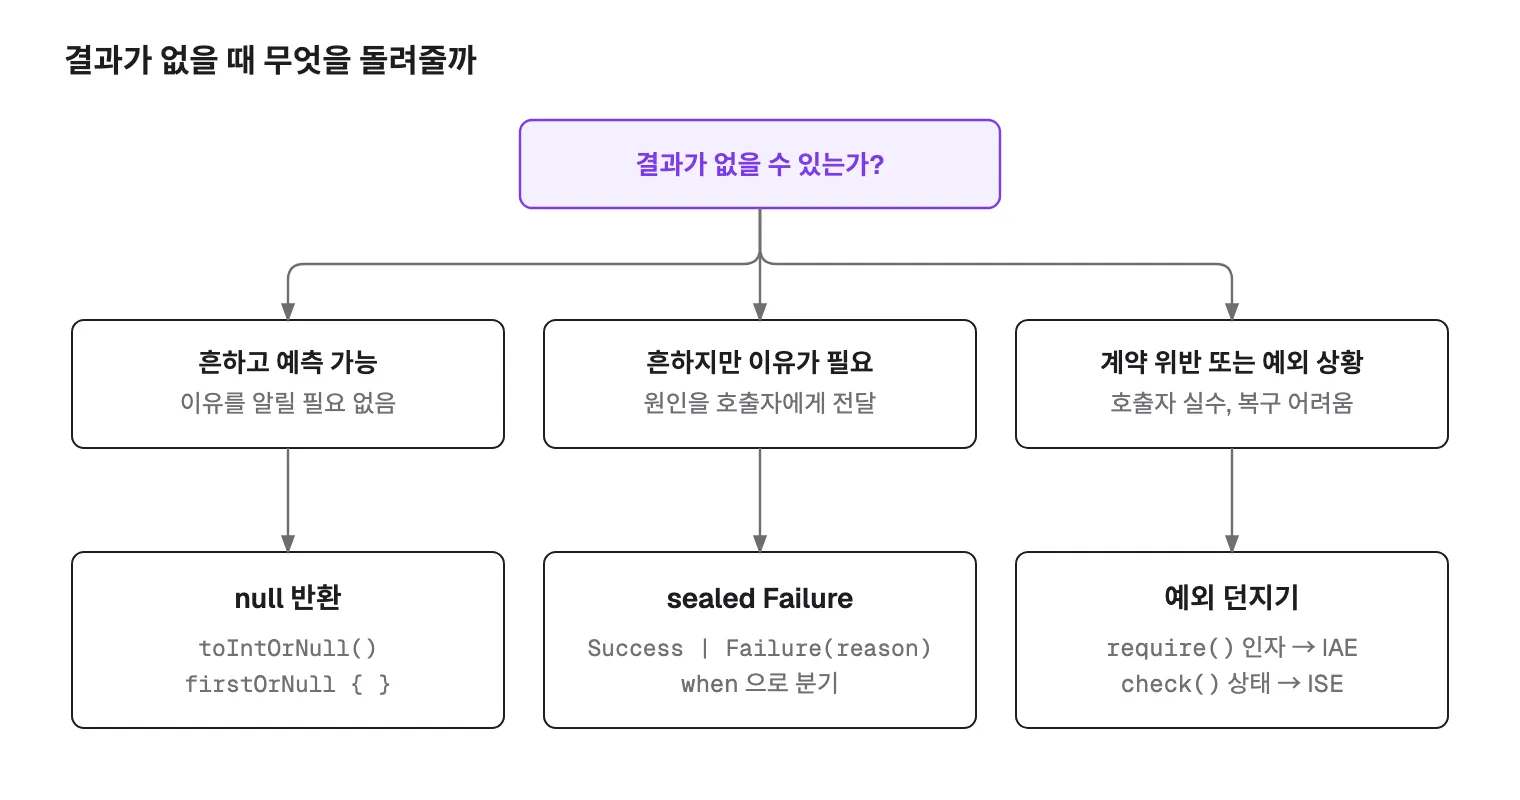
sealed class Outcome<out T> {
    data class Success<T>(val value: T) : Outcome<T>()
    data class Failure(val reason: String) : Outcome<Nothing>()
}

fun parseAge(text: String): Outcome<Int> {
    val age = text.toIntOrNull() ?: return Outcome.Failure("숫자가 아닙니다: $text")
    return if (age in 0..150) Outcome.Success(age) else Outcome.Failure("범위를 벗어났습니다: $age")
}
널 가능 타입을 다루는 방법(Item 8)은 세 갈래입니다. ?., 스마트 캐스트, 엘비스로 안전하게 처리하거나 오류를 던지거나 아예 널을 돌려주지 않게 함수와 프로퍼티를 고칩니다. !! 는 “거의 확실히 널이 아니다”라는 확신에서 쓰이는데 변수를 일단 null 로 두었다가 나중에 !! 로 꺼내는 패턴은 좋지 않습니다. 널을 피하는 설계도 몇 가지 있습니다. List 의 get 과 getOrNull 처럼 널 여부에 따라 함수를 나눠 두는 방법이 있고 생성 후 반드시 값이 채워지는 프로퍼티에는 lateinit 이나 Delegates.notNull 을 쓰며 null 대신 빈 컬렉션을 돌려줍니다.
class Screen {
    lateinit var adapter: ListAdapter
    var pageSize: Int by Delegates.notNull()   // lateinit 은 Int, Long 같은 기본형에 쓸 수 없습니다
}
기본형에는 lateinit 을 못 쓰니 Delegates.notNull 로 대신하는데 lateinit 보다 약간 느립니다.
자원은 닫고 코드는 테스트합니다 (Item 9, 10)
파일, 스트림 같은 자원은 닫지 않으면 누수가 되고 finally 로 직접 닫는 코드는 길고 실수하기 쉽습니다. Closeable 구현체라면 use 가 블록이 끝나거나 예외가 났을 때 알아서 닫아 줍니다. 파일을 줄 단위로 읽을 때는 useLines 가 있습니다.
val lineCount = File(path).useLines { lines -> lines.count() }단위 테스트(Item 10)에서 확인할 것은 세 묶음입니다. 가장 흔한 사용 방식, 자주 틀어질 만한 부분이나 예전에 문제가 났던 부분, 그리고 Int.MAX_VALUE, null, 경계값 같은 극단 입력과 잘못된 인자입니다.
2장 가독성
읽는 비용을 기준으로 삼습니다 (Item 11)
Kotlin 은 코드를 짧게 쓰려는 언어가 아니라 읽기 쉽게 쓰려는 언어입니다. 가독성은 코드를 읽고 이해하는 속도이고 이해에 드는 인지 부하를 줄이는 방향이 기준이 됩니다. 같은 기능이어도 한 줄로 압축한 코드가 읽는 사람을 오래 붙잡는다면 좋은 코드가 아닙니다.
let 이 어울리는 자리는 세 곳입니다. 널 가능한 가변 프로퍼티가 널이 아닐 때만 동작을 실행할 때, 인자를 처리한 뒤로 연산을 옮길 때, 객체를 데코레이터로 감쌀 때입니다.
user.nickname?.let { showBadge(it) }
students.filter { it.passed }.joinToString { it.name }.let(::println)
반대로 연산자 규약을 비틀어 쓰는 경우를 조심해야 합니다. 이름은 and 인데 문자열을 이어 붙이는 infix 함수나, 문자열에 invoke 를 정의해 호출처럼 보이게 만드는 코드는 언어가 이미 제공하는 문자열 연결을 굳이 새로 만든 셈이고 읽는 사람에게 짐만 됩니다.
연산자와 반환 타입 (Item 12, 13)
연산자는 이름이 가진 의미와 일치할 때만 오버로딩합니다(Item 12). a + b 는 a.plus(b), a in b 는 b.contains(a), a > b 는 a.compareTo(b) > 0 으로 바뀌므로 이 의미에서 벗어나면 읽는 사람이 오해합니다. Int.not() 을 팩토리얼 계산으로 정의해 !5 를 5 팩토리얼처럼 쓰는 코드가 전형적인 반례입니다. 의미가 분명하지 않은데 연산자 모양을 원하면 infix 확장 함수를 쓰고 그것도 어색하면 평범한 최상위 함수가 낫습니다.
data class Money(val amount: Long) {
    operator fun plus(other: Money) = Money(amount + other.amount)
}
val total = Money(1000) + Money(500)
Unit? 을 반환해 Boolean 처럼 쓰는 코드(Item 13)도 같은 문제입니다. 성공이면 Unit, 실패이면 null 이니 ?: return 으로 쓸 수는 있지만 의도를 한 번 해석해야 합니다. 참과 거짓은 Boolean 으로 표현합니다.
fun isValid(key: String): Unit? = if (key.length == 8) Unit else null
isValid(key) ?: return
fun isValid(key: String): Boolean = key.length == 8
if (!isValid(key)) return타입과 리시버를 드러냅니다 (Item 14, 15)
타입 추론을 쓰되 독자에게 중요한 정보를 가리지는 않아야 합니다(Item 14). val data = getSomeData() 처럼 반환 타입을 짐작하기 어려운 줄은 타입을 적어 주는 편이 낫습니다. 모든 변수에 타입을 달라는 말이 아니라 상황을 보고 판단하라는 항목입니다.
리시버도 마찬가지입니다(Item 15). apply, with, run 안에서는 리시버가 둘 이상 겹치기 쉽습니다. 레이블 없는 this 는 가장 가까운 리시버를 가리키므로 바깥 리시버에 접근하려면 레이블이 필요합니다. 애매해질 것 같으면 리시버를 명시합니다. 널 가능한 값에는 also 나 let 이 보통 더 낫습니다. also 는 it 으로 받아서 리시버를 명시하게 만드는 효과도 있습니다.
class Node(val name: String) {
    fun greet(other: Node) = other.run {
        "$name -> ${this@Node.name}"   // 앞의 name 은 other.name, 뒤는 바깥 Node 의 name
    }
}
DSL 에서는 안쪽 람다가 바깥 리시버의 멤버를 암묵적으로 호출하는 실수가 생기기 쉽습니다. @DslMarker 로 만든 어노테이션을 DSL 리시버 클래스에 붙이면 바깥 리시버를 쓸 때 명시적으로 적도록 강제됩니다. DslMarker 자체는 annotation class 에만 붙일 수 있습니다.
프로퍼티, 이름 붙인 인자, 컨벤션 (Item 16, 17, 18)
Kotlin 프로퍼티는 Java 의 필드와 다른 개념입니다(Item 16). 커스텀 getter, setter 를 가질 수 있고 field 로 지원 필드에 접근합니다. val 에 커스텀 getter 만 있고 그 안에서 field 를 쓰지 않으면 지원 필드가 생기지 않습니다. var 도 getter 와 setter 를 모두 정의하고 field 를 쓰지 않으면 지원 필드 없는 파생 프로퍼티가 됩니다. 인터페이스에도 프로퍼티를 선언해 하위 클래스에서 오버라이드할 수 있습니다.
함수를 프로퍼티로 대체할 수는 있어도 전부 바꾸는 것은 좋지 않습니다. 프로퍼티 getter 에 알고리즘이 들어가면 읽는 사람은 필드 접근 정도의 비용을 기대하다가 놀랍니다. 다음에 해당하면 함수가 맞습니다.
- 연산 비용이 크거나 복잡도가 O(1) 을 넘을 때
- 비즈니스 로직이 들어갈 때
- 같은 연산을 두 번 호출해 결과가 다를 수 있을 때(비결정적)
- 변환(conversion)을 표현할 때
- getter 가 상태를 바꿀 때
class User(val first: String, val last: String) {
    val fullName: String get() = "$first $last"
    fun loadFriends(): List<User> = fetchFromServer(this)
}
이름 붙인 인자(Item 17)는 값이 무엇을 뜻하는지 드러내고 파라미터 순서가 바뀌어도 안전합니다. 효과가 큰 경우는 기본값이 있는 파라미터, 같은 타입이 여러 개 이어지는 파라미터, 마지막 자리가 아닌 곳의 함수 타입 파라미터입니다. 함수 타입 파라미터는 마지막 자리에 두는 것이 기본이고 그 외의 위치에서는 이름을 붙입니다.
connect(host = "10.0.0.1", port = 8080, timeoutMs = 3000)코딩 컨벤션(Item 18)은 팀이 같은 모양으로 쓰도록 맞추는 일입니다. 파라미터가 많은 클래스나 함수는 파라미터를 한 줄에 하나씩 적고 IntelliJ 포매터나 ktlint 같은 도구로 자동화합니다.
참고: Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022, 초판 52개 항목 기준). 이 글은 해당 책의 항목을 요약하고 재해석한 것이며 원문을 인용한 것이 아닙니다.
참고 자료
- Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000003160882
- Effective Kotlin (Leanpub): https://leanpub.com/effectivekotlin
- Kotlin 문서, Null safety: https://kotlinlang.org/docs/null-safety.html
- Kotlin 문서, Java interop (Null-safety and platform types): https://kotlinlang.org/docs/java-interop.html#null-safety-and-platform-types
- Kotlin 문서, Exceptions: https://kotlinlang.org/docs/exceptions.html
- Kotlin 문서, Properties: https://kotlinlang.org/docs/properties.html
- Kotlin 문서, Delegated properties: https://kotlinlang.org/docs/delegated-properties.html
- Kotlin 문서, Operator overloading: https://kotlinlang.org/docs/operator-overloading.html
- Kotlin 문서, Collections overview: https://kotlinlang.org/docs/collections-overview.html
- Kotlin 문서, Type-safe builders: https://kotlinlang.org/docs/type-safe-builders.html
- Kotlin 문서, Coding conventions: https://kotlinlang.org/docs/coding-conventions.html
- Kotlin API, assert: https://kotlinlang.org/api/core/kotlin-stdlib/kotlin/assert.html