시리즈: Effective Kotlin 정리 1편 안전성과 가독성 / 2편 재사용성과 추상화 설계 / 3편 객체 생성과 클래스 설계 (이 글)
이 시리즈의 Item 번호는 초판(52개 항목) 기준입니다. 2025년에 나온 개정판 『코틀린 아카데미: 이펙티브 코틀린』(인사이트)은 60개 항목으로 재구성되어 번호가 다릅니다.
3편은 『Effective Kotlin』 5장 객체 생성(Item 33부터 35까지)과 6장 클래스 설계(Item 36부터 44까지)를 다룹니다. 이전 편과 같이 요약 노트를 바탕으로 새로 쓴 정리입니다.
5장 객체 생성
생성자 대신 팩토리 함수 (Item 33)
생성자 역할을 하는 함수를 팩토리 함수라고 부릅니다. 생성자에 걸려 있던 제약이 여러 곳에서 풀립니다.
- 이름을 붙일 수 있습니다. 파라미터 타입이 같은 생성자끼리 충돌하던 문제가 사라집니다.
- 반환 타입을 고릅니다. 실제 구현을 인터페이스 뒤에 숨기기에 알맞습니다.
- 호출마다 새 객체를 만들 필요가 없습니다. 싱글톤이나 캐시를 둘 수 있습니다.
- 프록시처럼 아직 존재하지 않는 객체를 돌려줄 수도 있습니다.
- 클래스 밖에 선언하면 가시성을 따로 정할 수 있습니다.
inline으로 만들어 타입 파라미터를reified로 쓸 수도 있습니다. - 생성자는 호출 즉시 상위 클래스나 주 생성자를 호출해야 하지만 팩토리는 원하는 시점에 생성자를 부를 수 있습니다.
한계도 있습니다. 하위 클래스를 만들려면 상위 클래스 생성자가 필요해서 팩토리 함수만으로는 서브클래스를 만들지 못합니다.
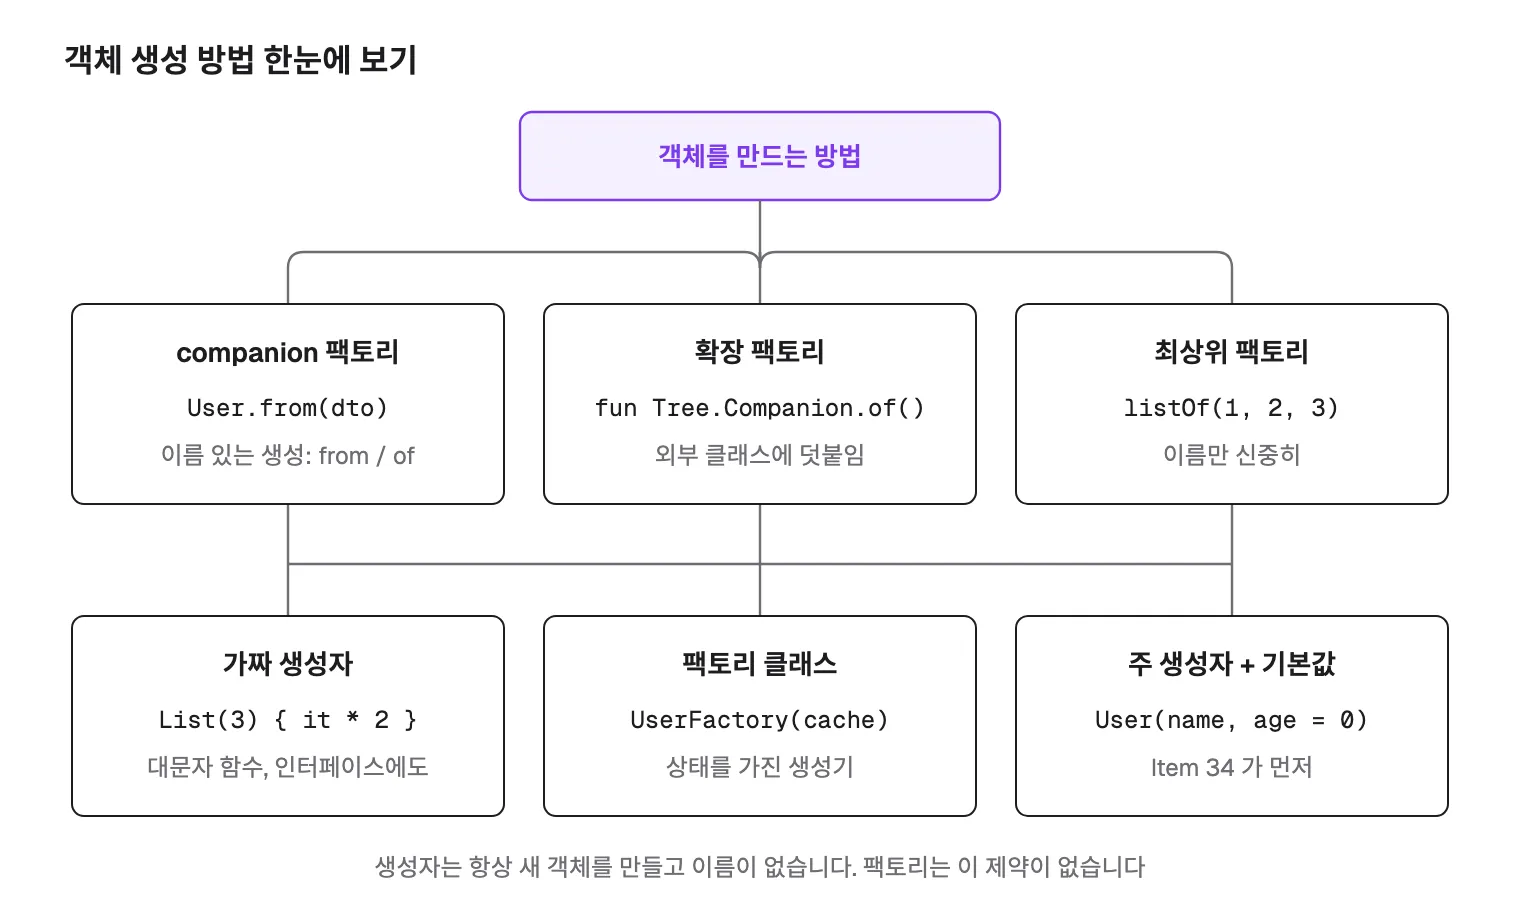
companion object 안의 팩토리가 가장 흔한 형태이고 관례적인 이름이 정해져 있습니다.
| 이름 | 역할 |
|---|---|
from | 파라미터 하나를 받아 같은 타입의 인스턴스를 돌려주는 변환 |
of | 파라미터 여러 개를 모아 인스턴스를 만듦 |
valueOf | from, of 와 비슷하지만 더 읽기 쉬운 이름 |
instance, getInstance | 싱글톤이거나 인자에 따라 같은 인스턴스를 돌려줌 |
createInstance, newInstance | getInstance 와 비슷하되 호출마다 새 인스턴스 |
getType | 다른 클래스에 있는 팩토리에서, Type 은 반환 타입 |
newType | 다른 클래스에 있는 팩토리에서 호출마다 새 인스턴스 |
companion object 는 인터페이스를 구현하거나 클래스를 상속할 수 있어서 추상 companion 팩토리가 값을 들고 캐시나 테스트용 가짜 객체를 만드는 데 쓰입니다. companion 을 직접 고칠 수 없으면 확장 함수로 팩토리를 덧붙입니다. 이때 대상 클래스에는 내용이 비어 있더라도 companion object 가 선언되어 있어야 합니다. listOf, setOf, mapOf 는 최상위 팩토리의 대표 예이고 이름이 곧 API 가 되므로 최상위 팩토리는 이름 짓기에 공을 들입니다.
class Money private constructor(val cents: Long) {
    companion object {
        fun of(dollars: Long) = Money(dollars * 100)
        fun fromCents(cents: Long) = Money(cents)
    }
}

interface Tree
fun Tree(name: String): Tree = TreeImpl(name)   // 인터페이스를 위한 가짜 생성자
val doubled = List(3) { it * 2 }                // 표준 라이브러리의 가짜 생성자
가짜 생성자는 인터페이스에도 생성자 같은 호출 형태를 주고 싶을 때, 또는 reified 타입 인자가 필요할 때 씁니다. companion 에 invoke 를 정의해 비슷한 효과를 내는 방법은 권장되지 않습니다. 팩토리 클래스는 프로퍼티로 상태를 가지므로 캐시나 이전에 만든 객체의 복제 같은 최적화에 쓰입니다. 점층적 생성자와 빌더는 Kotlin 에서 의미가 적은데 이유는 다음 항목에서 다룹니다.
기본 인자가 있는 주 생성자 (Item 34)
점층적 생성자 패턴은 기본 인자로 대체됩니다. 인자를 원하는 순서로 주고 이름까지 붙이면 각 값의 의미가 훨씬 분명해집니다. 빌더 패턴과 견줘도 이점이 큽니다. 코드가 짧고 기본값과 내부 처리가 빌더 객체 속에 숨지 않아 한눈에 보이며 주 생성자는 언어에 내장된 개념이라 따로 배울 것이 없습니다. 동시성에서도 차이가 납니다. Kotlin 함수 파라미터는 항상 불변이지만 빌더는 대개 가변 프로퍼티를 쥐고 있어서 스레드 안전하게 만들기 까다롭습니다.
class Pizza(
    val size: Int,
    val cheese: Boolean = true,
    val toppings: List<String> = emptyList(),
)

val pizza = Pizza(size = 12, toppings = listOf("olive"))
빌더가 여전히 맞는 경우는 두 가지입니다. 빌더 패턴을 쓰는 다른 언어의 라이브러리를 옮겨 올 때와, 기본 인자나 DSL 을 지원하지 않는 언어에서 쉽게 쓰도록 API 를 설계할 때입니다. 그 외에는 기본 인자가 있는 주 생성자나 DSL 을 우선합니다.
복잡한 생성에는 DSL (Item 35)
Kotlin DSL 은 타입 안전해서 IDE 가 힌트를 여럿 줍니다. 재료는 함수 타입입니다. () -> Unit, (Int) -> Int, (Int, Int) -> Int 는 물론 함수를 돌려주는 (Int) -> () -> Unit, 함수를 받는 (() -> Unit) -> Unit 도 모두 함수 타입이며 람다, 익명 함수, 함수 참조로 만들 수 있습니다.
DSL 에서 중요한 쪽은 리시버가 있는 함수 타입입니다. 일반 함수 타입 앞에 타입. 을 붙인 형태로 확장 함수를 나타냅니다. 람다로 정의하면 this 가 그 리시버를 가리킵니다. 이 타입의 핵심은 this 가 가리키는 대상을 바꿀 수 있다는 점이고 apply 도 같은 원리로 동작합니다.
val addTo: Int.(Int) -> Int = { this + it }
val seven = 3.addTo(4)

class Menu {
    val items = mutableListOf<String>()
    fun item(name: String) { items += name }
}

fun menu(init: Menu.() -> Unit): Menu = Menu().apply(init)

val lunch = menu {
    item("김밥")
    item("라면")
}
DSL 이 어울리는 곳은 복잡한 자료 구조, 계층 구조, 많은 양의 데이터입니다. 독자에게 중요하지 않은 정보가 반복되는데 이를 줄여 주는 다른 언어 기능이 없을 때도 후보가 됩니다.
6장 클래스 설계
상속보다 합성 (Item 36)
상속의 본래 용도는 is-a 관계로 묶이는 타입 계층을 만드는 것입니다. 단지 코드를 재사용하려고 상속을 쓰면 비용이 따라붙습니다.
- 부모 클래스는 하나만 지정할 수 있어서 공통 동작을 모으다 보면
BaseXXX클래스가 점점 비대해지고 계층도 깊어집니다. - 자식은 부모의 멤버를 전부 물려받으므로 필요 없는 메서드까지 노출되고, 인터페이스 분리 원칙에서 멀어집니다.
- 메서드 하나를 이해하려고 여러 단계의 부모 클래스를 오르내려야 한다면 구조가 이미 무겁다는 신호입니다.
- 부모의 내부 구현이 바뀌면 자식의 동작도 함께 달라지므로 캡슐화가 약해집니다.
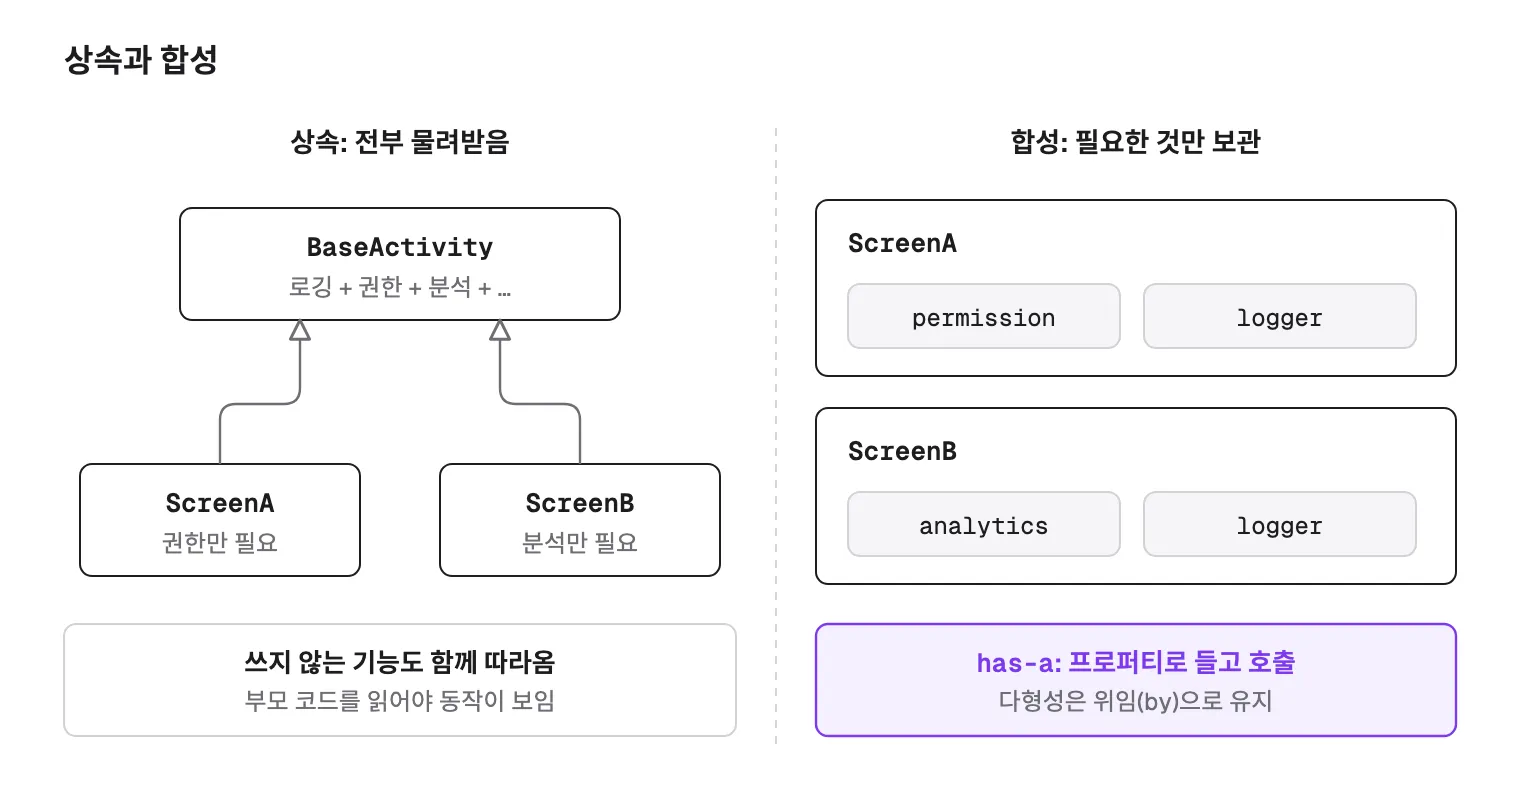
합성은 필요한 객체를 프로퍼티로 보관하고 그 객체의 함수를 호출하는 방식입니다. 보관하고 위임하는 코드가 조금 늘어도 실행 흐름이 눈에 보이고 여러 기능을 한 클래스에 조립해도 계층은 평평하게 유지됩니다. 다형성이 필요하면 위임 패턴을 씁니다. 인터페이스를 구현하되 실제 처리는 내부 객체에 맡기는 방식이고 Kotlin 은 by 문법으로 이를 지원합니다(공식 문서의 Delegation 항목).
interface Cache { fun get(key: String): String? }

class Repo(private val logger: Logger, cache: Cache) : Cache by cache {
    fun load(id: String) = logger.log("load $id")
}
Kotlin 클래스와 메서드는 기본이 final 이라 상속하려면 open 으로 열어야 하고 오버라이드한 메서드는 하위에서 다시 final 로 닫을 수 있습니다. 상속을 염두에 두지 않은 메서드는 final 로 둡니다. 상속이 어울리는 때는 세 조건이 모두 맞을 때입니다. 분명한 is-a 관계가 있고 모든 하위 클래스가 상위 클래스 자리에서 동작하며 상위 클래스의 단위 테스트를 하위 클래스도 통과해야 합니다. 마지막 조건이 리스코프 치환 원칙입니다.
data 로 묶음 데이터 표현 (Item 37)
data 수정자를 붙이면 toString, equals 와 hashCode, copy, componentN 이 생성됩니다. toString 은 클래스 이름과 주 생성자의 모든 프로퍼티를 값과 함께 출력해서 로그와 디버깅에 좋습니다. equals 는 주 생성자 프로퍼티가 같은지 비교하고 hashCode 는 이와 일관된 결과를 줍니다.
copy 는 주 생성자 프로퍼티를 복사한 새 객체를 만들고 이름 붙인 인자로 일부 값만 바꿉니다. 얕은 복사지만 객체가 불변이면 깊은 복사가 필요 없으므로 문제가 없습니다. 그래서 불변 data class 와 잘 어울립니다. componentN 은 위치 기반 구조 분해에 쓰입니다.
data class Player(val id: Int, val name: String, val points: Int)

val player = Player(0, "Gecko", 9999)
val thor = player.copy(name = "Thor")
val (id, name, points) = player
구조 분해할 때는 주 생성자의 프로퍼티와 같은 이름을 쓰는 것이 좋습니다. 순서를 잘못 쓰면 IDE 가 경고해 줍니다. 프로퍼티가 하나뿐인 클래스를 구조 분해하는 코드는 피합니다.
튜플은 data class 로 대체하는 편이 낫습니다. Kotlin 에 남은 튜플은 Pair 와 Triple 뿐이고 튜플만 봐서는 무엇을 나타내는지 알 수 없어 읽기 어렵습니다. data class 로 바꾸면 함수의 반환 타입이 명시적이고 짧아집니다. 구조 분해에서 이름을 다르게 쓰면 경고도 나옵니다. 튜플이 남는 자리는 값에 재빨리 이름만 붙이고 싶을 때와 미리 알 수 없는 집합을 표현할 때입니다.
연산과 동작은 함수 타입으로 (Item 38)
추상 메서드가 하나뿐인 인터페이스를 SAM 이라 부릅니다. 이런 인터페이스를 받는 함수는 그 구현 객체를 받는다는 뜻이고 파라미터를 함수 타입으로 선언하면 람다, 익명 함수, 함수 참조, 함수 타입을 구현한 객체 어느 쪽이든 인자로 넘길 수 있습니다.
typealias OnClick = (View) -> Unit

fun setOnClick(listener: OnClick) { /* ... */ }

setOnClick { view -> /* ... */ }
setOnClick(::showUsers)
SAM 의 장점으로 “이름이 있다”가 거론되는데 typealias 로 함수 타입에도 이름을 붙일 수 있습니다. 람다에서는 인자 구조 분해도 됩니다. 특별한 이유가 없다면 인터페이스보다 함수 타입을 고릅니다. 예외는 Kotlin 이 아닌 언어에서 쓸 클래스를 설계할 때입니다. Java 에서는 인터페이스가 더 명확하고 함수 타입으로 만든 클래스는 타입 별칭과 IDE 지원의 혜택을 온전히 받지 못합니다. Kotlin 의 fun interface 로 선언한 SAM 인터페이스는 람다로 만들 수 있어서 그 중간 지점이 됩니다.
태그 클래스 대신 클래스 계층 (Item 39)
kind: String 처럼 모드를 구분하는 값(태그)을 들고 있고 그 값에 따라 동작이 갈리는 클래스가 태그 클래스입니다. 서로 다른 책임이 한 클래스 안에서 태그 비교로만 나뉘므로 모드별 처리 코드가 한 곳에 쌓입니다. 프로퍼티는 특정 모드에서만 의미가 있어 나머지 모드에서는 널이거나 무시되고, 올바른 조합으로 만들어졌는지 보장하려면 별도의 검증이나 팩토리가 필요합니다.
class Shape(val kind: String, val radius: Double?, val width: Double?, val height: Double?)sealed class Shape {
data class Circle(val radius: Double) : Shape()
data class Rect(val width: Double, val height: Double) : Shape()
}
fun area(shape: Shape): Double = when (shape) {
is Shape.Circle -> Math.PI * shape.radius * shape.radius
is Shape.Rect -> shape.width * shape.height
}Kotlin 에서는 모드마다 클래스를 따로 두어 구분을 타입 시스템과 다형성에 맡기고 상위 타입은 sealed 로 제한합니다. abstract 도 가능하지만 sealed 는 같은 모듈의 같은 패키지 밖에서는 직접 하위 클래스를 정의하지 못하게 막아 새 타입이 끼어들지 않음을 보장합니다(Kotlin 1.5 부터는 같은 패키지라면 다른 파일에 둘 수 있고 sealed interface 도 쓸 수 있습니다). 그 덕분에 when 에 else 가 필요 없고 확장 함수로 기능을 덧붙이기도 쉽습니다. 하위 클래스를 통제하려면 sealed, 상속 구조를 열어 두려면 abstract 를 고릅니다.
상태 패턴은 태그 클래스와 다릅니다. 내부 상태가 바뀌면 객체의 동작이 바뀌는 디자인 패턴으로 프론트엔드의 컨트롤러, 프레젠터, ViewModel 설계에 널리 쓰입니다. 상태는 책임이 많고 바뀌는 대상이어서 구체적인 상태를 sealed 계층의 객체로 나타내고 불변으로 만들어 필요할 때 state 프로퍼티를 교체하는 식으로 다룹니다.
equals 의 계약 (Item 40)
Any 에는 equals, hashCode, toString 이 있고 각각 오래 다져진 계약이 딸려 있습니다. Item 40 부터 42 까지가 이 계약을 지키는 이야기입니다.
Kotlin 의 동등성은 두 가지입니다. == (그리고 !=)는 equals 로 구조적 동등성을 확인하며 왼쪽이 널 가능이면 a?.equals(b) ?: (b === null) 로 바뀝니다. === 는 같은 객체를 가리키는지 보는 참조 동등성입니다. 서로 무관한 타입을 연산자로 비교하는 것은 막혀 있어서 "".equals(1) 은 컴파일되지만 "" == 1 은 컴파일되지 않습니다.
Any 가 기본으로 구현한 equals 는 === 처럼 동작하므로 객체는 기본적으로 모두 고유합니다. data 를 붙이면 주 생성자 프로퍼티가 같을 때 같은 객체가 됩니다. 일부 프로퍼티만으로 비교하고 싶다면 비교에서 뺄 프로퍼티를 주 생성자 밖의 클래스 본문에 선언합니다. 이 프로퍼티는 copy() 도 복사하지 않습니다. 직접 구현해야 하는 때는 기본 동작과 달라야 할 때, 일부 프로퍼티만 비교할 때, data 를 쓰지 않거나 비교 대상이 주 생성자에 없을 때입니다.
data class User(val id: Int, val name: String) {
    var lastSeen: Long = 0   // equals, hashCode, toString, copy, componentN 에서 모두 제외됩니다
}
계약은 다섯 가지입니다.
- 반사성: 널이 아닌
x는x.equals(x)가true입니다. - 대칭성:
x.equals(y)와y.equals(x)의 결과가 같아야 합니다. 다른 타입과의 동등성을 확인하려다 깨지기 쉽고 한번 깨지면 디버깅에서 찾기 어렵습니다. 다른 클래스의 객체는 같지 않다고 보는 쪽이 안전합니다. - 추이성:
x == y이고y == z이면x == z여야 합니다. 상속 계층에서 같은 타입끼리만 비교하는 식으로 풀려 하면 리스코프 치환 원칙을 어기므로 처음부터 합성을 택해 두 객체의 비교 자체를 없애는 편이 낫습니다. - 일관성: 비교에 쓰는 프로퍼티가 바뀌지 않았다면 몇 번을 호출해도 결과가 같아야 합니다. 그러려면
equals는 두 객체에만 의존하는 순수 함수여야 합니다. - 널:
x.equals(null)은 항상false입니다.
세 메서드는 모두 매우 빨리 실행될 것으로 기대되니 빠르게 만들어야 합니다. java.net.URL 의 equals 가 반면교사입니다. 같은 IP 로 해석되면 같다고 판단해서 결과가 네트워크 상황에 좌우되므로 java.net.URI 를 쓰라고 권합니다. 특별한 이유가 없다면 equals 는 직접 구현하지 않고 상속 관계에서는 하위 클래스가 동작을 바꾸지 않게 합니다.
hashCode 의 계약 (Item 41)
hashCode 는 해시 테이블을 만들 때 쓰입니다. 해시 함수는 원소마다 숫자를 매기고 그 숫자로 버킷을 정합니다. 같은 원소는 늘 같은 숫자를 받으니 다른 버킷을 뒤지지 않고 곧장 찾아갑니다. 좋은 해시 함수는 빠르고 서로 다른 값에 다른 숫자를 주어 충돌이 적습니다. 가변 객체를 Set 이나 Map 의 키로 쓰면 값이 바뀌었을 때 엉뚱한 버킷을 보게 되므로 키로 쓰지 않거나 쓴다면 절대 수정하지 않습니다.
계약은 이렇습니다. 객체가 바뀌지 않는 한 몇 번을 호출해도 같은 결과여야 하고 equals 로 같은 두 객체는 hashCode 도 같아야 합니다. 넓게 흩뿌릴수록 좋지만 필수는 아닙니다. 항상 같은 숫자를 돌려주면 모든 원소가 한 버킷에 몰려 해시 테이블이 의미를 잃습니다. equals 를 직접 정의했다면 hashCode 도 같은 프로퍼티로 함께 정의합니다. 관례는 해시 값을 더하기 전에 지금까지의 결과에 31 을 곱하는 것이고 JVM 에서는 Objects.hash() 도 쓸 수 있습니다. 직접 구현할 일은 드물고 data 수정자가 대부분을 해결합니다.
compareTo 의 계약 (Item 42)
compareTo 는 세 성질을 갖춰야 합니다. 반대칭성은 a >= b 이고 b >= a 이면 a == b 여야 한다는 요구로 비교와 동등성이 모순되지 않아야 합니다. 추이성은 a >= b 이고 b >= c 이면 a >= c 여야 한다는 요구이며 어기면 정렬 결과가 틀어지거나 JVM 에서는 “Comparison method violates its general contract!” 예외가 날 수 있습니다. 완전성(connex)은 모든 쌍에서 a >= b 나 b >= a 중 하나는 참이어야 한다는 요구입니다. 관계없는 원소가 섞여 있으면 퀵 정렬이나 삽입 정렬 같은 고전 알고리즘을 쓸 수 없고 위상 정렬 같은 다른 방법으로 가야 합니다. 구현은 같으면 0, 수신자가 크면 양수, 작으면 음수를 반환합니다.
Kotlin 에서 compareTo 를 직접 정의할 일은 드뭅니다. 한 프로퍼티 기준이면 sortedBy 로 충분하고 여러 프로퍼티를 쓸 때는 compareBy 로 만든 비교자를 sortedWith 에 넘깁니다. 자연스러운 순서가 있는지 확신이 서지 않으면 비교자 쪽이 낫고 자주 쓰는 비교자는 companion object 에 둡니다. 값 두 개를 간단히 비교할 때는 compareValues, 선택자를 쓰거나 값이 더 많을 때는 compareValuesBy 가 있습니다.
val sorted = users.sortedWith(compareBy({ it.lastName }, { it.firstName }))확장 함수와 멤버 확장 (Item 43, 44)
클래스의 멤버가 될 수 있는 것은 확장으로도 만들 수 있습니다. 둘의 가장 큰 차이는 확장을 쓰려면 따로 임포트해야 해서 보통 다른 패키지에 두게 된다는 점입니다. 멤버를 직접 추가할 수 없을 때나 데이터와 동작을 나누는 설계에서 확장이 맞습니다. 이름은 같은데 동작이 다른 확장이 공존하면 위험하므로 그런 우려가 있으면 멤버로 만듭니다. 컴파일러는 언제나 멤버를 확장보다 먼저 고르기 때문입니다.
class User(val name: String, val surname: String)
val User.fullName: String get() = "$name $surname"

open class A
class B : A()
fun A.hi() = "A"
fun B.hi() = "B"

val a: A = B()
a.hi()   // "A": 확장은 가상이 아니라 컴파일 시점의 타입으로 정해집니다
차이를 표로 모으면 다음 정도입니다.
| 구분 | 멤버 | 확장 |
|---|---|---|
| 사용 | 그대로 호출 | 임포트가 필요 |
| 오버라이드 | 가상 함수라 가능 | 정적으로 결정되어 불가 |
| 우선순위 | 높음 | 낮음 |
| 클래스 참조 | 멤버로 나타남 | 나타나지 않아 어노테이션 프로세서가 처리하지 않음 |
- 확장은 클래스가 아니라 타입에 정의되므로 널 가능 타입이나 특정 제네릭 타입에도 정의할 수 있습니다.
확장은 리시버를 첫 인자로 받는 일반 함수로 컴파일되므로 상속을 염두에 둔 요소는 확장으로 만들지 않습니다. 반대로 핵심이 아닌 부수적인 API 는 확장으로 빼 두면 클래스 본체가 가벼워지고 어노테이션 프로세서의 눈에서도 벗어납니다. 핵심 API 는 멤버에 둡니다.
확장을 클래스나 인터페이스의 멤버로 정의할 수도 있지만 DSL 을 만들 때를 빼면 피합니다(Item 44). 멤버 확장은 참조(::)가 지원되지 않고 암묵적으로 접근할 때 어느 리시버가 선택되는지 헷갈립니다. 확장의 가시성을 제한하려고 멤버로 넣는 것도 권하지 않으며 가시성 수정자를 붙이면 됩니다.
private fun Item.priceLabel() = "$price 원" // 멤버 확장 대신 가시성 수정자로 범위를 제한합니다참고: Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022, 초판 52개 항목 기준). 이 글은 해당 책의 항목을 요약하고 재해석한 것이며 원문을 인용한 것이 아닙니다.
참고 자료
- Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000003160882
- 『코틀린 아카데미: 이펙티브 코틀린』(강진혁·김보경 옮김, 인사이트, 2025, 60개 항목 개정판): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000011546361
- Effective Kotlin (Leanpub): https://leanpub.com/effectivekotlin
- Kotlin 문서, Data classes: https://kotlinlang.org/docs/data-classes.html
- Kotlin 문서, Sealed classes and interfaces: https://kotlinlang.org/docs/sealed-classes.html
- Kotlin 문서, Functional (SAM) interfaces: https://kotlinlang.org/docs/fun-interfaces.html
- Kotlin 문서, Extensions: https://kotlinlang.org/docs/extensions.html
- Kotlin 문서, Delegation: https://kotlinlang.org/docs/delegation.html
- Kotlin 문서, Equality: https://kotlinlang.org/docs/equality.html
- Kotlin 문서, Type-safe builders: https://kotlinlang.org/docs/type-safe-builders.html
- Kotlin 문서, Operator overloading: https://kotlinlang.org/docs/operator-overloading.html
- Java API, URL.equals: https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/net/URL.html#equals(java.lang.Object)