시리즈: Effective Kotlin 정리 1편 안전성과 가독성 / 2편 재사용성과 추상화 설계 (이 글)
이 시리즈의 Item 번호는 초판(52개 항목) 기준입니다. 2025년에 나온 개정판 『코틀린 아카데미: 이펙티브 코틀린』(인사이트)은 60개 항목으로 재구성되어 번호가 다릅니다.
2편은 Marcin Moskała 의 『Effective Kotlin』 3장 재사용성(Item 19부터 25까지)과 4장 추상화 설계(Item 26부터 32까지)를 다룹니다. 앞 편과 마찬가지로 요약 노트를 바탕으로 다시 쓴 글이라 해석이 들어 있습니다.
3장 재사용성
중복의 기준은 “같은 지식인가”입니다 (Item 19)
이 장에서 말하는 지식은 단순한 정보가 아니라 의도가 담긴 정보입니다. 알고리즘이 동작하는 방식, 화면의 모양, 원하는 결과가 모두 지식이고 코드, 설정, 템플릿 어디에든 담길 수 있습니다. 같은 지식이 여러 곳에 흩어져 있으면 하나를 바꿀 때 전부 찾아 고쳐야 합니다. 모든 화면에서 직접 스타일을 지정한 버튼의 모양을 바꾸거나, 여러 쿼리에 문자열로 박힌 테이블 이름을 바꾸는 상황이 그렇습니다. 앞쪽은 공통 스타일로, 뒤쪽은 ORM 으로 한 곳에 모으는 것이 해결책입니다.
그렇다고 닮은 코드를 모두 합치라는 뜻은 아닙니다. 두 코드 조각이 같은 지식인지 판단하는 질문은 하나입니다. 함께 바뀔 가능성이 큰가, 따로 바뀔 가능성이 큰가. 코드를 뽑아내는 이유가 변경을 쉽게 하려는 것이므로 이 질문이 가장 기본입니다.
const val USERNAME_MAX = 20   // 계정 정책에서 나온 값
const val TITLE_MAX = 20      // 화면 디자인에서 나온 값
두 상수는 값이 우연히 같을 뿐 바뀌는 이유가 다릅니다. 하나로 합치면 한쪽 정책을 바꿀 때 다른 쪽까지 끌려갑니다. 단일 책임 원칙(SRP)도 같은 이야기입니다. 클래스가 바뀌는 이유는 하나여야 하고 서로의 영역을 모르는 두 행위자가 같은 클래스를 고치는 상황은 없어야 합니다. 다른 곳에서 쓰이는 지식은 따로 변할 가능성이 크므로 처리가 비슷해 보여도 별개의 지식으로 두는 편이 낫습니다. 그렇지 않으면 재사용하면 안 될 것을 재사용하고 싶어집니다.
흔한 알고리즘과 프로퍼티 패턴 (Item 20, 21)
객체를 만든 뒤 setter 를 줄줄이 호출하는 JavaBean 방식은 Kotlin 에서 쓸 이유가 없습니다(Item 20). 주 생성자나 팩토리 함수로 한 번에 만들고 불가피하면 apply 로 한 객체의 프로퍼티 설정을 묶습니다.
val dialog = Dialog().apply {
    title = "삭제할까요?"
    message = "되돌릴 수 없습니다"
}
반복되는 알고리즘은 확장 함수로 뽑으면 좋은 점이 많습니다. 함수는 상태가 없어서 특히 부수 효과가 없을 때 동작을 표현하기 알맞습니다. 최상위 함수와 달리 특정 타입에만 쓰도록 제한할 수 있고 수정할 객체를 인자로 넘기는 것보다 리시버로 쓰는 쪽이 읽기 쉽습니다. IDE 자동 완성에도 잘 걸립니다. DateUtils.isWeekend(date) 는 유틸리티 클래스의 이름을 먼저 알아야 하지만 date.isWeekend() 는 date. 까지만 입력해도 후보에 나타납니다.
fun Iterable<Int>.product(): Int = fold(1) { acc, n -> acc * n }프로퍼티에서 되풀이되는 패턴은 프로퍼티 위임으로 뽑습니다(Item 21). 위임은 다른 객체의 메서드로 프로퍼티의 getter, setter 를 구현하는 방식이고 그 객체에는 getValue(그리고 var 라면 setValue)라는 이름의 operator 메서드가 있어야 합니다. 클래스에 연결하는 문법이 by 입니다. 표준 라이브러리에는 lazy, Delegates.observable, Delegates.vetoable, Delegates.notNull 이 들어 있습니다.
val config by lazy { loadConfig() }
var volume by Delegates.vetoable(5) { _, _, new -> new in 0..10 }

class Pref(private val key: String) {
    operator fun getValue(thisRef: Any?, property: KProperty<*>): String = Prefs.read(key)
    operator fun setValue(thisRef: Any?, property: KProperty<*>, value: String) = Prefs.write(key, value)
}
var token: String by Pref("token")
제네릭과 타입 파라미터 (Item 22, 23)
타입 파라미터를 가진 함수가 제네릭 함수입니다(Item 22). 타입 파라미터는 컴파일러에 타입 정보를 넘겨 추론을 정확하게 해 줍니다. 제네릭은 원래 컬렉션이 구체적인 타입을 담도록 클래스와 인터페이스에 도입된 기능인데 함수에도 같은 이점이 있어서 여러 타입에 통하는 알고리즘을 한 번만 쓰게 해 줍니다. 타입 파라미터로 허용 범위를 좁히는 것도 중요한 용도입니다. 특정 타입의 하위 타입만 받도록 제한합니다.
fun <T : Comparable<T>> Iterable<T>.biggest(): T? {
    var best: T? = null
    for (item in this) if (best == null || item > best) best = item
    return best
}
섀도잉은 지역 선언이 바깥 스코프의 선언을 가리는 현상입니다(Item 23). 타입 파라미터에서 일어나면 읽기도 어렵고 결과도 뜻밖입니다. 아래 코드에서 Garden 의 T 와 plant 의 T 는 이름만 같을 뿐 서로 무관한 타입 파라미터라서 Garden<Rose> 에 Tulip 을 심는 호출이 막히지 않습니다.
interface Plant
class Rose : Plant
class Tulip : Plant

class Garden<T : Plant> {
    fun <T : Plant> plant(seed: T) { /* ... */ }   // 안쪽 T 가 바깥 T 를 가립니다
}
의도가 클래스의 T 만 받는 것이라면 메서드의 타입 파라미터를 지우고 fun plant(seed: T) 로 씁니다. 별개의 타입이 필요하다면 이름을 바꿔 구분되게 합니다.
변성: out 과 in (Item 24)
class Cup<T> 처럼 변성 수정자가 없는 타입 파라미터는 무변(invariant)입니다. Cup<Dog> 와 Cup<Animal> 사이에 아무 관계가 없습니다. 관계를 주고 싶으면 out 이나 in 을 붙입니다.
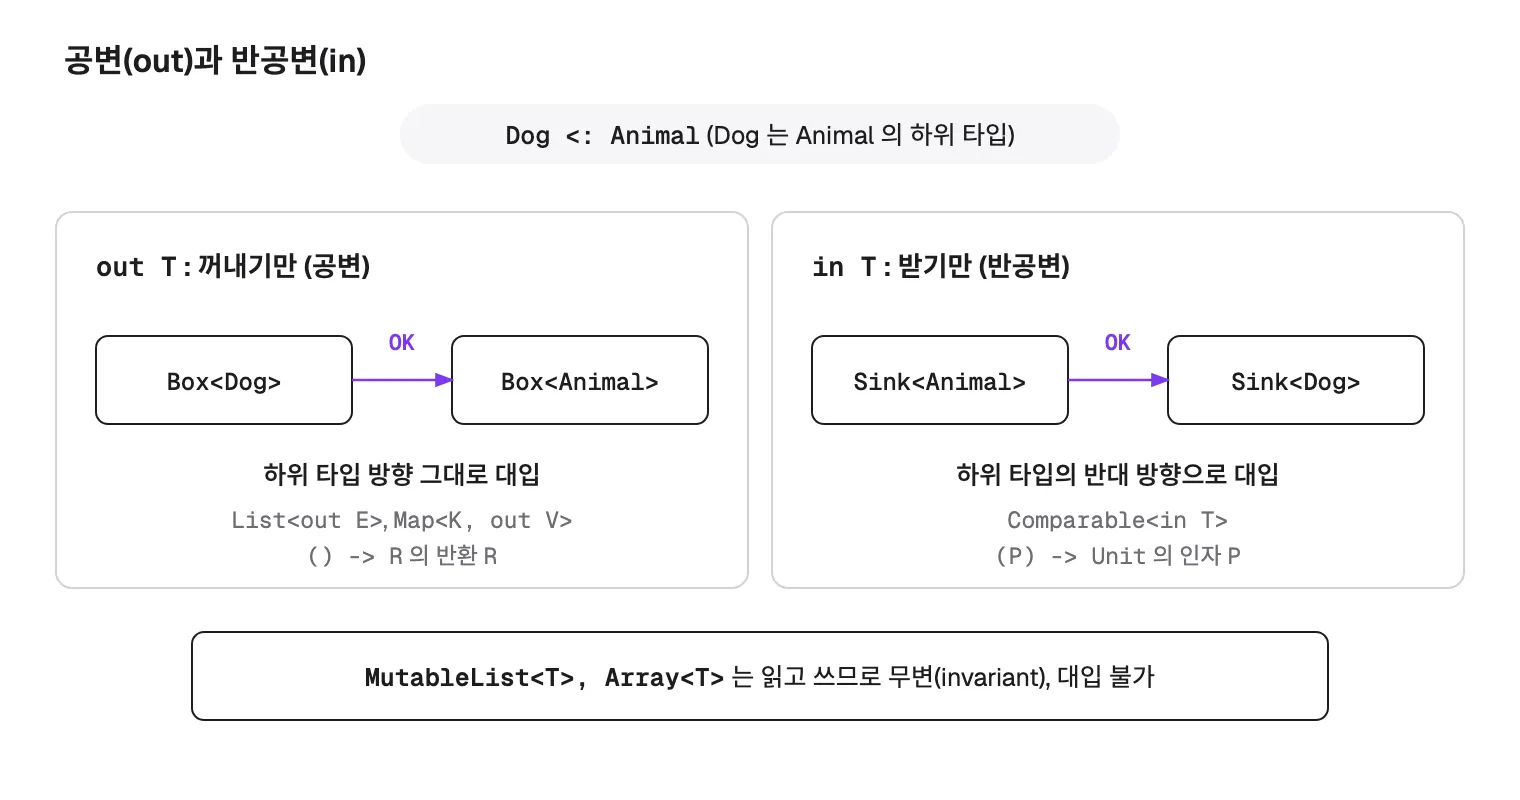
out 은 공변입니다. A 가 B 의 하위 타입이면 Cup<A> 도 Cup<B> 의 하위 타입입니다. in 은 반대로 반공변이라 Cup<A> 가 Cup<B> 의 상위 타입이 됩니다. 함수 타입은 이미 이 규칙을 따릅니다. 모든 파라미터 타입은 반공변이고 반환 타입은 공변입니다.
class Box<out T>(val value: T)
interface Sink<in T> { fun put(item: T) }

val animals: Box<Animal> = Box<Dog>(Dog())
val dogSink: Sink<Dog> = object : Sink<Animal> {
    override fun put(item: Animal) { /* ... */ }
}
안전성은 컴파일러가 지킵니다. 공변 out 타입 파라미터를 공개된 in 위치(함수 파라미터)에 쓰면 컴파일 오류가 나고 반공변 in 타입 파라미터를 공개된 out 위치(반환 타입)에 쓰는 것도 막힙니다. 같은 인스턴스 안에서만 접근되는 private 멤버는 이 검사에서 빠집니다. 바깥에서 업캐스트된 참조로 접근할 길이 없기 때문입니다.
class Cup<out T> {
    fun put(item: T) { }   // 컴파일 오류: out 으로 선언된 T 가 in 위치에 쓰였습니다
}
표준 라이브러리에서 List 와 Set 의 타입 파라미터, Map 의 값 타입은 out 이고 Array, MutableList, MutableSet, MutableMap 은 읽고 쓰기 때문에 무변입니다. 값을 돌려주기만 하는 타입에는 out, 받기만 하는 타입에는 in 을 씁니다.
공통 모듈을 플랫폼 사이에서 공유합니다 (Item 25)
Kotlin 은 Kotlin/JVM 으로 백엔드(Spring, Ktor)와 안드로이드 앱과 데스크톱을, Kotlin/JS 로 웹을, Kotlin/Native 로 iOS 프레임워크와 Linux, macOS 프로그램을, Kotlin/Wasm 으로 브라우저용 코드도 만들 수 있습니다. 같은 로직이 플랫폼마다 따로 구현되어 있으면 앞서 본 지식 중복이 플랫폼 수만큼 생깁니다. 검증 규칙, 도메인 모델, 계산 로직처럼 플랫폼과 무관한 부분을 공통 모듈로 빼서 공유하는 것이 이 항목의 요지입니다.
4장 추상화 설계
추상화는 복잡한 데이터, 모듈, 시스템에서 핵심 개념만 추려 내는 일입니다. 무엇을 숨기고 무엇을 드러낼지 정하는 일이기도 합니다. 프로그래밍에서 쓰는 이유는 세 가지입니다. 복잡성을 숨기고 코드를 정리하며 작성자가 나중에 바꿀 자유를 확보합니다.
함수는 한 추상 수준으로 씁니다 (Item 26)
함수는 단순하고 작게 쓰고 책임도 최소한으로 줄입니다. 작고 책임이 하나인 함수가 이해하기 쉽다는 데서 출발한 항목입니다. 한 함수 안에 높은 수준의 흐름과 낮은 수준의 세부 구현이 섞이면 읽는 사람이 눈높이를 계속 바꿔야 합니다.
fun checkout(cart: Cart) {
    require(cart.items.isNotEmpty())
    val body = "{\"total\":" + cart.total + "}"
    http.post("/pay", body)
    mailer.send(cart.user.email, "주문해 주셔서 감사합니다")
}
검증, 결제 요청 직렬화, 메일 발송이 한 덩어리입니다. 같은 일을 단계 이름만 보이게 쓰면 한 수준으로 정렬됩니다.
fun checkout(cart: Cart) {
    validate(cart)
    val order = createOrder(cart)
    pay(order)
    notifyUser(order)
}
변경에 대비한 추상화 (Item 27)
추상화는 변화로부터 코드를 지키는 방패이기도 합니다. 리터럴은 의미 있는 이름의 상수 프로퍼티로 바꾸고 두 번 이상 쓰이는 값은 상수로 뽑습니다. 동작은 함수로 이름을 붙이고 상태와 여러 함수를 묶어야 하면 클래스가 함수보다 강력합니다. 인터페이스 뒤에 객체를 숨기면 사용자는 구현이 아닌 추상에만 의존하므로 결합도가 낮아집니다.
반대로 추상화가 지나치면 코드를 따라가기 어려워집니다. 적정선은 정해져 있지 않고 팀 규모와 경험, 프로젝트의 크기와 수명, 도메인에 대한 이해도에 따라 움직입니다.
- 인원이 많고 오래 갈 프로젝트에서는 생성과 사용 방식을 나중에 고치기 어렵습니다. 모듈과 부품을 일찍부터 인터페이스로 분리하고 의존성 주입 프레임워크를 도입하는 편이 유리합니다.
- 테스트 작성이 필요하거나 다른 애플리케이션 위에 새 애플리케이션을 올리는 경우에도 추상화가 경계를 제공합니다.
- 규모가 작고 실험적인 프로젝트는 추상화 없이 직접 고치다가 문제가 드러난 시점에 대응해도 무방합니다.
추상화는 중복을 줄이고 코드를 정돈하는 용도를 넘어 변경 비용을 관리하는 수단이므로, 변경이 예상되는 지점에 선별적으로 둡니다.
API 안정성과 외부 API 래핑 (Item 28, 29)
API 를 공개했다면 쓰는 쪽을 생각해야 합니다(Item 28). 버전 번호의 의미를 정한 규칙이 시맨틱 버저닝(SemVer)이고 번호는 MAJOR.MINOR.PATCH 세 부분입니다. 호환되지 않는 API 변경이면 MAJOR, 호환을 유지한 기능 추가이면 MINOR, 단순 버그 수정이면 PATCH 를 올립니다. MAJOR 를 올릴 때는 MINOR 와 PATCH 를 0 으로, MINOR 를 올릴 때는 PATCH 를 0 으로 되돌립니다. 곧 없앨 API 는 바로 지우지 않고 @Deprecated 와 ReplaceWith 로 대체 방법을 안내하면서 단계를 둡니다.
외부 라이브러리 API 는 래퍼로 감쌀지 고려합니다(Item 29).
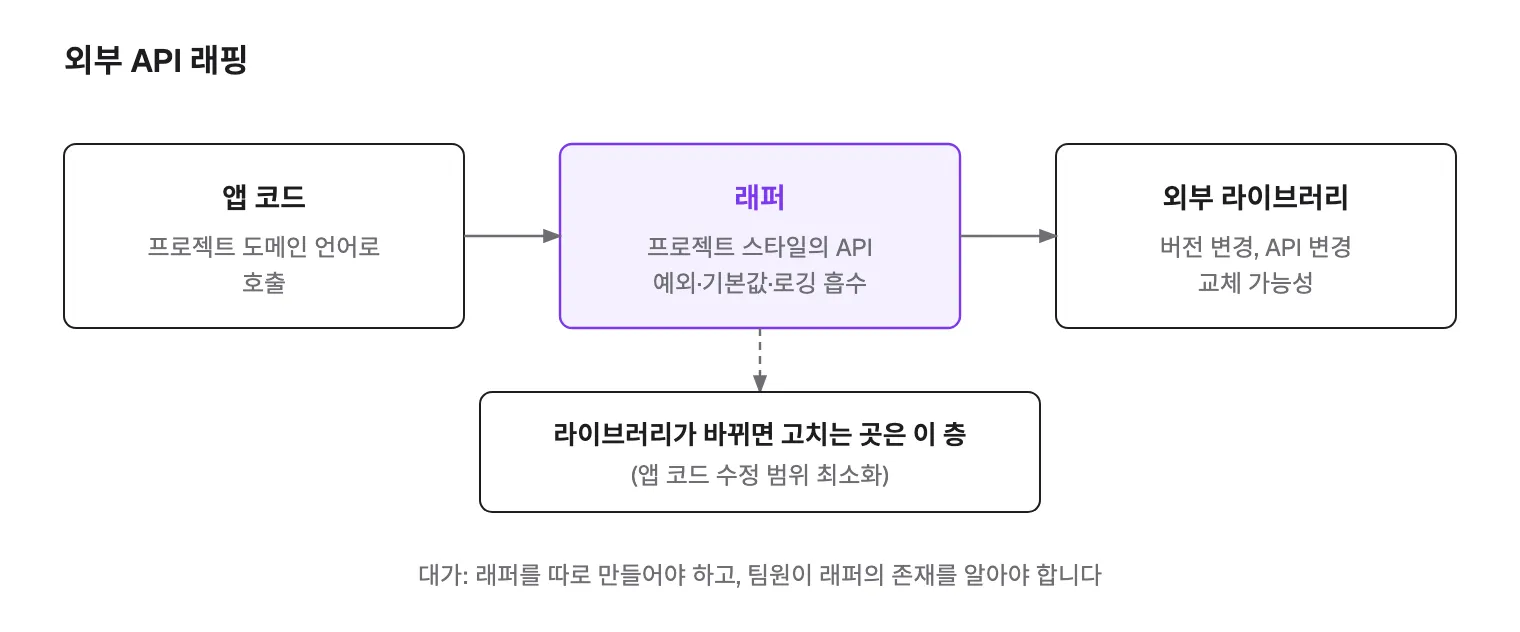
래핑의 이득은 변경의 충격을 한 곳에 가두는 데서 나옵니다. 라이브러리 API 가 바뀌거나 다른 라이브러리로 교체해야 할 때 래퍼 내부만 수정하면 되고, 호출부는 프로젝트 스타일에 맞춘 이름과 시그니처를 그대로 씁니다. 라이브러리에 없는 동작을 래퍼에서 덧붙이거나 바꾸는 것도 쉬워집니다.
비용은 팀 쪽에서 발생합니다. 래퍼 클래스를 직접 정의하고 유지해야 하며, 새로 합류한 개발자는 어떤 래퍼가 존재하는지 코드에서 찾아야 합니다. 외부에 공개되지 않은 자체 API 라서 문제가 생겨도 검색하거나 물어볼 곳이 없습니다. 교체 가능성, 라이브러리의 불안정성, 팀 규모를 기준으로 감쌀 대상을 고릅니다.
가시성, 문서, 계약 (Item 30, 31, 32)
프로퍼티는 접근자의 가시성을 제한해 캡슐화하는 것이 좋습니다(Item 30). 가시성이 좁을수록 클래스 상태가 어떻게 바뀌는지 추적하기 쉽습니다. 인터페이스가 작으면 배우기도 유지하기도 변경하기도 쉽습니다. 상태를 나타내는 프로퍼티를 공개하면 클래스가 자기 상태를 스스로 책임질 수 없게 됩니다. 단순히 데이터를 저장하는 클래스(데이터 모델, DTO)는 감출 이유가 없으니 예외입니다.
class Counter {
    var count = 0
        private set

    fun increment() { count++ }
}
계약은 이름, 주석과 문서, 객체의 타입으로 정의합니다(Item 31). KDoc 은 /** 로 시작해 */ 로 끝나는 블록 주석이고 안쪽 줄은 보통 * 로 시작합니다. 공식 문서 생성 도구가 Dokka 입니다.
/**
 * 사용자를 이름으로 찾습니다.
 *
 * @param name 비어 있으면 일치하는 사용자가 없는 것으로 봅니다
 * @return 없으면 `null`
 */
fun findUser(name: String): User? = users.firstOrNull { it.name == name }
프로그램을 안정적으로 유지하려면 추상화의 계약을 지켜야 하고 계약을 어길 수밖에 없다면 그 사실을 문서에 남깁니다(Item 32). 예를 들어 HashSet 의 순회 순서는 계약에 없으므로 특정 순서를 가정하고 짠 코드는 구현이 바뀔 때 깨집니다.
참고: Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022, 초판 52개 항목 기준). 이 글은 해당 책의 항목을 요약하고 재해석한 것이며 원문을 인용한 것이 아닙니다.
참고 자료
- Marcin Moskała, 『이펙티브 코틀린』(윤인성 옮김, 인사이트, 2022): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000003160882
- 『코틀린 아카데미: 이펙티브 코틀린』(강진혁·김보경 옮김, 인사이트, 2025, 60개 항목 개정판): https://ebook-product.kyobobook.co.kr/dig/epd/ebook/E000011546361
- Effective Kotlin (Leanpub): https://leanpub.com/effectivekotlin
- Kotlin 문서, Delegated properties: https://kotlinlang.org/docs/delegated-properties.html
- Kotlin 문서, Generics: https://kotlinlang.org/docs/generics.html
- Kotlin 문서, Extensions: https://kotlinlang.org/docs/extensions.html
- Kotlin 문서, Documenting Kotlin code: https://kotlinlang.org/docs/kotlin-doc.html
- Kotlin 문서, Coding conventions: https://kotlinlang.org/docs/coding-conventions.html
- Semantic Versioning: https://semver.org/lang/ko/