우선순위 큐는 “지금 들어 있는 것 중 가장 급한 것”을 계속 꺼내는 큐입니다. 가장 단순하게 만들면 리스트에 쌓아 두고 꺼낼 때마다 최솟값을 찾는 방식인데, 꺼낼 때마다 O(n) 입니다. 정렬된 리스트로 유지하면 꺼내는 쪽은 빠르지만 넣을 때 O(n) 이 됩니다. 힙은 그 중간에서 넣기와 꺼내기를 모두 O(log n) 으로 맞춘 구조입니다. 게다가 포인터 없이 배열 하나로 구현합니다.
정렬된 게 아니라 부모만 보장합니다
힙은 두 가지 조건으로 정의됩니다. 첫째는 모양입니다. 완전 이진 트리여서 마지막 층만 빼고 모든 층이 가득 차 있으며 마지막 층은 왼쪽부터 채워집니다. 둘째는 값입니다. min-heap 이라면 모든 부모가 자식보다 작거나 같아야 하고 이를 힙 속성이라고 부릅니다. 부모가 자식보다 크거나 같으면 max-heap 입니다.
이 속성이 보장하는 것은 부모와 자식 사이의 관계뿐입니다. 형제끼리는 누가 작아도 상관없고 왼쪽 가지가 오른쪽 가지보다 작아야 한다는 규칙도 없습니다. 확실한 것은 루트가 전체의 최솟값이라는 사실, 그리고 두 번째로 작은 값이 루트의 두 자식 중 하나라는 정도입니다. 힙을 앞에서부터 읽는다고 정렬된 결과가 나오지 않는 까닭이 여기에 있습니다.
트리를 배열에 눕히기
완전 이진 트리는 층 순서(위에서 아래, 왼쪽에서 오른쪽)로 읽으면 빈 칸 없이 배열이 됩니다. 중간이 비지 않는다는 완전 이진 트리의 성질 덕분입니다. 인덱스를 0 부터 세면 부모와 자식 위치가 계산으로 나옵니다.
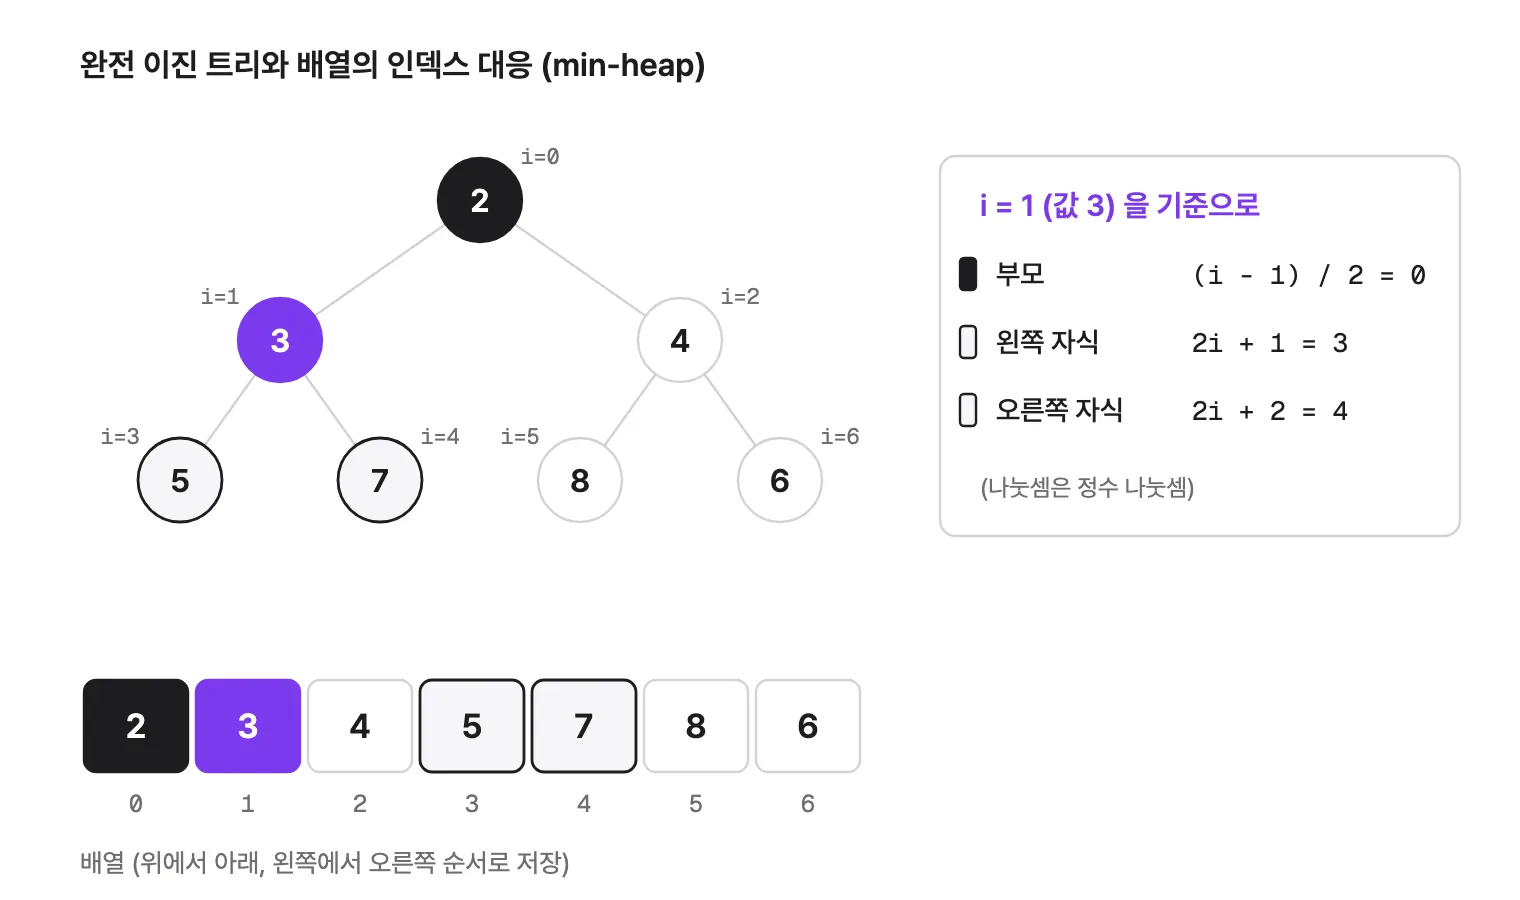
인덱스 i 의 부모는 (i - 1) / 2, 왼쪽 자식은 2i + 1, 오른쪽 자식은 2i + 2 입니다(정수 나눗셈). 노드 객체도 포인터도 없이 연속된 메모리 위에서 계산만으로 오르내립니다. 원소가 n 개일 때 트리의 높이는 ⌊log₂ n⌋ 이고 뒤에 나오는 O(log n) 은 전부 이 높이에서 나옵니다. 인덱스를 1 부터 세는 책도 많은데 그쪽은 부모가 i / 2, 자식이 2i 와 2i + 1 입니다. 이 글의 코드는 모두 0 부터 셉니다.
삽입: 끝에 붙이고 위로 올립니다
새 원소는 일단 배열의 맨 끝, 곧 트리의 다음 빈 자리에 넣습니다. 모양은 그대로 완전 이진 트리지만 힙 속성은 깨졌을 수 있습니다. 부모와 비교해 자기가 더 작으면 자리를 바꾸고 부모보다 크거나 같아지면 멈춥니다. 이 과정을 sift-up 이라고 부릅니다.
아래는 [2, 5, 4, 9, 7, 8, 6] 에 3 을 넣는 장면입니다. 3 은 인덱스 7 에 붙어서 부모 9 와 바뀌고 다시 부모 5 와 바뀐 뒤 루트 2 와 비교해 멈춥니다. 트리와 배열을 나란히 놓았으니 같은 일이 두 모습으로 벌어지는 것을 볼 수 있습니다.
한 번 올라갈 때마다 층이 하나 줄어드니 최악의 비교와 교환은 트리의 높이, 즉 O(log n) 입니다. 평균적으로는 훨씬 적게 올라갑니다. 임의의 값이 들어오면 대부분 맨 아래 근처에서 멈추기 때문입니다.
삭제: 루트를 빼고 마지막 원소를 올려 내립니다
꺼내는 값은 언제나 루트입니다. 루트를 빼면 구멍이 남는데, 트리의 모양을 유지하려면 배열의 마지막 원소가 빠져야 합니다. 그래서 마지막 원소를 루트 자리로 옮기고 배열을 한 칸 줄인 뒤, 이 원소를 아래로 내려 보냅니다. 두 자식 중 작은 쪽과 비교해 자식이 더 작으면 자리를 바꿉니다. 자식 둘 다 크거나 같거나 자식이 없으면 멈춥니다. 이 과정이 sift-down 입니다.
두 자식 중 작은 쪽을 고르는 데에는 이유가 있습니다. 큰 쪽과 바꾸면 올라온 큰 자식이 작은 형제의 부모가 되어 힙 속성이 다시 깨집니다.
이 역시 한 번에 한 층씩 내려가므로 O(log n) 입니다. 여기까지를 Kotlin 으로 옮기면 이 정도입니다.
import java.util.Collections

class MinHeap {
    private val a = ArrayList<Int>()
    val size get() = a.size

    fun peek(): Int = a[0]

    fun add(v: Int) {
        a.add(v)
        var i = a.lastIndex
        while (i > 0) {
            val p = (i - 1) / 2
            if (a[p] <= a[i]) break
            Collections.swap(a, i, p)
            i = p
        }
    }

    fun poll(): Int {
        val top = a[0]
        val last = a.removeAt(a.lastIndex)
        if (a.isNotEmpty()) {
            a[0] = last
            siftDown(0)
        }
        return top
    }

    private fun siftDown(start: Int) {
        var i = start
        while (true) {
            val l = 2 * i + 1
            if (l >= a.size) return
            val c = if (l + 1 < a.size && a[l + 1] < a[l]) l + 1 else l
            if (a[i] <= a[c]) return
            Collections.swap(a, i, c)
            i = c
        }
    }
}
비어 있는 힙에서 peek() 나 poll() 을 부르면 IndexOutOfBoundsException 이 납니다. 여기서는 일부러 방어 코드를 뺐습니다.
배열을 한 번에 힙으로 만들기
원소 n 개를 하나씩 add 하면 O(n log n) 입니다. 이미 배열이 있다면 더 빠른 방법이 있습니다. 배열을 트리로 보고 마지막 부모(인덱스 n / 2 - 1)에서 루트까지 거꾸로 올라가며 노드마다 sift-down 을 한 번씩 적용합니다. 잎 노드는 그 자체로 이미 힙이니 건너뜁니다.
// MinHeap 클래스 안에 추가
fun heapify(values: Collection<Int>) {
    a.clear()
    a.addAll(values)
    for (i in a.size / 2 - 1 downTo 0) siftDown(i)
}
이 방법이 O(n) 인 이유는 내려가야 하는 거리가 노드마다 다르기 때문입니다. 높이 h 에 있는 노드는 최대 h 번 내려갑니다. 그런데 높이가 높은 노드일수록 개수가 극단적으로 적습니다. 잎 근처가 절반을 차지하고 그 위층이 4분의 1 로 줄어드는 식이라 전체 작업량을 더하면 n 의 상수배로 수렴합니다. [9, 7, 8, 1, 2, 3, 4] 에서 시작하면 8 이 3 과 자리를 바꾸고 7 이 1 과 바꿉니다. 9 는 1 과 2 를 차례로 지나 내려가서 [1, 2, 3, 7, 9, 8, 4] 가 됩니다. 힙 정렬의 첫 단계가 바로 이 방식입니다. 이후 루트를 꺼내 결과를 채우는 과정은 정렬 알고리즘 글의 힙 정렬 애니메이션에서 볼 수 있습니다.
복잡도
| 연산 | 시간 |
|---|---|
최솟값 보기 (peek) | O(1) |
삽입 (add) | O(log n) |
최솟값 꺼내기 (poll) | O(log n) |
| 배열로 힙 만들기 (heapify) | O(n) |
| 임의 값 탐색 · 삭제 | O(n) |
| 공간 | O(n) (배열 하나) |
힙은 최솟값(또는 최댓값) 하나를 꺼내는 일을 반복할 때 강합니다. 특정 값을 찾는 일에는 약합니다. 트리 어디에 있는지 규칙이 없어서 전부 훑어야 합니다.
Kotlin 에서는 PriorityQueue
직접 만들 일은 드물어서 JVM 에서는 java.util.PriorityQueue 를 씁니다. Kotlin 표준 라이브러리에는 별칭이 없으니 import 가 필요합니다. 내부는 위에서 만든 것과 같은 배열 기반 이진 힙이라 몇 가지 동작은 알아 둬야 합니다.
기본은 min-heap 이라 원소의 자연 순서(Comparable)에서 가장 작은 것이 peek() 과 poll() 로 나옵니다. Comparable 이 아닌 원소를 비교자 없이 넣으면 ClassCastException 이 납니다. add, offer, poll 은 O(log n) 이고 peek 은 O(1) 이지만 remove(element) 와 contains 는 O(n) 입니다. null 은 넣을 수 없고 값이 같은 원소끼리의 순서는 문서상 임의로 정해지며 스레드 안전하지도 않습니다.
max-heap 이 필요하면 비교자를 뒤집습니다.
import java.util.PriorityQueue

fun main() {
    val min = PriorityQueue<Int>()
    val max = PriorityQueue<Int>(compareByDescending<Int> { it })
    for (v in listOf(5, 1, 4, 2, 3)) {
        min.add(v)
        max.add(v)
    }
    println(min)         // [1, 2, 4, 5, 3]
    println(max)         // [5, 3, 4, 1, 2]
    println(min.poll())  // 1
    println(generateSequence { min.poll() }.toList()) // [2, 3, 4, 5]
}
println(min) 의 결과를 보면 정렬된 [1, 2, 3, 4, 5] 가 아니라 [1, 2, 4, 5, 3] 이 나옵니다. 힙 배열을 그대로 읽은 출력이기 때문입니다. toString() 도 이터레이터도 for 순회도 우선순위 순서를 따르지 않습니다. 순서대로 얻으려면 poll() 을 반복해야 합니다. 로그에 찍힌 큐를 보고 정렬되어 있다고 착각하기 쉬운 부분입니다.
우선순위를 여러 필드로 정하는 일은 흔합니다. 같은 우선순위끼리 들어온 순서를 지키고 싶다면 순번을 하나 따로 둡니다. PriorityQueue 가 알아서 FIFO 로 처리해 주지는 않기 때문입니다.
data class Task(val name: String, val priority: Int, val seq: Long)

val queue = PriorityQueue<Task>(compareBy<Task> { it.priority }.thenBy { it.seq })
생성자에 컬렉션을 넘기면(PriorityQueue(list)) 원소를 하나씩 넣지 않고 heapify 로 한 번에 만듭니다.
힙이 쓰이는 자리
상위 K개 고르기
n 개 중 큰 값 K 개가 필요할 때 전부 정렬하면 O(n log n) 입니다. 대신 크기 K 의 min-heap 을 두고 새 값을 넣을 때마다 K 를 넘으면 최솟값을 버리면 O(n log K) 로 끝납니다. 힙의 루트가 현재 K 번째로 큰 값이라 그보다 작은 값은 들어오자마자 밀려납니다.
fun topK(nums: IntArray, k: Int): List<Int> {
    val heap = PriorityQueue<Int>()
    for (n in nums) {
        heap.add(n)
        if (heap.size > k) heap.poll()
    }
    return heap.sortedDescending()
}
K 가 n 보다 훨씬 작거나 데이터가 스트림으로 들어올 때 특히 잘 맞습니다.
다익스트라
가중치가 음수가 아닌 그래프의 최단 거리는 지금까지 거리가 가장 짧은 노드부터 확정하는 방식으로 구합니다. 그 노드를 꺼내는 자리에 min-heap 이 들어갑니다. PriorityQueue 에는 이미 들어간 원소의 값을 낮추는 연산(decrease-key)이 없습니다. 그래서 더 짧은 경로를 찾으면 새 항목을 추가하고 나중에 꺼낼 때 오래된 항목은 건너뜁니다.
fun dijkstra(graph: List<List<Pair<Int, Int>>>, src: Int): IntArray {
    val dist = IntArray(graph.size) { Int.MAX_VALUE }
    dist[src] = 0
    val pq = PriorityQueue<Pair<Int, Int>>(compareBy<Pair<Int, Int>> { it.first })
    pq.add(0 to src)
    while (pq.isNotEmpty()) {
        val (d, u) = pq.poll()
        if (d > dist[u]) continue
        for ((v, w) in graph[u]) {
            if (d + w < dist[v]) {
                dist[v] = d + w
                pq.add(dist[v] to v)
            }
        }
    }
    return dist
}
graph[u] 는 (이웃 노드, 가중치) 목록이고 큐에는 (거리, 노드) 를 넣습니다. 간선 하나가 큐에 한 번씩만 들어가므로 간선 수를 E, 노드 수를 V 라고 하면 O(E log V) 입니다.
작업 스케줄링
가장 급한 작업부터 처리하든 실행 시각이 가장 이른 작업부터 처리하든 구조는 같습니다. 우선순위나 실행 시각을 키로 삼아 힙에 넣고 루트만 확인합니다. JDK 의 DelayQueue 도 내부에 PriorityQueue 를 두고 만료 시각이 가장 이른 원소를 맨 앞에 둡니다.
쓸 만한 상황 판단
최솟값이나 최댓값을 반복해서 꺼내야 한다면 힙이 맞고 전체가 정렬된 상태가 필요하면 한 번 정렬하는 편이 낫습니다. 중간 원소를 찾거나 지워야 하거나 범위 조회가 필요하면 TreeMap 처럼 정렬을 유지하는 맵이 더 어울립니다. 힙이 빠른 것은 맨 앞 하나뿐이니 그 하나가 필요한 문제에 쓰면 됩니다.