정렬은 면접 단골 주제입니다. 실제로는 sortedBy { } 같은 라이브러리 함수를 호출하는 경우가 대부분이지만, 라이브러리가 내부에서 무엇을 하는지, 어떤 정렬이 안정적이고 어떤 정렬이 최악에 무너지는지는 알고리즘에서 갈립니다. 이 글에서는 버블·선택·삽입·병합·퀵·힙 정렬을 같은 입력 16개 숫자로 돌려 보며 하나씩 비교합니다.
읽기 전에 용어 세 개
시간 복잡도는 입력 크기 n 이 커질 때 연산 횟수가 얼마나 빨리 늘어나는지를 말합니다. best, average, worst 로 나눠서 봅니다. 공간 복잡도는 입력 말고 추가로 필요한 메모리입니다. 추가 메모리가 O(1) 이면 제자리(in-place) 정렬이라고 부르는데, 재귀 스택 정도인 O(log n) 까지 같은 범주로 치는 경우도 있습니다.
안정 정렬(stable)은 값이 같은 원소끼리 원래 순서가 유지되는 정렬입니다. 이름순으로 정렬한 다음 점수순으로 다시 정렬했을 때 같은 점수끼리 이름순이 남아 있어야 하는 다단계 정렬에서 이 성질이 필요합니다.
아래 애니메이션은 전부 같은 입력으로 만들었습니다. 색은 이렇게 읽으시면 됩니다.
- 보라색(
#7C3AED): 비교 중인 막대 - 파란색: 교환했거나 값을 쓴(write) 막대
- 검은색: 피벗(퀵 정렬)이나 현재 최솟값(선택 정렬)
- 짙은 회색: 최종 위치가 확정된 막대
- 흐릿한 막대: 현재 작업 범위 밖 (병합·퀵 정렬)
모든 구현이 공통으로 쓰는 교환 함수는 이것입니다.
private fun IntArray.swap(i: Int, j: Int) {
    val t = this[i]; this[i] = this[j]; this[j] = t
}
버블 정렬
가장 먼저 배우고 가장 먼저 잊어버리는 정렬입니다. 이웃한 두 원소를 비교해서 순서가 틀리면 바꿉니다. 이걸 끝까지 반복하면 한 바퀴마다 가장 큰 값이 맨 뒤로 떠오릅니다. 0번부터 n-2 번까지 a[j] 와 a[j+1] 을 비교해 a[j] > a[j+1] 이면 교환합니다. 한 패스가 끝나면 맨 뒤 원소는 확정이니 범위를 하나 줄여 다시 돕니다. 한 패스 동안 교환이 한 번도 없었다면 이미 정렬된 것이라 거기서 멈춥니다.
fun bubbleSort(a: IntArray) {
    for (i in 0 until a.size - 1) {
        var swapped = false
        for (j in 0 until a.size - 1 - i) {
            if (a[j] > a[j + 1]) {
                a.swap(j, j + 1)
                swapped = true
            }
        }
        if (!swapped) break
    }
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n) (조기 종료 시) | O(n²) | O(n²) | O(1) | 안정 |
같은 값은 > 로만 교환하니 서로 순서가 바뀌지 않아 안정 정렬입니다. 장점은 구현이 쉽다는 점입니다.
선택 정렬
선택 정렬은 아직 정렬되지 않은 구간에서 최솟값을 찾아 그 구간의 맨 앞과 바꾸는 방식입니다. i 번째부터 끝까지 훑어 최솟값의 위치를 찾고(애니메이션의 검은 막대), 그 값을 i 번째와 교환하면 i 가 확정됩니다. 그다음 i 를 하나 늘려 같은 일을 반복합니다.
fun selectionSort(a: IntArray) {
    for (i in 0 until a.size - 1) {
        var min = i
        for (j in i + 1 until a.size) {
            if (a[j] < a[min]) min = j
        }
        if (min != i) a.swap(i, min)
    }
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n²) | O(n²) | O(n²) | O(1) | 불안정 |
입력이 이미 정렬되어 있어도 비교 횟수는 똑같이 n(n-1)/2 입니다. 버블 정렬처럼 일찍 끝낼 방법이 없습니다. 대신 교환은 많아야 n-1 번이라서 쓰기 비용이 유난히 비싼 환경이라면 쓸 만합니다.
불안정한 이유는 멀리 떨어진 원소와 자리를 바꾸기 때문입니다. [5a, 5b, 2] 에서 2 와 5a 를 교환하면 [2, 5b, 5a] 가 되어 두 5 의 순서가 뒤집힙니다.
삽입 정렬
카드 게임에서 손에 든 카드를 정리하는 방식 그대로입니다. 왼쪽에는 정렬된 구간이 있습니다. 새 원소를 그 안의 알맞은 자리에 끼워 넣습니다. i = 1 부터 시작해 a[i] 를 key 로 잡습니다. 왼쪽에서 key 보다 큰 원소들을 한 칸씩 오른쪽으로 민 다음 비워진 자리에 key 를 넣습니다.
애니메이션은 보기 쉽게 “이웃과 교환”으로 그렸습니다. 실제 코드는 아래처럼 밀기(shift)만 하다가 마지막에 한 번만 씁니다.
fun insertionSort(a: IntArray) {
    for (i in 1 until a.size) {
        val key = a[i]
        var j = i - 1
        while (j >= 0 && a[j] > key) {
            a[j + 1] = a[j]
            j--
        }
        a[j + 1] = key
    }
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n) | O(n²) | O(n²) | O(1) | 안정 |
이미 거의 정렬된 입력이면 O(n) 에 가깝게 끝나고 상수도 작아서 원소가 적을 때는 O(n log n) 알고리즘보다 빠른 경우가 많습니다. 병합 정렬이나 퀵 정렬의 실제 구현이 작은 구간을 삽입 정렬로 마무리하는 하이브리드 형태를 자주 쓰는 것도 이 때문입니다. O(n²) 정렬 세 개 중에서 실전에서 살아남은 것은 이쪽입니다.
병합 정렬
병합 정렬은 분할 정복의 교과서입니다. 배열을 반으로 나눠 각각 정렬한 뒤 정렬된 두 배열을 합칩니다(merge). 길이가 1 이하면 이미 정렬된 것이니 재귀가 거기서 끝납니다. 합칠 때는 두 배열의 앞에서부터 작은 쪽을 골라 결과 배열에 옮겨 담으면 됩니다.
fun mergeSort(a: IntArray): IntArray {
    if (a.size <= 1) return a
    val mid = a.size / 2
    val left = mergeSort(a.copyOfRange(0, mid))
    val right = mergeSort(a.copyOfRange(mid, a.size))

    val result = IntArray(a.size)
    var i = 0
    var j = 0
    var k = 0
    while (i < left.size && j < right.size) {
        result[k++] = if (left[i] <= right[j]) left[i++] else right[j++]
    }
    while (i < left.size) result[k++] = left[i++]
    while (j < right.size) result[k++] = right[j++]
    return result
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n log n) | O(n log n) | O(n log n) | O(n) | 안정 |
left[i] <= right[j] 에서 같을 때 왼쪽을 먼저 넣기 때문에 안정입니다. 입력이 어떻게 생겼든 O(n log n) 이 보장되는 대신 추가 메모리 O(n) 이 듭니다. 연결 리스트 정렬이나 디스크의 큰 파일을 다루는 외부 정렬과도 잘 맞습니다.
퀵 정렬
퀵 정렬은 피벗(pivot) 하나를 골라 피벗보다 작은 쪽과 큰 쪽으로 나누고(partition), 양쪽을 재귀적으로 정렬합니다. 나누기가 끝난 시점에 피벗은 이미 최종 위치에 있습니다.
아래 구현은 마지막 원소를 피벗으로 쓰는 Lomuto 방식입니다. 피벗을 잡고 i = lo 로 시작해 lo 부터 훑으면서 피벗보다 작은 원소를 i 위치로 보내고 i 를 올립니다. 마지막에 피벗을 i 와 교환하면 피벗이 제자리(짙은 회색)에 놓입니다. 그 왼쪽과 오른쪽에는 같은 일을 반복합니다.
fun quickSort(a: IntArray, lo: Int = 0, hi: Int = a.lastIndex) {
    if (lo >= hi) return
    val pivot = a[hi]
    var i = lo
    for (j in lo until hi) {
        if (a[j] < pivot) a.swap(i++, j)
    }
    a.swap(i, hi)
    quickSort(a, lo, i - 1)
    quickSort(a, i + 1, hi)
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n log n) | O(n log n) | O(n²) | O(log n) 평균 / O(n) 최악 (재귀 깊이) | 불안정 |
퀵 정렬의 약점은 피벗 선택입니다. 이미 정렬된 배열에서 마지막 원소를 피벗으로 쓰면 매번 한쪽으로만 쪼개져 O(n²) 이 됩니다. 값이 전부 같은 배열도 이 Lomuto 구현에서는 한쪽으로만 쪼개지기 때문에 O(n²) 입니다. 재귀 깊이도 O(n) 이 되어 큰 입력에서는 StackOverflowError 가 날 수 있습니다. 실제 구현은 랜덤 피벗이나 중앙값 3개(median-of-three) 같은 방법으로 이런 경우를 피합니다.
그런 약점을 안고도 평균적으로 매우 빠른 이유는 캐시 지역성이 좋기 때문입니다. 불안정한 것은 먼 거리 교환 탓입니다.
힙 정렬
배열을 최대 힙으로 만든 다음, 루트(최댓값)를 맨 뒤로 보내고 힙 크기를 줄이면서 힙 조건을 복구하는 방식입니다. 먼저 n/2 - 1 부터 0까지 siftDown 을 돌려 최대 힙을 만들고(이 단계가 O(n) 입니다), 루트와 힙의 마지막 원소를 교환해 마지막 자리를 확정합니다(짙은 회색). 힙 크기를 1 줄이고 루트에서 siftDown 으로 힙을 복구하는 일을 힙이 빌 때까지 반복합니다.
fun heapSort(a: IntArray) {
    val n = a.size
    for (i in n / 2 - 1 downTo 0) siftDown(a, i, n)
    for (end in n - 1 downTo 1) {
        a.swap(0, end)
        siftDown(a, 0, end)
    }
}

private fun siftDown(a: IntArray, start: Int, size: Int) {
    var i = start
    while (true) {
        val left = 2 * i + 1
        val right = left + 1
        var largest = i
        if (left < size && a[left] > a[largest]) largest = left
        if (right < size && a[right] > a[largest]) largest = right
        if (largest == i) return
        a.swap(i, largest)
        i = largest
    }
}| best | average | worst | 공간 | 안정 |
|---|---|---|---|---|
| O(n log n) | O(n log n) | O(n log n) | O(1) | 불안정 |
최악에도 O(n log n) 이고 추가 메모리도 O(1) 이라는 점이 힙 정렬의 장점입니다. 표에는 best 도 O(n log n) 으로 적었지만 모든 값이 같으면 O(n) 입니다. 다만 메모리 접근이 흩어져서 캐시 효율이 떨어지므로 실제로는 퀵 정렬보다 느린 경우가 많습니다.
복잡도 차이는 얼마나 클까
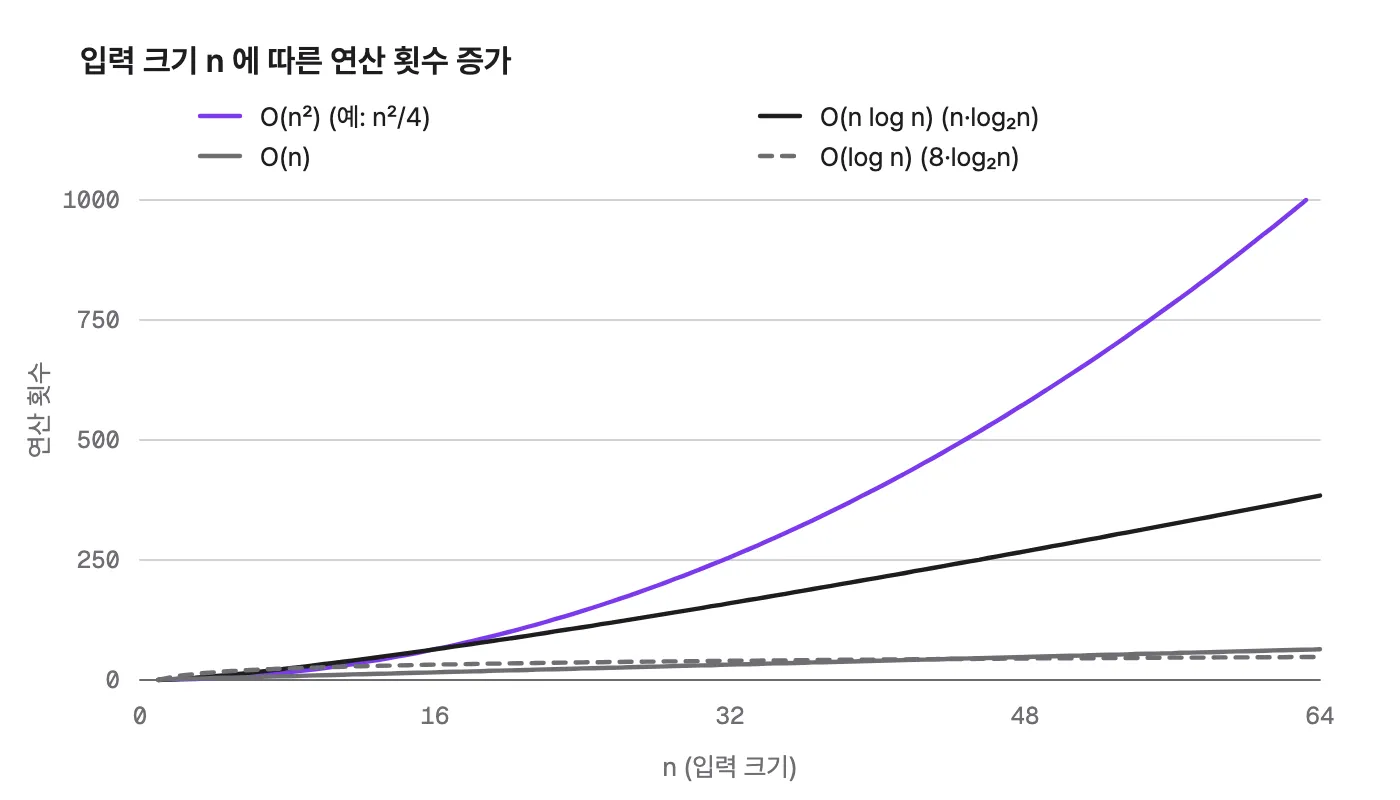
n 이 커지면 O(n²) 와 O(n log n) 은 금방 비교가 안 되는 수준으로 벌어집니다. 아래 그래프에서 보라색 곡선(n²)이 검은색 곡선(n log n)에서 갈라져 올라가는 모습을 볼 수 있습니다. n = 1,000,000 이면 n² 은 약 10¹², n log₂ n 은 약 2×10⁷ 이니 약 5만 배 차이입니다. 그래프는 곡선을 같이 보여 주려고 n²/4, 8·log₂n 으로 스케일을 맞췄습니다.
여섯 개를 한 표로
| 알고리즘 | best | average | worst | 공간 | 안정 | 비고 |
|---|---|---|---|---|---|---|
| 버블 | O(n) | O(n²) | O(n²) | O(1) | 안정 | 조기 종료 필요 |
| 선택 | O(n²) | O(n²) | O(n²) | O(1) | 불안정 | 교환 횟수 최소 |
| 삽입 | O(n) | O(n²) | O(n²) | O(1) | 안정 | 거의 정렬된 입력·소량에 강함 |
| 병합 | O(n log n) | O(n log n) | O(n log n) | O(n) | 안정 | 성능 보장, 추가 메모리 |
| 퀵 | O(n log n) | O(n log n) | O(n²) | O(log n)~O(n) | 불안정 | 평균적으로 가장 빠른 편 |
| 힙 | O(n log n) | O(n log n) | O(n log n) | O(1) | 불안정 | 최악 보장 + 제자리 |
그래서 실무에서는
표준 라이브러리가 정렬을 제공합니다. 라이브러리가 무엇을 쓰는지는 아래와 같습니다.
Kotlin 의 sorted(), sortedBy {}, sortedWith() 는 정렬된 새 리스트를 돌려줍니다. JVM 에서는 내부적으로 java.util.Arrays.sort 계열을 쓰는데 객체 정렬은 TimSort 입니다. IntArray.sorted() 도 박싱된 배열을 정렬하므로 TimSort 경로를 탑니다.
TimSort 는 병합 정렬과 삽입 정렬을 섞은 하이브리드입니다. 이미 정렬된 구간(run)을 찾아서 병합하는 방식이라 안정 정렬입니다. 최악은 O(n log n), 이미 정렬된 입력에서는 O(n) 에 가깝고 추가 메모리는 최대 O(n) 입니다. 안정 정렬이어서 sortedBy { it.name } 으로 정렬한 뒤 sortedBy { it.score } 를 하면 점수가 같은 원소끼리는 이름 순서가 유지됩니다.
IntArray.sort() 같은 원시 타입 배열은 JVM 에서 Arrays.sort(int[]) 가 쓰이는데 이쪽은 듀얼 피벗 퀵 정렬(Dual-Pivot Quicksort)입니다. 원시 값은 같은 값끼리 구분할 수 없으니 안정성이 필요 없어서 퀵 계열을 쓸 수 있습니다. JDK 14 이후 구현은 재귀가 지나치게 깊어지면 힙 정렬로 전환해서 최악의 경우를 막습니다. Arrays.sort(int[]) 문서는 JDK 14 부터 “O(n log(n)) performance on all data sets” 라고 적습니다. Android 는 OS 버전별 libcore 기준이 달라서 이 부분은 다를 수 있습니다.
여기까지는 JVM 기준입니다. Kotlin/Native 나 Kotlin/JS 에서는 플랫폼별 구현이 다를 수 있습니다.
직접 골라야 하는 상황의 기준은 아래 표와 같습니다.
| 상황 | 추천 |
|---|---|
| 일반적인 정렬 | 라이브러리(sorted(), sort()) |
| 원소가 아주 적거나 거의 정렬됨 | 삽입 정렬 |
| 안정성 + 최악 성능 보장 | 병합 정렬 (TimSort) |
추가 메모리 없이 최악도 O(n log n) | 힙 정렬 |
| 평균 속도가 최우선(원시 타입) | 퀵 정렬 계열 |
| 쓰기 횟수를 최소화해야 함 | 선택 정렬 |
마치며
여섯 가지를 나란히 놓고 보면 결론은 단순합니다. 버블·선택·삽입은 작은 입력에서만 의미가 있습니다. 그중에서 삽입 정렬만 하이브리드의 일부로 실전에 남아 있습니다. 병합·퀵·힙은 강점이 서로 다릅니다. 병합은 안정성과 최악 보장, 퀵은 평균 속도, 힙은 추가 메모리 없는 최악 보장입니다.
고를 때는 안정성이 필요한지, 추가 메모리를 쓸 수 있는지, 최악의 경우를 보장해야 하는지를 먼저 물어보면 됩니다. 일반적인 경우에는 라이브러리 정렬이 이 선택을 대신합니다. 다음 글은 탐색 알고리즘(선형·이진·BFS·DFS)입니다.