배열, 리스트, 스택, 큐는 원소를 한 줄로 세웁니다. 파일 시스템의 폴더, 화면의 뷰 계층, JSON 문서처럼 무언가의 아래에 여러 개가 달리는 데이터를 한 줄에 세우면 관계가 사라집니다. 트리는 이런 계층 관계를 그대로 담는 구조이고 자식이 최대 둘인 이진 트리에 대소 규칙을 얹으면 탐색용 자료구조가 됩니다. 용어부터 시작해 이진 탐색 트리의 연산, 순회, 한쪽으로 쏠리는 문제까지 차례로 봅니다.
트리 용어
트리는 노드(node)와 노드를 잇는 간선(edge)으로 이루어지고 사이클이 없으며 모든 노드가 연결된 구조입니다. 맨 위의 노드가 루트(root)이고 루트를 뺀 모든 노드는 부모(parent)가 정확히 하나입니다. 부모 아래에 달린 노드는 자식(child), 부모가 같은 노드끼리는 형제(sibling)라 하고 자식이 없는 노드를 리프(leaf, 단말 노드)라고 부릅니다.
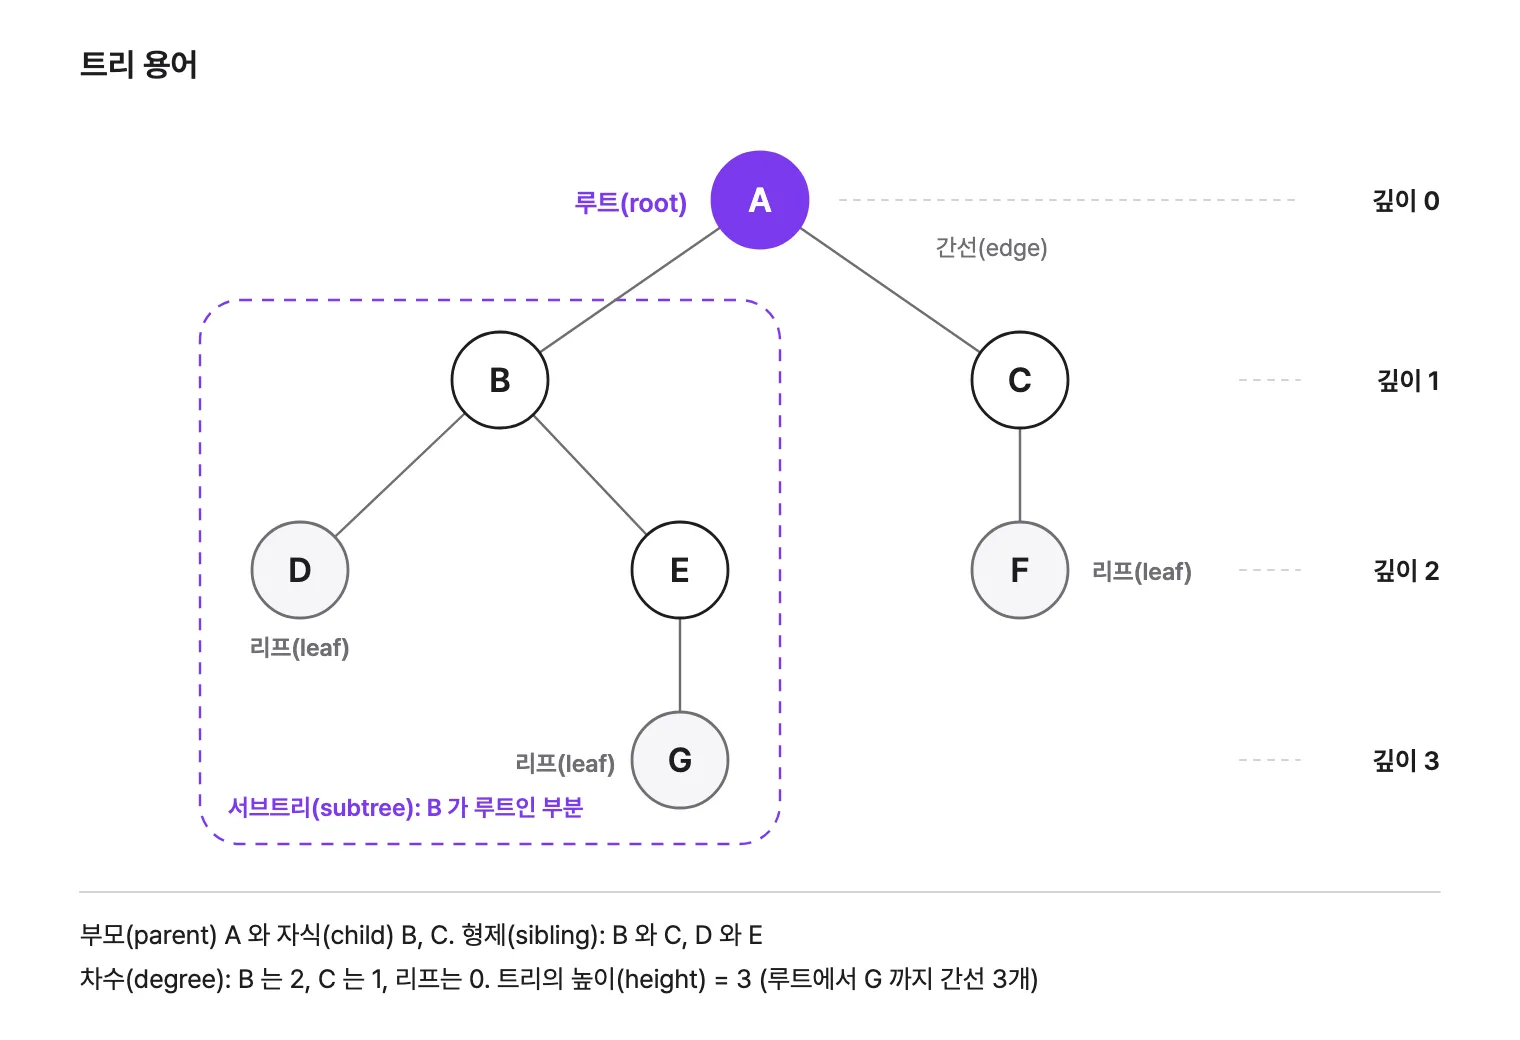
수치를 나타내는 용어는 기준에 따라 값이 달라지므로 정의를 맞춰 두어야 합니다.
깊이(depth)는 루트에서 그 노드까지 내려가는 간선의 수이고 루트의 깊이는 0 입니다. 높이(height)는 거꾸로 그 노드에서 가장 깊은 리프까지의 간선 수를 말하며 트리의 높이는 루트의 높이와 같습니다. 그림의 트리는 A 에서 G 까지 간선이 3 개라서 높이가 3 입니다. 차수(degree)는 노드가 가진 자식의 수입니다. B 는 2, C 는 1, 리프는 0 이고 트리 전체의 차수는 노드 차수 중 최댓값입니다. 책에 따라 루트의 깊이를 1 로 세거나 노드 수로 높이를 재기도 하니, 문제를 풀 때는 어느 정의를 따르는지 먼저 확인해야 합니다. 이 글은 간선 수를 기준으로 합니다.
한 노드와 그 아래의 모든 노드를 묶으면 그 자체로 하나의 트리가 되어서 서브트리(subtree)라고 합니다. 트리 알고리즘에 재귀가 많은 것도 이 때문입니다. 전체 문제를 왼쪽 서브트리와 오른쪽 서브트리의 같은 모양 문제로 쪼갤 수 있습니다.
이진 트리의 종류
이진 트리(binary tree)는 모든 노드의 자식이 최대 둘이고 둘을 왼쪽 자식과 오른쪽 자식으로 구분합니다. 모양에 따라 이름이 붙습니다.
포화 이진 트리는 모든 리프가 같은 깊이에 있고 리프가 아닌 노드는 자식이 정확히 둘입니다. 가득 찬 모양이며 높이가 h 면 노드 수는 2^(h+1) - 1 입니다. 완전 이진 트리는 마지막 층을 뺀 모든 층이 가득 차 있고 마지막 층은 왼쪽부터 빈틈없이 채워진 모양입니다. 노드가 n 개일 때 높이가 ⌊log₂ n⌋ 로, 이진 트리가 가질 수 있는 가장 낮은 높이입니다. 편향 트리는 모든 노드의 자식이 한쪽뿐이라 연결 리스트나 다름없고 높이가 n - 1 입니다. 뒤에서 문제가 되는 쪽은 이 편향 트리입니다. 자식이 0 개 또는 2 개인 트리는 정 이진 트리(full, proper binary tree)라고 합니다. 다만 영어 용어는 교재마다 다릅니다. NIST 사전은 포화 이진 트리를 perfect binary tree 로, full 은 정 이진 트리로 쓰지만, 국내 교재가 많이 따르는 Horowitz·Sahni 계열은 포화 이진 트리를 full binary tree 라 부르고 일부 저자는 perfect 를 complete 라고도 합니다. 영어 용어를 볼 때는 정의를 함께 확인해야 합니다.
노드 클래스는 키 하나와 자식 참조 둘이면 됩니다.
class TreeNode(val key: Int) {
    var left: TreeNode? = null
    var right: TreeNode? = null
}
연결 리스트의 next 가 둘로 갈라진 모양입니다.
이진 탐색 트리
이진 탐색 트리(BST)는 이진 트리에 규칙 하나를 더한 구조입니다. 모든 노드에서 왼쪽 서브트리의 키는 그 노드보다 작고 오른쪽 서브트리의 키는 그 노드보다 큽니다. 자식끼리만이 아니라 서브트리 전체에 적용되는 규칙이어서 트리가 고르게 퍼져 있다면 노드 하나와 비교할 때마다 후보의 절반 가까이를 버릴 수 있습니다.
탐색은 루트에서 출발합니다. 찾는 키가 작으면 왼쪽, 크면 오른쪽으로 내려가다가 같은 키를 만나거나 null 에 닿으면 끝납니다.
class Bst {
    var root: TreeNode? = null
        private set

    fun contains(key: Int): Boolean {
        var cur = root
        while (cur != null) {
            cur = when {
                key < cur.key -> cur.left
                key > cur.key -> cur.right
                else -> return true
            }
        }
        return false
    }

    fun insert(key: Int) {
        root = insert(root, key)
    }

    private fun insert(node: TreeNode?, key: Int): TreeNode {
        if (node == null) return TreeNode(key)
        if (key < node.key) node.left = insert(node.left, key)
        else if (key > node.key) node.right = insert(node.right, key)
        return node
    }
}
삽입
삽입은 탐색과 같은 길로 내려가다가 비어 있는 자리에 새 리프를 붙이는 일입니다. 아래 애니메이션은 빈 트리에 8, 3, 10, 1, 6, 14, 4 를 차례로 넣는 장면입니다. 키가 비교를 거치는 노드는 보라색으로, 도착한 빈 자리에 붙는 새 노드는 검은 테두리로 보입니다.
코드의 insert 는 재귀로 내려가고 돌아오는 길에 node.left = ... 로 자식 참조를 다시 대입합니다. 대부분은 같은 노드를 그대로 대입하는 것이라 아무 변화가 없고 비어 있던 자리에서만 새 노드로 바뀝니다. 같은 키가 이미 있으면 아무 일도 하지 않으므로 이 구현은 중복을 받지 않는 집합처럼 동작합니다.
삭제
삭제는 세 경우로 나뉘며 마지막이 까다롭습니다. 위 애니메이션이 완성한 트리(8 이 루트, 3 과 10 이 자식, 3 아래 1 과 6, 6 아래 4, 10 아래 14)로 하나씩 확인합니다.
자식이 없는 리프는 그냥 떼어 냅니다. 4 를 지우면 6 의 왼쪽이 비게 될 뿐입니다. 자식이 하나인 노드는 그 자식이 자리를 이어받습니다. 10 을 지우면 그 자리에 14 가 올라오고 14 는 10 의 오른쪽 서브트리에 있었으니 8 보다도 커서 규칙이 유지됩니다.
자식이 둘이면 자리를 대신할 노드가 필요합니다. 규칙을 깨지 않는 후보는 왼쪽 서브트리의 최댓값(중위 선행자, in-order predecessor)이나 오른쪽 서브트리의 최솟값(중위 후속자, in-order successor)입니다. 이 글은 후속자를 씁니다. 후속자는 삭제할 노드보다 큰 값 중 최솟값이라 오른쪽 서브트리의 나머지 키보다 작고 왼쪽 서브트리의 모든 키보다 큽니다. 후속자는 왼쪽 자식이 없으므로 일반적으로는 리프이거나 오른쪽 자식 하나만 가진 경우가 되고, 둘 다 앞의 쉬운 경우로 처리됩니다. 3 을 지운다면 오른쪽 서브트리 6 → 4 에서 최솟값 4 가 3 의 자리로 올라가고 원래 4 가 있던 자리는 앞의 리프 경우로 지웁니다. 결과는 4 아래에 1 과 6 이 달린 모양입니다.
// Bst 클래스 안에 추가
fun remove(key: Int) {
    root = remove(root, key)
}

private fun remove(node: TreeNode?, key: Int): TreeNode? {
    if (node == null) return null
    if (key < node.key) {
        node.left = remove(node.left, key)
        return node
    }
    if (key > node.key) {
        node.right = remove(node.right, key)
        return node
    }
    val left = node.left ?: return node.right
    val right = node.right ?: return left
    val successor = minNode(right)
    return TreeNode(successor.key).also {
        it.left = left
        it.right = remove(right, successor.key)
    }
}

private fun minNode(node: TreeNode): TreeNode = node.left?.let { minNode(it) } ?: node
val left = node.left ?: return node.right 한 줄이 자식이 없는 경우와 오른쪽 자식만 있는 경우를, 다음 줄이 왼쪽 자식만 있는 경우를 처리합니다. 후속자를 찾는 코드는 자식이 둘 다 있을 때만 실행됩니다.
순회
트리는 한 줄로 늘어서 있지 않아서 모든 노드를 한 번씩 방문하는 순서가 여러 가지입니다. 깊이 우선으로 가는 세 방식은 루트를 언제 방문하느냐로 갈립니다. 전위(pre-order)는 루트, 왼쪽, 오른쪽 순이고 중위(in-order)는 왼쪽, 루트, 오른쪽, 후위(post-order)는 왼쪽, 오른쪽, 루트 순입니다. 너비 우선인 레벨 순회(level-order)는 위층부터 층마다 왼쪽에서 오른쪽으로 방문합니다. 아래 애니메이션은 같은 트리에 네 방식을 차례로 적용합니다. 노드 옆의 작은 숫자가 방문 순서입니다.
| 순회 | 결과 |
|---|---|
| 전위 | 8 3 1 6 4 10 14 |
| 중위 | 1 3 4 6 8 10 14 |
| 후위 | 1 4 6 3 14 10 8 |
| 레벨 | 8 3 10 1 6 14 4 |
깊이 우선 세 방식은 서브트리 처리를 그대로 옮긴 재귀 코드입니다. 세 함수의 차이는 visit 을 호출하는 위치 하나뿐입니다.
fun preorder(node: TreeNode?, visit: (Int) -> Unit) {
    if (node == null) return
    visit(node.key)
    preorder(node.left, visit)
    preorder(node.right, visit)
}

fun inorder(node: TreeNode?, visit: (Int) -> Unit) {
    if (node == null) return
    inorder(node.left, visit)
    visit(node.key)
    inorder(node.right, visit)
}

fun postorder(node: TreeNode?, visit: (Int) -> Unit) {
    if (node == null) return
    postorder(node.left, visit)
    postorder(node.right, visit)
    visit(node.key)
}
레벨 순회는 재귀로 쓰기 어렵고 큐가 필요합니다. 꺼낸 노드의 자식을 큐 뒤에 넣어 두면 같은 층의 노드가 다음 층보다 항상 앞에 서게 됩니다. 그래프 BFS 와 같은 모양입니다.
fun levelOrder(root: TreeNode?): List<Int> {
    val out = mutableListOf<Int>()
    val queue = ArrayDeque<TreeNode>()
    root?.let { queue.addLast(it) }
    while (queue.isNotEmpty()) {
        val node = queue.removeFirst()
        out += node.key
        node.left?.let { queue.addLast(it) }
        node.right?.let { queue.addLast(it) }
    }
    return out
}
네 순회 모두 노드를 한 번씩 방문하니 시간은 O(n) 입니다. 쓰이는 자리는 각각 다릅니다. 이진 탐색 트리를 중위로 돌면 키가 오름차순으로 나옵니다. 규칙이 “왼쪽은 작고 오른쪽은 크다”이기 때문입니다. 후위는 자식을 모두 처리한 뒤에 부모를 처리해야 하는 작업, 예를 들어 서브트리 크기 계산이나 노드 삭제에 맞습니다. 전위는 부모를 먼저 만들어야 자식을 붙일 수 있는 복사와 직렬화에 쓰입니다.
재귀 순회에는 한계가 있습니다. 재귀 깊이가 트리의 높이와 같아서 한쪽으로 심하게 치우친 트리에서는 호출 스택이 한도를 넘을 수 있습니다. 그때는 호출 스택이 하던 일을 직접 만든 스택에 맡겨 반복문으로 바꿉니다.
한쪽으로 쏠리면 연결 리스트가 됩니다
이진 탐색 트리의 탐색, 삽입, 삭제는 루트에서 리프 방향으로 한 번 내려가는 일이라 시간이 트리의 높이에 비례합니다. 높이가 log n 이면 O(log n), n 이면 O(n) 입니다. 같은 키 집합이라도 넣는 순서에 따라 모양이 달라집니다.
fun height(node: TreeNode?): Int =
    if (node == null) -1 else 1 + maxOf(height(node.left), height(node.right))

val skewed = Bst()
for (k in 1..7) skewed.insert(k)
println(height(skewed.root)) // 6

val balanced = Bst()
for (k in listOf(4, 2, 6, 1, 3, 5, 7)) balanced.insert(k)
println(height(balanced.root)) // 2
빈 트리의 높이를 -1 로 두는 것은 간선 수 기준에 맞춘 관례입니다.
1 부터 7 까지를 오름차순으로 넣으면 매번 오른쪽 끝에 붙어서 높이 6 의 사슬이 됩니다. 같은 키를 가운데부터 넣으면 높이 2 의 포화 트리가 됩니다. 이미 정렬된 데이터가 들어오는 상황은 드물지 않아서 평범한 이진 탐색 트리를 그대로 쓰기에는 최악의 경우가 너무 가깝습니다. 키를 무작위 순서로 넣으면 높이의 기댓값이 O(log n)(약 4.311·ln n ≈ 3·log₂ n)이고 탐색 한 번의 평균 비교 횟수는 약 1.39·log₂ n 이라고 알려져 있지만, 입력 순서를 통제할 수 없다면 보장은 아닙니다.
이 문제를 푸는 것이 self-balancing 트리입니다. 삽입이나 삭제가 끝날 때마다 구조를 점검하고, 어긋나면 노드를 회전시켜 모양을 바로잡습니다. AVL 트리는 모든 노드에서 왼쪽과 오른쪽 서브트리의 높이 차가 1 이하여야 한다는 엄격한 규칙을 유지합니다. Red-Black 트리는 노드에 빨강과 검정을 칠하는 규칙으로 가장 긴 경로가 가장 짧은 경로의 두 배를 넘지 않게 묶어서 높이를 O(log n) 으로 지킵니다. 둘 다 탐색, 삽입, 삭제가 최악에도 O(log n) 입니다. 회전 규칙의 세부는 이 글의 범위를 벗어납니다.
Java TreeMap
JVM 에서는 직접 구현할 필요 없이 java.util.TreeMap 과 TreeSet 이 Red-Black 트리를 씁니다. 키를 정렬된 상태로 유지하고 get, put, remove 가 O(log n) 입니다. Kotlin 의 sortedMapOf() 도 내부에서는 TreeMap 을 만들지만 반환 타입이 SortedMap 이라서, 아래의 floorKey 처럼 NavigableMap 에 있는 메서드를 쓰려면 TreeMap 을 직접 만들어야 합니다.
import java.util.TreeMap

val scores = TreeMap(mapOf(10 to "a", 30 to "b", 20 to "c"))
println(scores.keys) // [10, 20, 30]
println(scores.floorKey(25)) // 20
println(scores.ceilingKey(25)) // 30
println(scores.headMap(20)) // {10=a}
순서가 필요 없고 키 하나로 찾기만 한다면 평균 O(1) 인 해시 테이블이 더 빠릅니다. TreeMap 은 키 순서대로 순회하거나 “25 이하의 가장 큰 키”, 구간 조회처럼 정렬 순서가 필요한 질문에 답할 수 있다는 점에서 의미가 있습니다.
복잡도
| 구조 | 탐색 | 삽입 | 삭제 |
|---|---|---|---|
| 이진 탐색 트리 (평균) | O(log n) | O(log n) | O(log n) |
| 이진 탐색 트리 (최악, 편향) | O(n) | O(n) | O(n) |
| self-balancing 트리 (AVL, Red-Black) | O(log n) | O(log n) | O(log n) |
평균 행은 키가 무작위 순서로 들어왔을 때의 기댓값입니다. 삭제가 섞인 긴 작업열에서는 후속자 삭제가 트리를 한쪽으로 기울게 만든다는 점이 알려져 있어 평균 행은 무작위 삽입 기준으로 읽어야 합니다. 모든 구조의 공간은 노드 하나당 객체 하나와 참조 둘이어서 O(n) 입니다.
참고 자료
- NIST DADS — depth — https://xlinux.nist.gov/dads/HTML/depth.html
- NIST DADS — height — https://xlinux.nist.gov/dads/HTML/height.html
- NIST DADS — degree — https://xlinux.nist.gov/dads/HTML/degree.html
- NIST DADS — full binary tree — https://xlinux.nist.gov/dads/HTML/fullBinaryTree.html
- NIST DADS — perfect binary tree — https://xlinux.nist.gov/dads/HTML/perfectBinaryTree.html
- NIST DADS — complete binary tree — https://xlinux.nist.gov/dads/HTML/completeBinaryTree.html
- NIST DADS — AVL tree — https://xlinux.nist.gov/dads/HTML/avltree.html
- NIST DADS — red-black tree — https://xlinux.nist.gov/dads/HTML/redblack.html
- Sedgewick & Wayne, Algorithms 4판 3.2 Binary Search Trees — https://algs4.cs.princeton.edu/32bst/
- Pat Morin, Open Data Structures 7장 — https://eng.libretexts.org/Bookshelves/Computer_Science/Databases_and_Data_Structures/Open_Data_Structures_-_An_Introduction_(Morin)/07%3A_Random_Binary_Search_Trees/7.03%3A_Discussion_and_Exercises
- B. Reed, “The height of a random binary search tree”, J. ACM 50(3), 2003 — https://doi.org/10.1145/765568.765571
- Java SE 21 API — TreeMap — https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/util/TreeMap.html
- Java SE 21 API — TreeSet — https://docs.oracle.com/en/java/javase/21/docs/api/java.base/java/util/TreeSet.html
- Kotlin API — sortedMapOf — https://kotlinlang.org/api/core/kotlin-stdlib/kotlin.collections/sorted-map-of.html
- Cormen 외, Introduction to Algorithms 4판, 12장·13장