Android 앱을 만들다 보면 XML 은 매일 봅니다. 레이아웃도 XML 이고 AndroidManifest.xml 도 XML 입니다. 그런데 서버와 주고받는 응답은 언제부터인가 전부 JSON 입니다. 서버 쪽 일을 같이 하면서 오래된 연동 문서를 열어 보면 SOAP 이나 WSDL 이 나오는데, 그때마다 “이게 왜 이렇게 됐지” 싶은 순간이 있습니다. XML 이 나빠서 밀려난 것은 아닙니다. 서버와 클라이언트가 주고받는 데이터가 문서가 아니라 객체가 되면서 맞는 도구가 바뀐 쪽에 가깝습니다. 이 글에서는 그 과정을 같은 데이터를 두 형식으로 써 보면서 따라가겠습니다.
XML 이 중심이던 시절
XML 1.0 은 1998년 2월에 W3C 권고안이 되었습니다. 지금 보는 판은 2008년 11월에 나온 5판인데, 새 버전이 아니라 4판까지 쌓인 오류 정정을 합친 것입니다. 1.0 의 설계 목표 목록에는 눈에 띄는 항목이 있습니다. 사람이 읽을 수 있어야 하고, XML 을 처리하는 프로그램은 쓰기 쉬워야 하며, 마크업의 간결함은 거의 중요하지 않다(“Terseness in XML markup is of minimal importance”)는 항목입니다. 용량보다 명확함을 택한다는 선언이었고, 문서를 다루는 SGML 의 후계로 출발했다는 점을 생각하면 자연스러운 선택입니다.
이 위에 도구가 층층이 쌓였습니다.
- XSD 로 구조와 타입을 검증하고, 네임스페이스로 서로 다른 어휘를 한 문서에 섞습니다.
- XSLT 로 XML 을 다른 XML 이나 HTML 로 변환합니다.
- XML-RPC 는 HTTP 위에서 XML 로 원격 함수를 호출하는 단순한 규약이었습니다.
- SOAP 은 Envelope 안에 Header 와 Body 를 넣는 메시지 규약입니다. SOAP 1.2 는 2003년에 권고안이 되었고, 정오표를 반영한 2판이 2007년 4월에 나왔습니다.
- WSDL 이 서비스의 연산과 메시지 구조를 기계가 읽는 형태로 기술하고, WS-Security 같은 WS-* 확장이 보안과 트랜잭션 영역을 채웠습니다.
WSDL 을 도구에 넣으면 클라이언트 스텁이 생성되고 XSD 로 검증까지 되니, 엔터프라이즈 환경에서는 합리적인 조합이었습니다. 계약이 엄격하고 도구가 다 해 준다는 장점이 분명했습니다.
JSON 이 올라온 경로
JSON 은 JavaScript 객체 리터럴에서 파생된 표기입니다. Douglas Crockford 가 쓴 RFC 4627 이 2006년 7월에 나왔는데, 이 문서는 표준 트랙이 아니라 Informational 이었습니다. 지금은 2017년 12월의 RFC 8259(STD 90)가 정본이고, 같은 문법을 ECMA-404 도 정의합니다. 4627 → 7159 → 8259 로 이어진 개정이어서, 8259 는 UTF-8 인코딩을 필수로 두고 네트워크로 보내는 JSON 에 BOM 을 붙이지 말라고 못박았습니다.
브라우저에서 비동기 호출이 퍼지던 시기에 이 포맷이 유리했던 이유는 단순합니다. 응답 본문을 JSON.parse 에 넘기면 곧바로 자바스크립트 값이 됩니다. XML 은 DOM 을 만들고 노드를 타고 내려가며 값을 꺼내야 했습니다. 재미있는 점은 AJAX 라는 이름입니다. Asynchronous JavaScript and XML 의 약자인데, MDN 설명대로 이름은 원래 구현이 XMLHttpRequest 를 썼다는 데서 왔을 뿐이고 데이터 형식을 XML 로 제한한 적은 없습니다. 이름에는 XML 이 남았는데 실제 응답은 점점 JSON 이 차지했습니다. SPA 가 서버에서 JSON 만 받아 화면을 갱신하는 구조는 SPA 설명에서 다뤘습니다.
API 제공자가 형식을 정리한 사례도 있습니다. Twitter API v1.1 은 JSON 만 지원하고 XML, Atom, RSS 를 없앴습니다. InfoQ 보도가 2013년 6월 17일자입니다. XML 응답에 맞춰 만든 클라이언트는 이때 파서를 갈아 끼워야 했습니다.
같은 데이터를 두 가지로 써 보기
주문을 가진 사용자 한 명으로 비교해 보겠습니다. 먼저 XML 입니다. 값을 모두 자식 요소로 둔 형태입니다.
<?xml version="1.0" encoding="UTF-8"?>
<user>
  <id>42</id>
  <name>Kim Teddy</name>
  <active>true</active>
  <orders>
    <order>
      <id>1001</id>
      <status>PAID</status>
      <totalPrice>43000</totalPrice>
      <items>
        <item>
          <sku>A-100</sku>
          <quantity>2</quantity>
          <unitPrice>15000</unitPrice>
        </item>
        <item>
          <sku>B-200</sku>
          <quantity>1</quantity>
          <unitPrice>13000</unitPrice>
        </item>
      </items>
    </order>
    <order>
      <id>1002</id>
      <status>SHIPPED</status>
      <totalPrice>9900</totalPrice>
      <items>
        <item>
          <sku>C-300</sku>
          <quantity>1</quantity>
          <unitPrice>9900</unitPrice>
        </item>
      </items>
    </order>
  </orders>
</user>
같은 내용을 속성을 적극 활용해서 쓰면 이렇게 줄어듭니다.
<?xml version="1.0" encoding="UTF-8"?>
<user id="42" active="true">
  <name>Kim Teddy</name>
  <orders>
    <order id="1001" status="PAID" totalPrice="43000">
      <item sku="A-100" quantity="2" unitPrice="15000"/>
      <item sku="B-200" quantity="1" unitPrice="13000"/>
    </order>
    <order id="1002" status="SHIPPED" totalPrice="9900">
      <item sku="C-300" quantity="1" unitPrice="9900"/>
    </order>
  </orders>
</user>
JSON 은 이렇습니다.
{
  "id": 42,
  "name": "Kim Teddy",
  "active": true,
  "orders": [
    {
      "id": 1001,
      "status": "PAID",
      "totalPrice": 43000,
      "items": [
        { "sku": "A-100", "quantity": 2, "unitPrice": 15000 },
        { "sku": "B-200", "quantity": 1, "unitPrice": 13000 }
      ]
    },
    {
      "id": 1002,
      "status": "SHIPPED",
      "totalPrice": 9900,
      "items": [{ "sku": "C-300", "quantity": 1, "unitPrice": 9900 }]
    }
  ]
}
바이트 수를 직접 세어 보면 아래와 같습니다. 줄바꿈과 들여쓰기가 들어간 상태와, 공백을 모두 걷어 낸 상태, 그리고 걷어 낸 것을 gzip 으로 압축한 값입니다. XML 은 선언(<?xml ... ?>)을 포함했고 UTF-8 기준입니다.
| 형태 | 들여쓰기 포함 | 공백 제거 | 공백 제거 후 gzip |
|---|---|---|---|
| XML (요소만) | 809 B | 548 B | 250 B |
| XML (속성 활용) | 432 B | 379 B | 227 B |
| JSON | 476 B | 309 B | 188 B |
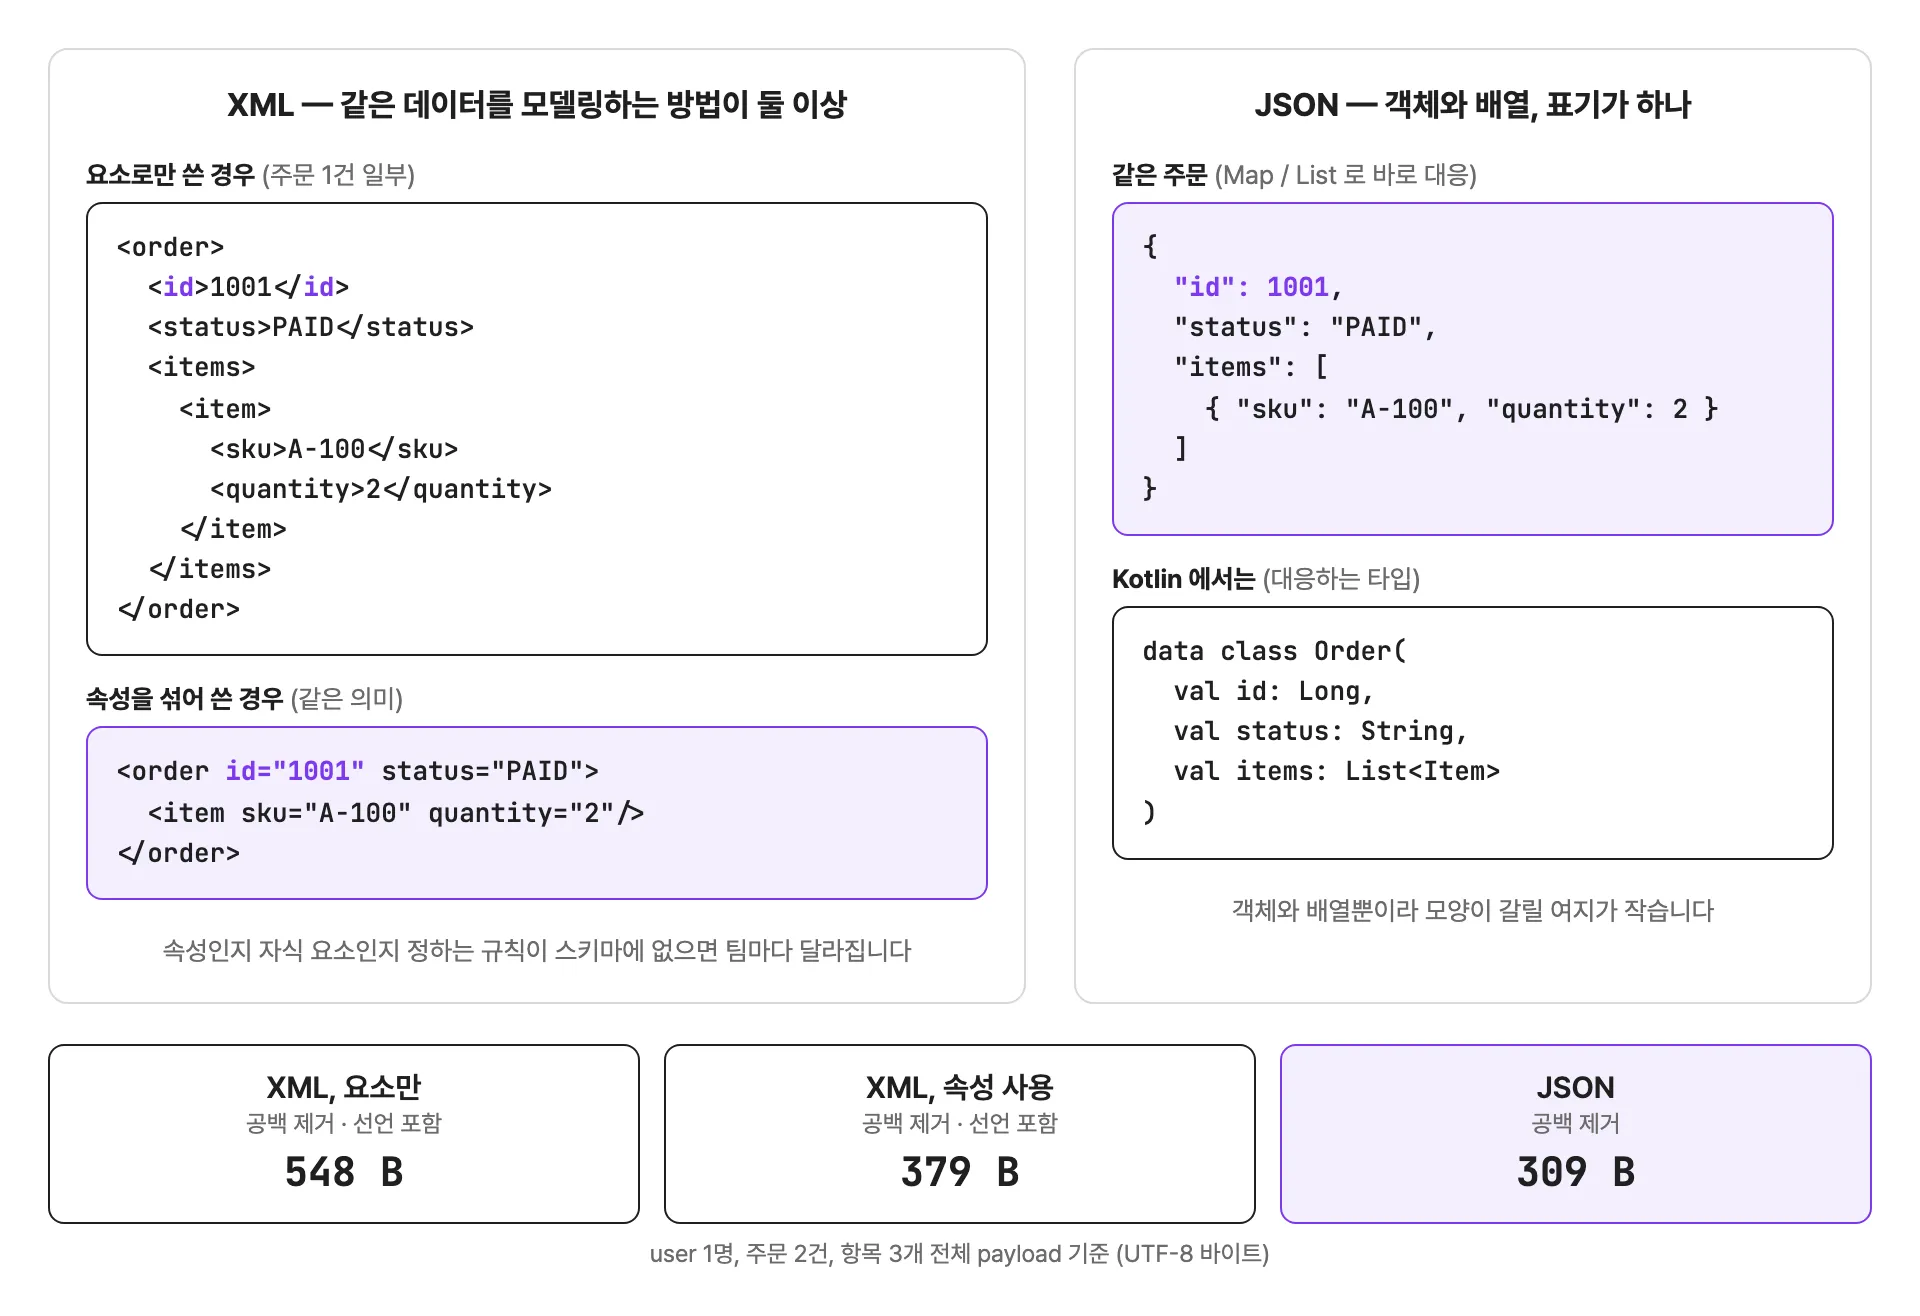
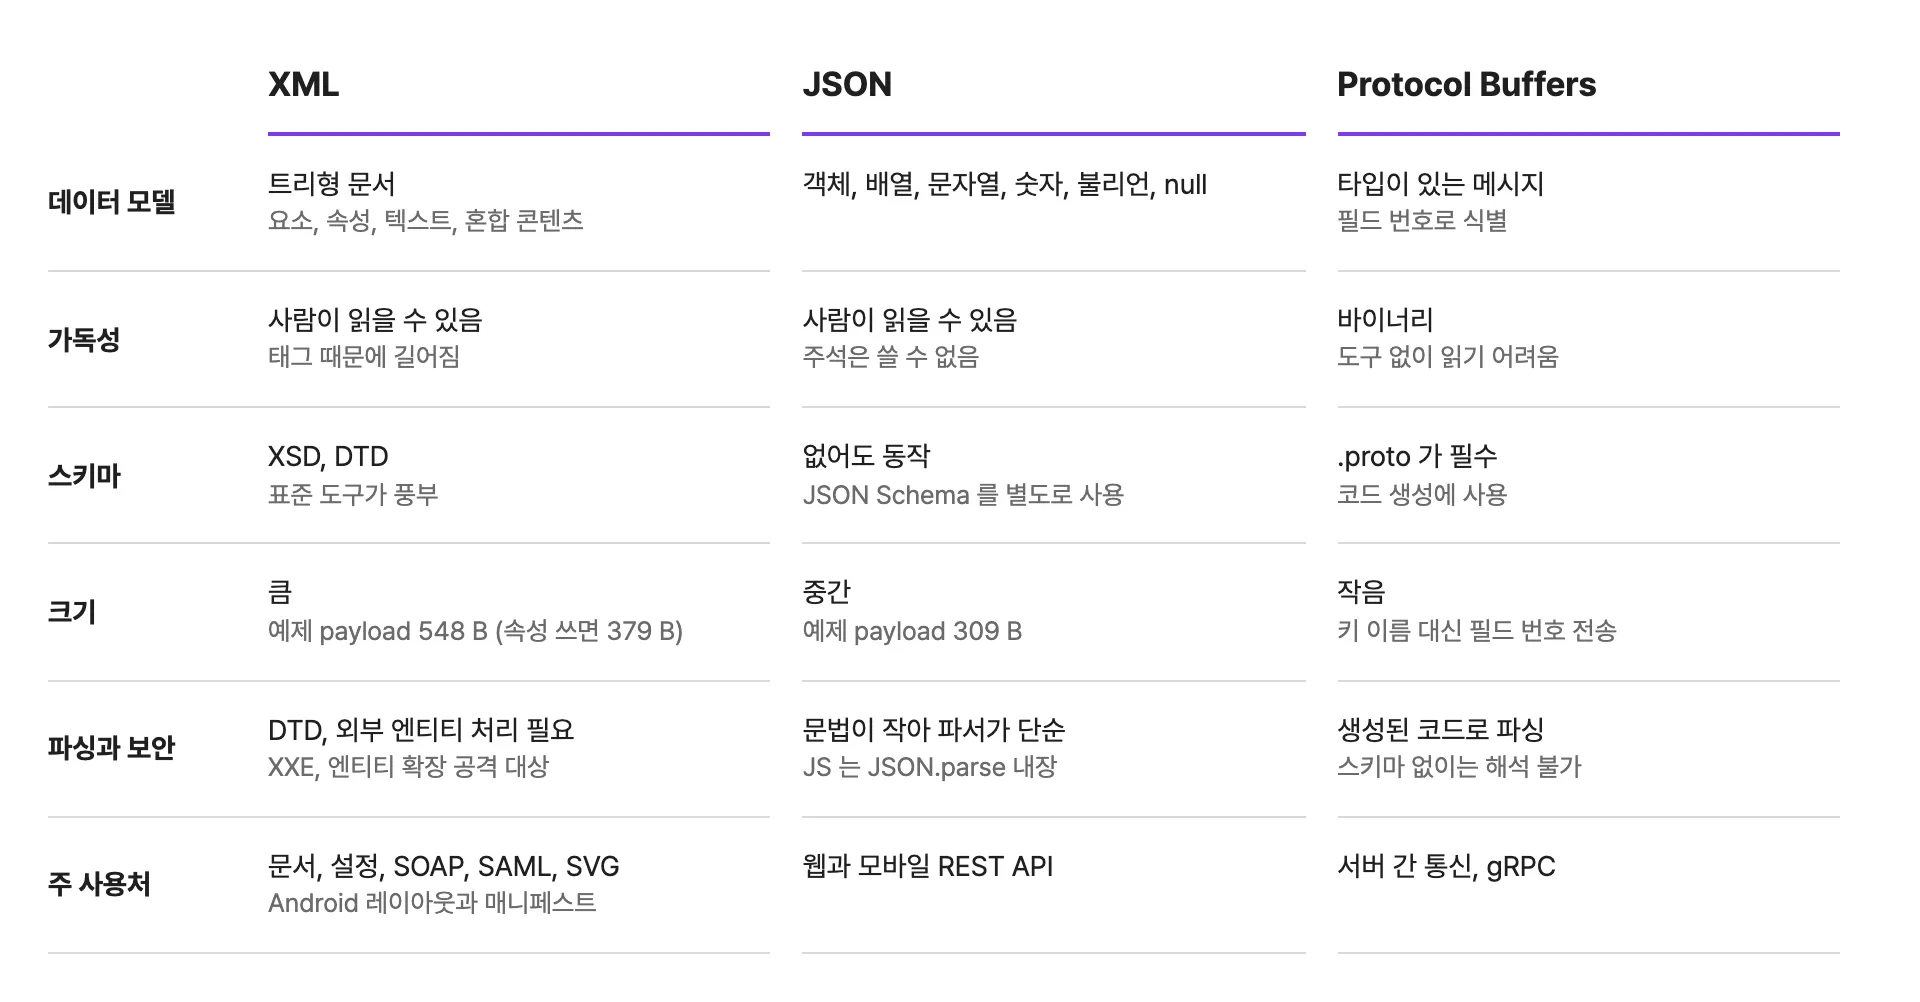
요소만 쓴 XML 은 JSON 의 1.77배(548 / 309)입니다. 반면 속성을 쓰면 격차가 1.23배(379 / 309)까지 줄고, 들여쓰기를 켠 상태에서는 속성 XML(432 B)이 JSON(476 B)보다 오히려 작습니다. 그러니 “XML 은 무조건 뚱뚱하다”는 말은 정확하지 않습니다. 짚어야 할 것은 오히려 같은 데이터를 쓰는 방법이 둘 이상이라는 점입니다. gzip 을 걸면 반복되는 태그 이름이 거의 사라져서 격차가 많이 줄어듭니다(250 B 대 188 B). 모바일 네트워크라면 용량 차이는 압축을 켠 순간 대부분 의미가 없어지고, 남는 것은 파싱과 모델링의 차이입니다.
데이터 모델이 코드와 맞았다
위 예제에서 id 가 어디에 들어가는지 보면 핵심이 보입니다. 첫 번째 XML 에서는 <id>1001</id> 이라는 자식 요소이고, 두 번째에서는 id="1001" 이라는 속성입니다. 어느 쪽이 맞는지는 문법이 정해 주지 않습니다. 식별자나 메타데이터는 속성, 본문 데이터는 요소로 두자는 관행은 있지만 팀마다, 서비스마다 갈립니다. 연동 상대가 정한 방식을 문서로 확인하지 않으면 파서를 짜기도 어렵습니다.
더 곤란한 것은 XML 이 처음부터 문서 모델이라는 점입니다. 텍스트 사이에 태그가 섞이는 혼합 콘텐츠를 지원합니다.
<p>주문은 <b>1001</b>번이 <i>결제 완료</i> 상태입니다.</p>문서라면 당연한 구조이지만 주문 데이터에는 필요 없습니다. 그런데 이 기능이 있기 때문에 XML 파서는 요소 안의 텍스트가 어디서 끊기고 이어지는지를 신경 써야 합니다. 값 하나를 읽으려고 텍스트 노드를 모으는 코드를 여러 번 써 본 분이라면 무슨 말인지 아실 겁니다. 숫자 2 도 XML 에서는 그냥 텍스트이고, 타입은 XSD 가 있어야 비로소 생깁니다.
JSON 은 객체(키-값), 배열, 문자열, 숫자, 불리언, null 만 있습니다. 거의 모든 언어에 Map 과 List 가 있으니 대응이 거의 일대일입니다. RFC 4627 이 소개하는 것도 “객체 리터럴에서 파생”이라는 점이고, 처음부터 객체를 직렬화한 모양이라서 언어 쪽 모델과 어긋나는 구간이 거의 없습니다. Kotlin 에서는 data class 와 List 가 그대로 들어맞습니다.
파싱 비용과 보안
XML 은 파서가 처리해야 할 기능이 많습니다. DTD, 엔티티 선언, 외부 엔티티 참조, 네임스페이스, 스키마 검증이 모두 파서의 몫입니다. 여기서 XML 에만 있는 공격 유형이 나옵니다.
XXE(XML External Entity) 는 신뢰할 수 없는 입력에 담긴 외부 엔티티를 파서가 풀어 버릴 때 생깁니다. OWASP 는 이로 인해 서버의 로컬 파일이 노출되거나, 서버가 임의의 주소로 요청을 보내는 SSRF 가 일어나거나, 자원 고갈로 서비스 거부가 날 수 있다고 정리합니다. 엔티티 참조를 겹겹이 중첩해서 작은 문서가 메모리를 폭발시키는 billion laughs 도 같은 계열의 DoS 입니다. OWASP 의 방어 지침은 가능하면 DTD 자체를 끄라는 것인데, 이 지침은 XXE 만 막아서는 XML 의 모든 서비스 거부 공격을 막을 수 없다는 말도 함께 붙입니다.
<!DOCTYPE lolz [
  <!ENTITY a "ha">
  <!ENTITY b "&a;&a;&a;&a;&a;&a;&a;&a;&a;&a;">
  <!ENTITY c "&b;&b;&b;&b;&b;&b;&b;&b;&b;&b;">
]>
<lolz>&c;</lolz>
실무적으로는 “XML 을 받는 서버의 파서 설정을 한 번도 안 열어 본 상태”가 가장 위험합니다. 기본 설정이 안전하다는 보장이 라이브러리마다 다르기 때문입니다. JSON 에는 엔티티도, 외부 참조도 없습니다. 파서가 해야 할 일이 구조를 읽는 것뿐이라서 이 공격 유형 자체가 존재하지 않습니다. 물론 JSON 도 깊게 중첩된 입력이나 거대한 숫자로 파서를 괴롭힐 수는 있으니 크기와 깊이 제한은 걸어야 합니다. 다만 파서 설정 하나를 놓쳐서 서버의 파일이 새는 종류의 사고는 구조적으로 막혀 있습니다.
도구도 달라졌습니다. 자바스크립트는 JSON.parse 가 내장이고, Kotlin 이나 Swift, Go 는 기본 라이브러리나 표준에 가까운 라이브러리가 있습니다. 직렬화 코드를 컴파일 타임에 생성하는 방식도 흔합니다. XML 이 어려웠던 것은 DOM, SAX, StAX, XPath, XSLT 가운데 무엇을 쓸지부터 고르는 일이었습니다.
그래도 XML 이 남아 있는 곳
JSON 이 이긴 것은 “서비스 사이에서 오가는 데이터 객체”라는 영역입니다. 문서와 마크업 영역은 여전히 XML 이 잘 맞습니다.
- Android 레이아웃과 매니페스트: 트리 구조의 선언이라 속성이 자연스럽고 스키마 검증도 도구가 합니다.
- Office 문서(OOXML): docx, xlsx, pptx 는 XML 파일을 묶은 zip 입니다.
- SVG: 그래픽을 텍스트 마크업으로 쓰는 형식입니다.
- RSS, Atom: 피드 포맷은 XML 로 정해져 있습니다.
- SAML: 기업 SSO 에서 아직 흔한 인증 어설션 포맷입니다.
- SOAP: 금융, 공공, 오래된 기간계 연동에 아직 많습니다. 계약이 엄격하고 서명과 보안 확장이 이미 구축되어 있으면 옮길 이유가 크지 않습니다.
연동 상대가 SOAP 이라면 선택지가 없습니다. 그럴 때는 WSDL 에서 스텁을 생성해서 쓰고, 파서의 DTD 처리를 끈 것을 확인한 뒤 가능하면 어댑터 계층을 하나 두어 내부는 JSON 이나 도메인 모델로만 다루게 하는 편이 낫습니다.
JSON 에 없는 것
JSON 이 단순한 것은 많은 것을 빼 놓았기 때문이기도 합니다.
- 주석이 없습니다. RFC 8259 의 문법에는 주석이 없고, MDN 도 주석과 마지막 쉼표를 모두 파싱 오류로 설명합니다. 설정 파일에 JSON 을 쓰기 불편한 이유입니다.
- 스키마가 문법에 포함되지 않습니다. 그 자리를 JSON Schema 가 따로 채웁니다. 구조와 값 제약을 기술하는 어휘이고 검증기와 생성기 생태계가 있지만, XSD 처럼 거의 모든 곳에서 기본으로 기대할 수 있는 수준은 아닙니다.
- 날짜 타입이 없습니다. 문자열로 보내야 하고, ISO 8601 로 맞추자는 합의는 관행입니다. 시간대를 빼고 보내는 순간 버그가 시작됩니다.
- 큰 정수의 정밀도가 문제입니다. RFC 8259 는 구현이 숫자의 범위와 정밀도를 제한할 수 있다고 하면서, IEEE 754 배정밀도를 쓰는 소프트웨어끼리는 -(2^53)+1 부터 (2^53)-1 까지의 정수가 정확히 일치한다고 보장합니다. MDN 의 예처럼
JSON.parse("12345678901234567890")은 자바스크립트에서12345678901234568000이 됩니다. Snowflake 같은 64비트 ID 를 JSON 숫자로 보내면 웹 클라이언트에서 값이 바뀌어 보입니다. 서버가 큰 ID 를 문자열로 내려 주는 이유가 이것입니다.
마지막 항목은 서버와 앱이 같이 겪기 쉽습니다. Kotlin 에서는 Long 으로 문제없이 받는데 같은 응답이 웹에서는 깨진다면 이 경우를 가장 먼저 의심해 볼 만합니다.
Kotlin 에서 JSON 받기
Kotlin 에서는 kotlinx.serialization 을 쓰면 JSON 이 곧 타입 있는 객체가 됩니다. 위 JSON 을 그대로 받는 모델은 이렇습니다.
import kotlinx.serialization.Serializable
import kotlinx.serialization.json.Json

@Serializable
data class User(
    val id: Long,
    val name: String,
    val active: Boolean,
    val orders: List<Order>,
)

@Serializable
data class Order(
    val id: Long,
    val status: String,
    val totalPrice: Long,
    val items: List<Item>,
)

@Serializable
data class Item(
    val sku: String,
    val quantity: Int,
    val unitPrice: Long,
)

private val json = Json { ignoreUnknownKeys = true }

fun parseUser(body: String): User = json.decodeFromString<User>(body)
ignoreUnknownKeys 를 켜 두면 서버가 필드를 추가해도 앱이 깨지지 않습니다. 반대로 꺼 두면 모르는 키에서 디코딩이 실패합니다. 서버와 앱의 배포 시점이 다르다면 켜 두는 쪽이 안전합니다. 키 이름이 snake_case 라면 @SerialName("total_price") 로 매핑합니다. 이 어노테이션을 빠뜨리면 이름이 다른 필드는 값이 비어 버리니, 응답 모델을 만들 때 꼭 확인해 두는 편이 좋습니다. 클래스 쪽은 data class 로 충분합니다.
같은 응답을 XML 로 받으려면 DOM 으로 읽고 노드를 타고 내려가며 직접 변환하거나 별도 XML 매핑 라이브러리를 붙여야 합니다. 이 차이가 앱 개발자 입장에서 JSON 이 체감되는 가장 큰 이유입니다.
JSON 다음은 바이너리
JSON 도 텍스트이고 키 이름이 매번 반복됩니다. 내부 서비스 사이의 호출이나 대량 전송에서는 이 부분이 비용이 되어 바이너리 포맷이 올라옵니다.
- Protocol Buffers:
.proto파일에 메시지 구조를 한 번 정의하면 컴파일러가 각 언어의 클래스를 만들어 줍니다. 공식 문서는 JSON 과 비슷하지만 더 작고 빠르다고 설명합니다. 데이터만으로는 해석할 수 없고.proto가 있어야 읽을 수 있다는 한계도 문서에 적혀 있습니다. gRPC 가 이 포맷 위에서 동작합니다. - CBOR: RFC 8949 로 표준화된 포맷이고, JSON 데이터 모델에 바이트 문자열을 더한 모델입니다. 코드 크기가 아주 작고 메시지 크기가 어느 정도 작으며 버전 협상 없이 확장할 수 있다는 것이 목표입니다.
- MessagePack: JSON 처럼 스키마 없이 쓰는 바이너리 직렬화입니다.
브라우저 앞단의 공개 API 가 아니라면 이 선택지를 고려할 만합니다. 내부 서비스끼리, 모바일 앱과 자체 서버 사이에서 용량이 문제가 될 때가 그렇습니다. 반면 사람이 요청과 응답을 눈으로 확인하는 일이 많은 외부 API 는 아직 JSON 이 기본입니다.
정리하면
XML 에서 JSON 으로의 이동은 포맷의 우열이 아니라 데이터가 문서에서 객체로 바뀐 결과입니다. 객체를 주고받는 API 에는 모델이 코드와 맞고 파서가 단순하며 보안 표면이 작은 JSON 이 맞았고, 문서와 마크업에는 XML 이 계속 맞습니다. 새로 만드는 API 라면 JSON 을 기본으로 하되 날짜와 큰 정수 규칙을 먼저 정하고, 내부 통신처럼 용량이 문제인 구간에서 Protocol Buffers 를 따져 보면 됩니다. SOAP 연동을 맡게 되면 외부 엔티티가 꺼져 있는지부터 확인하는 것이 좋겠습니다.
참고 자료
- XML 1.0 (Fifth Edition) - W3C
- SOAP Version 1.2 Part 1 - W3C
- RFC 4627 - The application/json Media Type for JavaScript Object Notation (JSON)
- RFC 8259 - The JavaScript Object Notation (JSON) Data Interchange Format
- Introducing JSON - json.org
- AJAX - MDN Web Docs
- JSON - MDN Web Docs
- Twitter API v1.1 supports only JSON - InfoQ
- XML External Entity Prevention Cheat Sheet - OWASP
- Protocol Buffers Overview
- RFC 8949 - Concise Binary Object Representation (CBOR)
- JSON Schema
- Serialization - Kotlin Documentation