프로세스가 읽고 쓰는 주소는 물리 메모리의 실제 위치가 아닙니다. 일반적으로 두 프로세스가 같은 주소 0x00403A10 을 읽어도, 서로 다른 물리 메모리를 보며 물리 메모리보다 큰 프로그램도 실행됩니다. 이 동작은 가상 메모리가 주소를 하드웨어와 운영체제 수준에서 변환하기 때문에 가능합니다. 메모리 구조 글에서 본 코드, 힙, 스택 영역은 모두 이 가상 주소 공간 안에 있습니다.
가상 주소 공간이 하는 일
운영체제는 프로세스마다 독립된 가상 주소 공간을 줍니다. 프로세스끼리 주소 공간이 겹치지 않아 서로의 메모리를 건드리지 못합니다. 각 프로세스는 물리 메모리가 어떻게 흩어져 있든, 연속된 공간을 가진 것처럼 프로그램을 짤 수 있습니다. 코드나 공유 라이브러리처럼 내용이 같은 부분은 여러 프로세스의 가상 페이지를 하나의 물리 페이지에 연결해 공유합니다. 모든 접근에는 읽기·쓰기·실행 권한을 검사합니다. 당장 쓰지 않는 부분은 물리 메모리에 올리지 않아도 됩니다.
x86-64 의 4단계 페이징에서는 가상 주소를 48비트로 사용합니다. Linux 는 이 중 하위 절반을 사용자 공간으로 쓰므로, 프로세스 하나가 볼 수 있는 공간은 약 128TiB 입니다. 5단계 페이징을 지원하는 CPU 와 커널에서는 57비트를 써서 사용자 공간이 약 64PiB 까지 늘어납니다.
페이지와 프레임, 주소 변환
변환의 단위는 고정 크기 블록입니다. 가상 주소 공간을 나눈 조각이 페이지입니다. 물리 메모리를 같은 크기로 나눈 조각은 프레임(page frame)이라고 부릅니다. 페이지 크기는 4KiB 가 일반적입니다. 가상 주소는 상위 비트의 페이지 번호(VPN)와 하위 비트의 오프셋으로 나뉩니다. 변환은 VPN 을 프레임 번호(PFN)로 바꾸는 일입니다. 오프셋은 페이지 안의 위치라서 그대로 유지됩니다. 변환은 MMU(Memory Management Unit)라는 CPU 안의 하드웨어가 수행합니다. 변환 규칙인 페이지 테이블은 운영체제가 메모리에 만들어 둡니다.
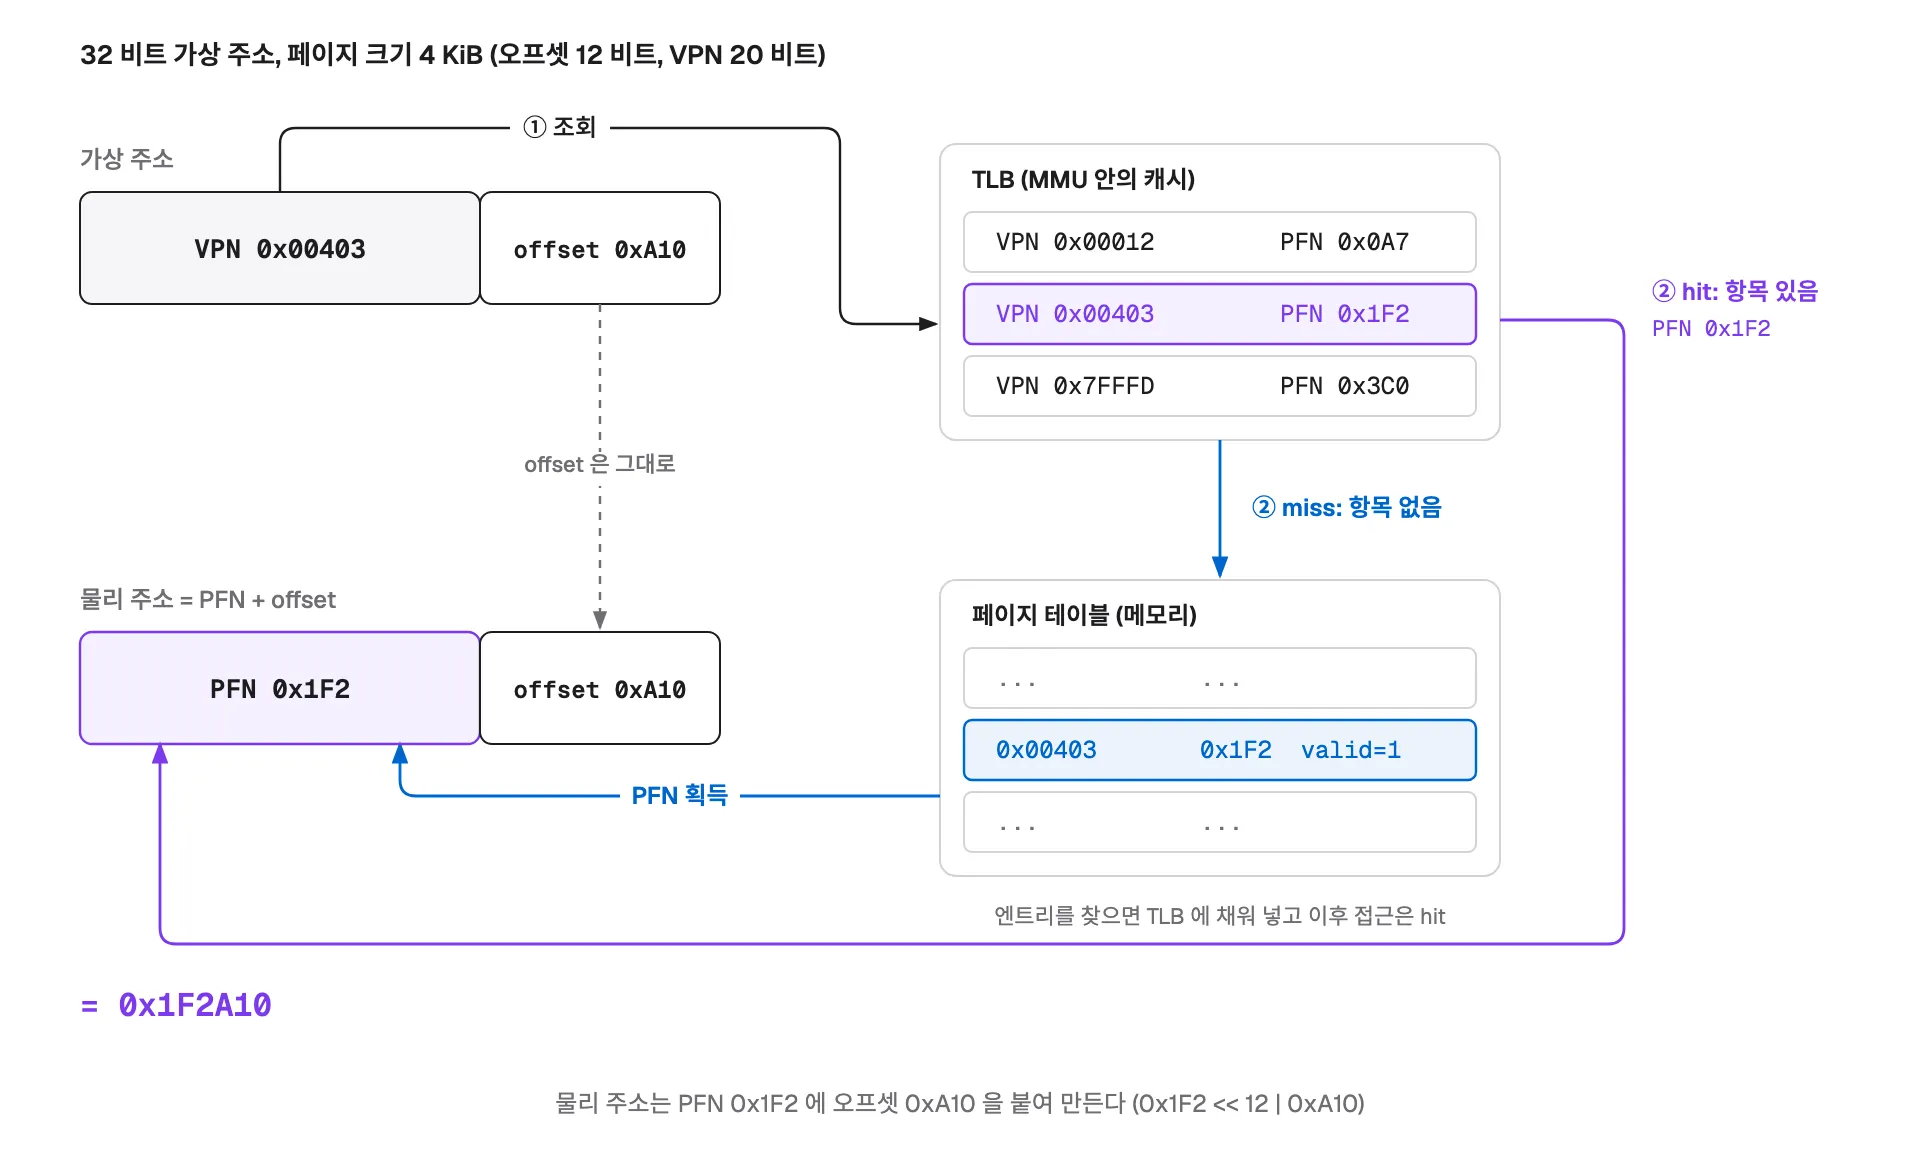
페이지 크기가 4KiB 이면 오프셋은 12비트입니다. 위 그림의 32비트 주소는 상위 20비트가 VPN 이고 하위 12비트가 오프셋입니다. 비트 연산으로 쓰면 다음과 같습니다.
val vaddr = 0x00403A10
val vpn = vaddr ushr 12        // 0x403
val offset = vaddr and 0xFFF   // 0xA10

val pfn = 0x1F2                // 페이지 테이블이 알려 준 값
val paddr = (pfn shl 12) or offset   // 0x1F2A10
페이지 테이블과 TLB
페이지 테이블의 엔트리(PTE)는 PFN 외에 몇 가지 비트를 갖습니다. 물리 메모리에 올라와 있는지를 나타내는 valid(present) 비트, 읽기·쓰기·실행 권한, 최근에 접근되었는지를 나타내는 referenced 비트, 쓰기가 일어났는지를 나타내는 dirty 비트입니다.
테이블을 단순하게 배열 하나로 만들면 낭비가 큽니다. 32비트 주소와 4KiB 페이지에서는 엔트리가 2^20 개입니다. 엔트리가 4바이트이면 프로세스마다 4MiB 입니다. 주소 공간이 넓은 64비트에서는 더 감당하기 어렵습니다. 그래서 테이블을 여러 단계로 나눕니다. x86-64 의 4단계 구조에서는, 48비트 중 하위 12비트가 오프셋이고 나머지 36비트를 9비트씩 4등분해 각 단계의 인덱스로 씁니다. 테이블 하나는 512 개의 8바이트 엔트리로 4KiB, 정확히 페이지 한 장입니다. 쓰지 않는 영역은 하위 테이블을 만들지 않고 건너뛰므로, 실제로 쓰는 만큼만 공간을 차지합니다.
단계가 늘면 변환마다 메모리를 여러 번 읽어야 합니다. 이 부담을 줄이는 장치가 TLB(Translation Lookaside Buffer)입니다. 최근 변환 결과(VPN → PFN)를 MMU 안에 캐시해 둡니다. 조회에 성공하면(hit) 페이지 테이블을 읽지 않습니다. 실패하면(miss) 페이지 테이블을 따라가 PFN 을 찾고 TLB 에 채웁니다. 한 단계짜리 페이지 테이블을 가정하고 TLB 조회 1ns, 메모리 접근 100ns, hit 비율 98% 라는 값을 넣으면 평균 접근 시간은 다음과 같습니다.
0.98 × (1 + 100) + 0.02 × (1 + 100 + 100) = 103nsTLB 가 없으면 모든 접근이 200ns 이므로, 프로그램의 지역성 덕분에 높게 유지되는 hit 비율이 변환 비용을 크게 줄입니다. 이 수치는 계산 방식을 보이기 위한 가정이며 실제 값은 하드웨어마다 다릅니다.
페이지 폴트와 요구 페이징
모든 페이지를 미리 올리지 않고 처음 접근할 때 적재하는 방식을 요구 페이징(demand paging)이라고 합니다. 프로세스는 실행 파일의 코드 페이지를 가상 주소에 매핑만 해 둔 채 시작합니다. 실제 내용은 처음 접근할 때 디스크에서 읽습니다. 힙이나 스택 같은 익명 영역도, 처음 접근할 때 0 으로 채운 프레임을 받습니다. 이렇게 하면 실제로 쓰는 페이지만 메모리를 차지합니다.
PTE 의 valid 비트가 0 이거나 권한에 어긋나는 접근이 일어나면, CPU 가 예외(trap)를 발생시켜 운영체제의 페이지 폴트 핸들러로 제어를 넘깁니다. 처리 흐름은 아래와 같습니다.
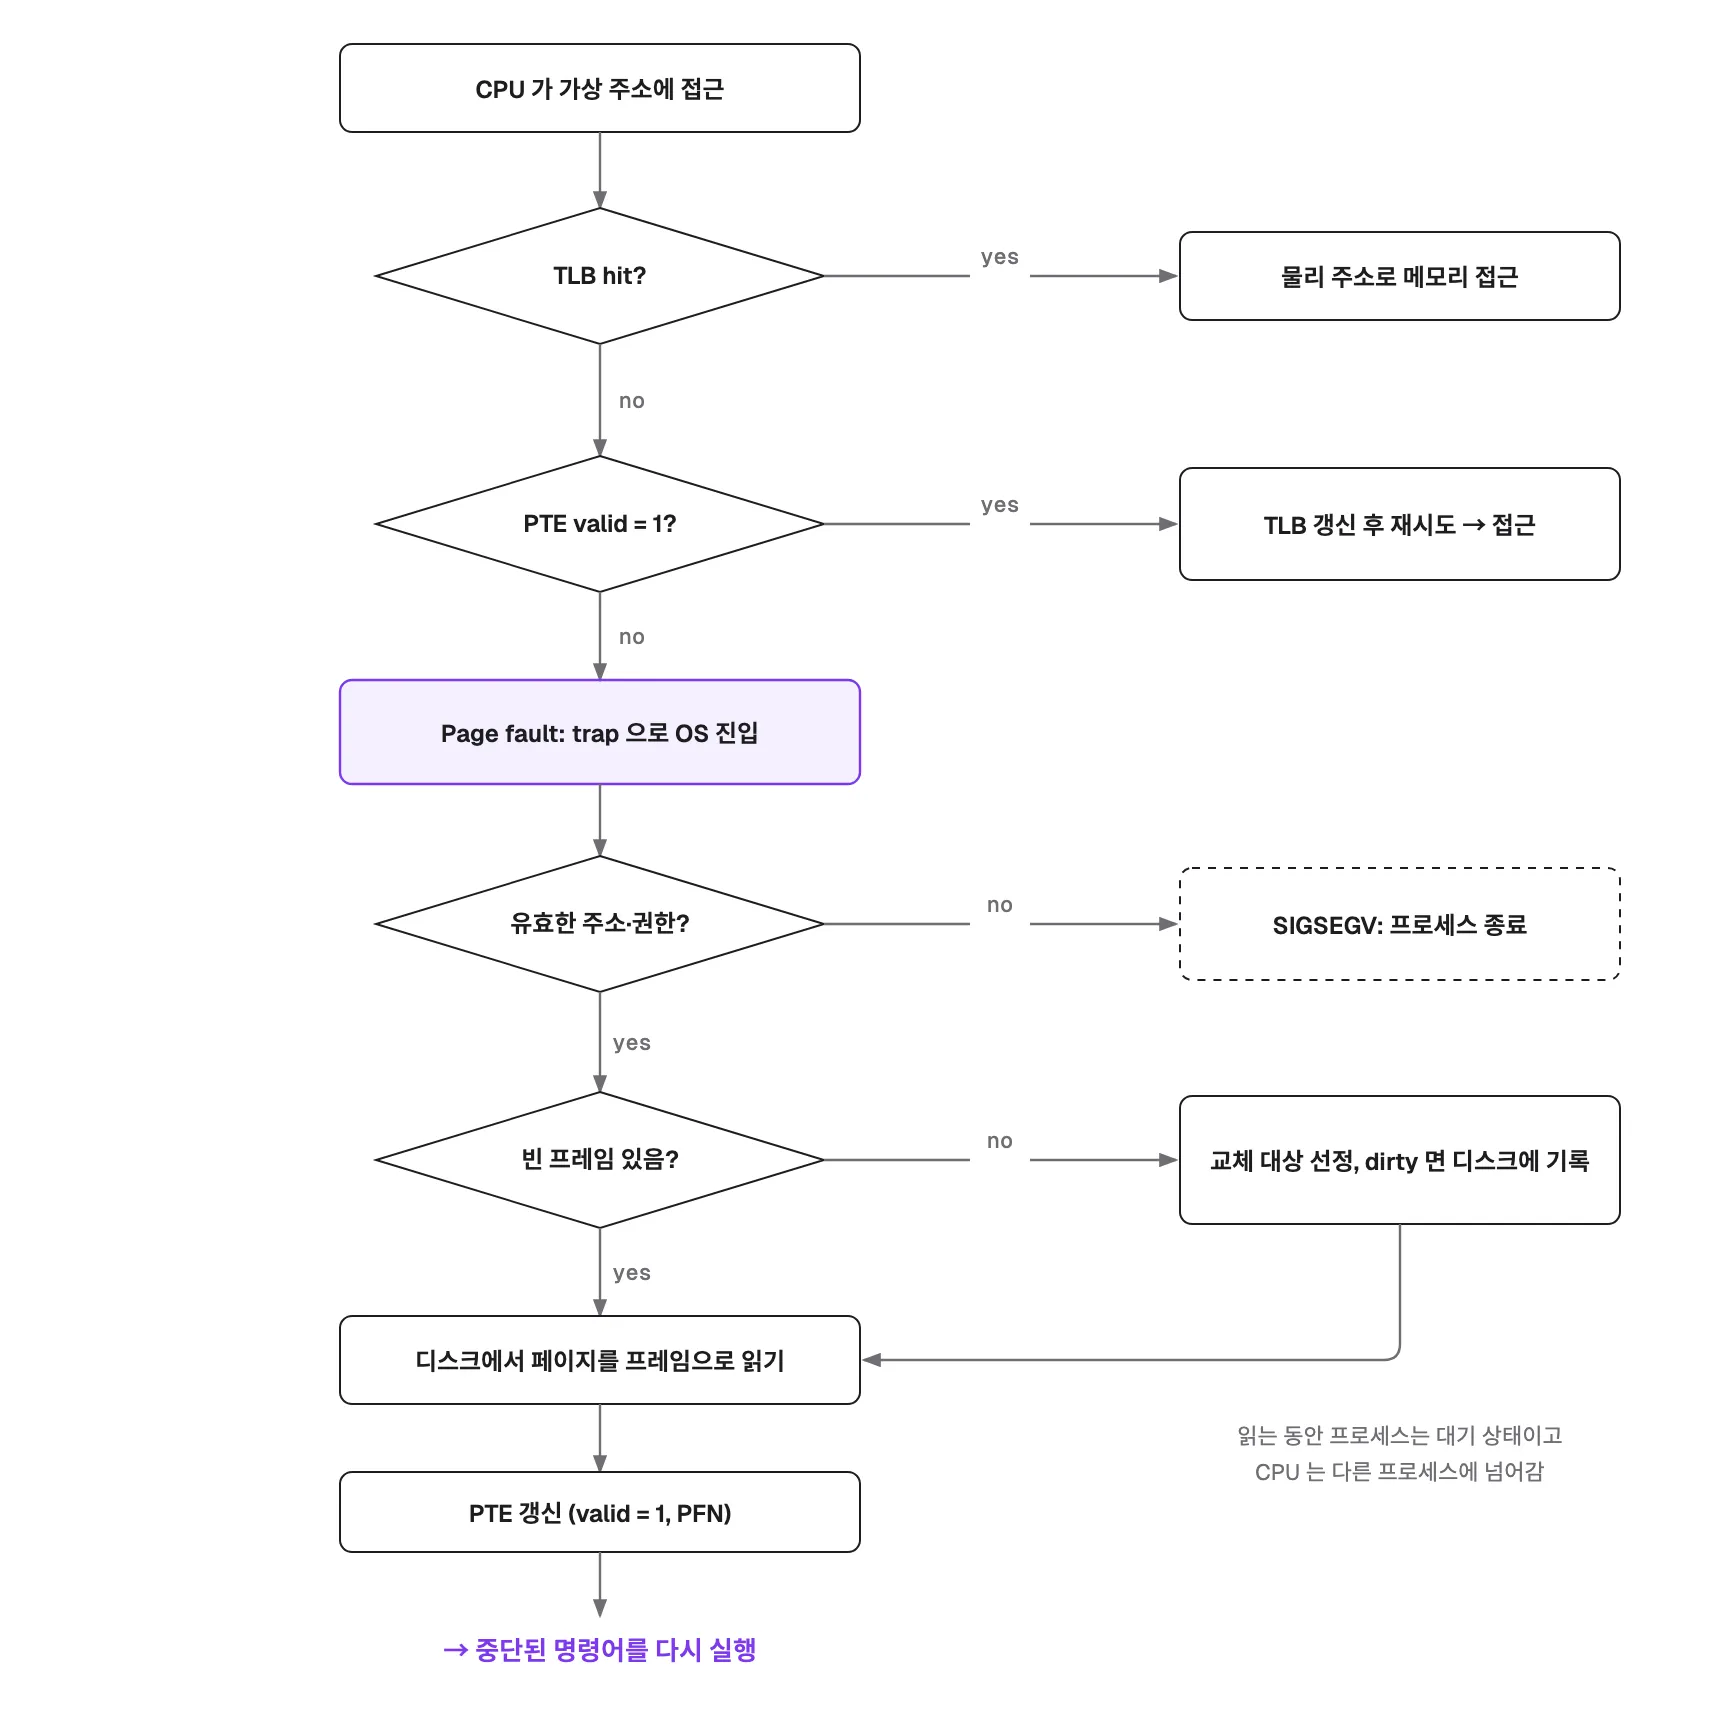
핸들러는 먼저 주소가 프로세스에 유효한 영역인지 검사합니다. 매핑이 없는 주소이거나 매핑의 권한을 어긴 접근이라면 프로세스에 SIGSEGV 를 보내 종료합니다. 정당한 접근이면 빈 프레임을 찾습니다. 없으면 교체 대상을 골라 내보낸 뒤(수정되었다면 디스크에 기록), 필요한 페이지를 읽어 PTE 를 갱신합니다. 디스크를 읽는 동안 프로세스는 waiting 상태가 되어 CPU 를 다른 프로세스에 넘깁니다. 읽기가 끝나면 폴트를 일으킨 명령어를 처음부터 다시 실행합니다.
Linux 는 폴트를 두 종류로 구분합니다. 필요한 페이지가 이미 메모리(페이지 캐시 등)에 있어, PTE 만 연결하면 끝나는 폴트가 minor fault 입니다. 디스크 I/O 가 필요한 폴트는 major fault 입니다. 비용 차이가 크기 때문에 성능 분석에서 둘을 따로 셉니다. fork() 도 비슷한 방식으로 부모의 페이지를 복사하지 않고 읽기 전용으로 공유해 두었다가, 어느 쪽이 쓰려는 순간 폴트를 받아 그 페이지만 복사합니다(copy-on-write).
페이지 교체 알고리즘
빈 프레임이 없을 때 어떤 페이지를 내보낼지 정하는 규칙이 교체 알고리즘입니다. 목표는 앞으로 쓰이지 않을 페이지를 내보내 이후 폴트를 줄이는 것입니다.
FIFO 는 가장 먼저 들어온 페이지를 내보냅니다. 구현은 단순하지만 오래 메모리에 있었다고 해서 쓸모가 없는 것은 아니므로, 자주 쓰는 페이지도 내보낼 수 있습니다. FIFO 에는 프레임 수를 늘렸는데, 폴트가 오히려 늘어나는 Belady 의 이상 현상도 있습니다. 참조열 1 2 3 4 1 2 5 1 2 3 4 5 에서, 프레임 3 개일 때 폴트는 9 번이고 4 개일 때 10 번입니다.
OPT(최적) 는 앞으로 가장 오랫동안 쓰이지 않을 페이지를 내보냅니다. 폴트 수가 가장 적다는 것이 증명되어 있습니다. 다만 미래의 참조를 알아야 하므로, 실제로 구현할 수 없습니다. 이 알고리즘은 다른 알고리즘의 성능을 재는 기준으로 쓰입니다. LRU 는 과거의 참조를 보고, 가장 오래 전에 쓰인 페이지를 내보내서 OPT 를 근사합니다.
참조열 7,0,1,2,0,3,0,4,2,3,0,3,2,1,2,0,1,7,0,1 에 프레임 3 개를 주면 LRU 는 12 번, FIFO 는 15 번, OPT 는 9 번의 폴트가 납니다. 위 애니메이션은 LRU 를 따라간 것입니다. 아래쪽 recency 목록의 맨 왼쪽이 다음 교체 대상입니다.
LRU 를 정확히 구현하려면, 접근마다 순서를 갱신해야 해서 하드웨어가 지원하지 않으면 비용이 큽니다. 실제 시스템은 PTE 의 referenced 비트를 이용한 근사를 씁니다. 대표적인 것이 시계(clock) 알고리즘으로, 프레임을 원형으로 늘어놓고 포인터가 돌면서 referenced 비트가 1 이면, 0 으로 지우고 넘어갑니다. 0 인 페이지를 만나면 교체합니다. Linux 는 페이지를 active 와 inactive 목록으로 나누어 관리하는 LRU 근사 방식을 씁니다. Linux 6.1 부터는 이 두 목록을 여러 세대(generation)로 확장한 Multi-Gen LRU 를 빌드 옵션으로 선택할 수도 있습니다.
스래싱
프로세스가 일정 시간 동안 활발히 쓰는 페이지의 집합을 워킹 셋(working set)이라고 합니다. 실행 중인 프로세스들의 워킹 셋을 합친 크기가 물리 메모리를 넘으면, 방금 내보낸 페이지를 곧바로 다시 읽어 와야 하는 상황이 반복됩니다. 시간의 대부분을 페이지 입출력에 쓰고 CPU 는 놀게 되는 이 상태가 스래싱(thrashing)입니다. 폴트가 늘면 CPU 이용률이 떨어집니다. 이용률이 낮아진 것을 보고, 운영체제가 프로세스를 더 올리면 상황이 악화되는 고전적인 악순환이 생깁니다. 대응은 동시에 실행하는 프로세스 수를 줄이거나, 프로세스마다 워킹 셋 이상의 프레임을 보장하는 것입니다.
세그멘테이션과의 비교
세그멘테이션은 주소 공간을 코드, 데이터, 스택처럼 의미 단위로 나눠 각 세그먼트에 가변 크기를 주고 주소를 (세그먼트 번호, 오프셋)으로 표현합니다. 프로그램의 논리적 구조와 일치하고 세그먼트 단위로 권한을 줄 수 있습니다. 반면 크기가 제각각이라 물리 메모리에서 외부 단편화가 생깁니다. 페이징은 크기가 고정이므로 외부 단편화가 없고 프레임 배치가 자유롭습니다. 대신 마지막 페이지의 남는 공간 때문에, 내부 단편화가 생기고 페이지가 논리 구조와 무관하게 잘립니다. x86 은 두 방식을 모두 지원했습니다. 다만 x86-64 의 64비트 모드에서는, 세그멘테이션이 사실상 평탄한 주소 공간으로 단순화되어 있습니다. Linux 는 주로 페이징으로 메모리를 관리합니다.
Android 와 Linux 에서 보면
Android 앱 프로세스는 Linux 프로세스이므로 위의 구조를 그대로 씁니다. 앱은 가상 주소만 보며 어느 프레임에 놓일지는 커널이 정합니다. 앱의 코드와 리소스 파일은 mmap 으로 매핑되어 요구 페이징으로 올라옵니다. 프로세스를 만드는 Zygote 가 미리 올려 둔 프레임워크 클래스와 라이브러리는 copy-on-write 방식으로, 여러 앱 프로세스가 함께 씁니다. 공유 페이지를 쓰는 프로세스 수로 나누어, 각 프로세스에 배분하는 메모리 측정값이 PSS(Proportional Set Size)입니다. adb shell dumpsys meminfo 가 이 값을 보여 줍니다.
Android 는 플래시 저장소의 마모를 피하려고 저장소를 스왑 공간으로 쓰지 않습니다. 대신 많은 기기가 RAM 일부를 압축 스왑 영역으로 쓰는 zRAM 을 둡니다. 메모리가 부족해지면 커널의 kswapd 가 먼저 수정되지 않은(clean) 파일 페이지, 즉 코드나 리소스처럼 저장소에서 다시 읽으면 되는 페이지를 버립니다. 앱의 힙 같은 익명 페이지는 저장소로 내보낼 수 없으므로 zRAM 에 압축해 옮깁니다. 압축해도 RAM 을 쓰기 때문에 되찾을 수 있는 양에 한계가 있습니다. 이것으로 부족하면 프로세스 자체를 종료해 그 프로세스의 메모리를 통째로 되찾습니다. 이 일을 맡은 것이 low memory killer 입니다. 현재는 사용자 공간 데몬인 lmkd 가 수행합니다. 초기에는 커널 안의 lowmemorykiller 드라이버가 담당했습니다.
lmkd 는 메모리 압박 신호(최근 버전은 Linux 의 PSI)를 감시하다가, 기준을 넘으면 프로세스를 종료합니다. 종료 순서는 프로세스마다 매겨진 oom_score_adj 값이 정합니다. 포그라운드 앱은 0 으로 앱 프로세스 중에서는 가장 낮습니다. 시스템 서버나 persistent 프로세스, 네이티브 데몬은 음수 값을 받아 그보다도 늦게 종료됩니다. 화면에 보이지 않고 캐시된 프로세스는 900 이상의 높은 값을 받아 먼저 종료됩니다. 포그라운드에서 쫓겨난 앱의 프로세스가 사용자 모르게 종료되는 이 현상이, 앱 개발에서 말하는 프로세스 종료(process death)입니다. 앱이 다시 열릴 때, Activity 는 onSaveInstanceState 나 SavedStateHandle 에 저장해 둔 상태로 복원되어야 합니다. 메모리에만 있던 정보는 사라집니다.
참고 자료
- OSTEP — Paging: Introduction — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-paging.pdf
- OSTEP — Paging: Faster Translations (TLBs) — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-tlbs.pdf
- OSTEP — Paging: Smaller Tables — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-smalltables.pdf
- OSTEP — Beyond Physical Memory: Mechanisms — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-beyondphys.pdf
- OSTEP — Beyond Physical Memory: Policies — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-beyondphys-policy.pdf
- OSTEP — Segmentation — https://pages.cs.wisc.edu/~remzi/OSTEP/vm-segmentation.pdf
- Linux kernel — x86_64 Memory Management — https://docs.kernel.org/arch/x86/x86_64/mm.html
- Linux kernel — Unevictable LRU Infrastructure — https://docs.kernel.org/mm/unevictable-lru.html
- Linux kernel — Multi-Gen LRU — https://docs.kernel.org/mm/multigen_lru.html
- Android — Memory allocation among processes — https://developer.android.com/topic/performance/memory-management
- Android — Overview of memory management — https://developer.android.com/topic/performance/memory-overview
- Low memory killer daemon — https://source.android.com/docs/core/perf/lmkd