서블릿 기반 서버는 요청 하나를 스레드 하나가 처음부터 끝까지 맡는 구조입니다. DB 응답이나 외부 API 응답을 기다리는 동안에도 그 스레드는 다른 일을 하지 못하고 동시 요청이 늘면 스레드도 같은 비율로 늘어야 합니다. Spring WebFlux 는 같은 문제를 반대쪽에서 풉니다. 기다리는 동안 스레드를 붙잡지 않도록 서버 전체를 논블로킹으로 만들었고 Spring Framework 5.0 에서 추가되었습니다. 이 글의 기준은 Spring Boot 3.1(Spring Framework 6.0, Reactor BOM 2022.0 계열)입니다.
두 개의 웹 스택
Spring Framework 에는 웹 프레임워크가 둘 있고 모듈 이름도 그대로 spring-webmvc 와 spring-webflux 입니다. 두 모듈은 서로 독립이라 하나만 써도 되고 둘을 함께 쓸 수도 있습니다. 공식 문서가 드는 예가 Spring MVC 컨트롤러에서 리액티브 WebClient 를 쓰는 경우입니다. 같은 프로젝트에 spring-boot-starter-web 과 spring-boot-starter-webflux 를 모두 넣으면 Spring Boot 는 MVC 를 자동 구성하고 WebFlux 는 쓰지 않습니다.
| Spring MVC | Spring WebFlux | |
|---|---|---|
| 기반 | Servlet API, 서블릿 컨테이너 | Reactive Streams, Reactor |
| 실행 가능한 서버 | Tomcat, Jetty, Undertow | Netty, Tomcat, Jetty, Undertow |
| 스레드 가정 | 현재 스레드를 막아도 된다 | 현재 스레드를 막지 않는다 |
| 컨트롤러 반환 | 일반 객체, 일부 reactive 타입 | Mono, Flux 같은 reactive 타입, 코루틴 |
Spring Boot 가 WebFlux 에서 기본으로 고르는 서버는 Netty 입니다. 문서는 Netty 가 비동기·논블로킹 영역에서 더 널리 쓰이고 클라이언트와 서버가 자원을 공유할 수 있다는 점을 이유로 듭니다.
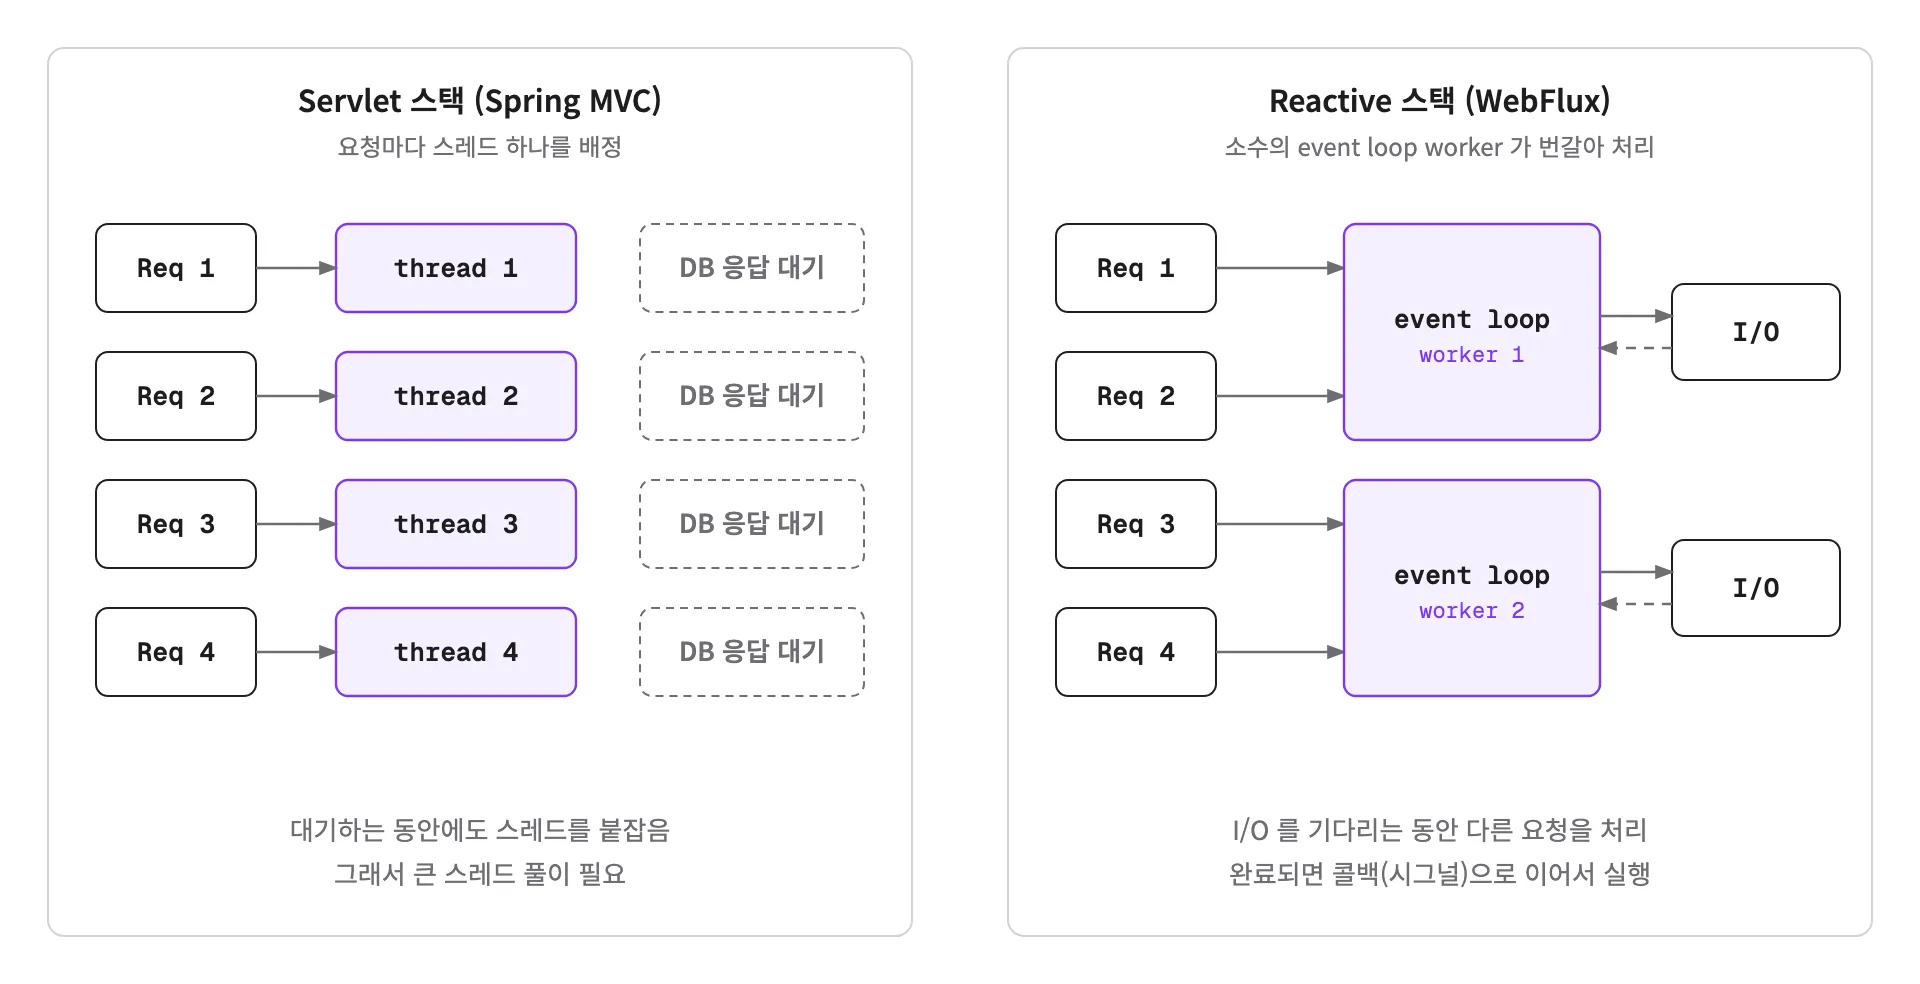
스레드 모델의 차이
Spring MVC 는 애플리케이션이 현재 스레드를 막아도 된다고 가정합니다. 그래서 서블릿 컨테이너는 대기 시간을 흡수할 만큼 큰 스레드 풀을 둡니다. WebFlux 는 반대로 애플리케이션이 스레드를 막지 않는다고 가정하고 작고 크기가 고정된 풀(event loop worker)로 요청을 처리합니다. 문서의 설명에 따르면 별다른 의존성이 없는 WebFlux 서버에서는 서버용 스레드 하나와 요청 처리용 스레드 몇 개(보통 CPU 코어 수만큼)를 볼 수 있습니다.
스레드가 적은데 확장된다는 말은 모순처럼 들리지만 스레드를 막지 않으면 대기를 흡수할 여분의 스레드가 필요하지 않다는 뜻입니다. 대기가 필요한 지점에서는 I/O 를 요청해 두고 곧바로 다른 요청으로 넘어가며 결과가 도착하면 콜백(Reactor 에서는 신호)으로 이어서 실행합니다. 아래 애니메이션은 스레드 하나가 세 요청을 겹쳐 처리하는 흐름입니다.
이 모델에는 부수 효과가 하나 있습니다. Reactor 나 RxJava 에서는 연산자로 로직을 선언하고 런타임에는 데이터가 단계별로 순차 처리되는 파이프라인이 만들어집니다. 파이프라인 안의 애플리케이션 코드는 동시에 호출되지 않으므로 가변 상태를 보호하려고 락을 잡을 필요가 줄어듭니다.
Reactive Streams 와 backpressure
논블로킹 코드에서는 이벤트가 들어오는 속도를 조절하는 문제가 생깁니다. 빠른 생산자가 느린 소비자를 압도하지 않게 해야 하기 때문입니다. 블로킹 코드는 호출이 막히는 것 자체가 자연스러운 제동 장치였지만 논블로킹에서는 그 장치가 없습니다. Reactive Streams 는 이 문제를 위해 만들어진 표준으로, 비동기 스트림 처리를 논블로킹 backpressure 와 함께 다루는 것이 목적이라고 소개합니다.
약속의 중심에는 구독자가 생산자의 속도를 정한다는 규칙이 있습니다. 구독자는 Subscription 을 통해 지금 n 개까지 받을 수 있다고 알리고 생산자는 그 수를 넘지 않게 값을 보냅니다. 요청 수를 무제한으로 주면 값이 오는 대로 받는 push 방식이 되고 요청 수를 제한하면 push 와 pull 이 섞인 방식이 됩니다. 생산자가 속도를 늦출 수 없는 경우에는 버퍼에 쌓을지, 버리거나 실패시킬지를 정해야 합니다. 표준은 Publisher, Subscriber, Subscription, Processor 네 인터페이스로 구성됩니다. JDK 9 부터는 java.util.concurrent.Flow 에 의미가 같은 인터페이스가 들어 있습니다.
Spring 문서는 Reactive Streams 가 라이브러리와 인프라 사이의 상호운용에는 중요하지만 애플리케이션 API 로 쓰기에는 너무 저수준이라고 말합니다. 그래서 애플리케이션 코드는 보통 Reactor 의 Mono 와 Flux 를 씁니다.
Mono 와 Flux
Flux 는 0개에서 N개의 값을, Mono 는 0개 또는 1개의 값을 내보내는 시퀀스입니다. 두 타입 모두 값(onNext)과 종료(onComplete), 오류(onError) 신호로 이루어지고 연산자(map, flatMap, filter 등)를 이어 붙여 변환합니다. 연산자는 Reactive Streams 를 따르기 때문에 모두 논블로킹 backpressure 를 지원합니다. count 처럼 개수가 바뀌는 연산자는 Flux 에서 Mono<Long> 을 돌려주기도 합니다.
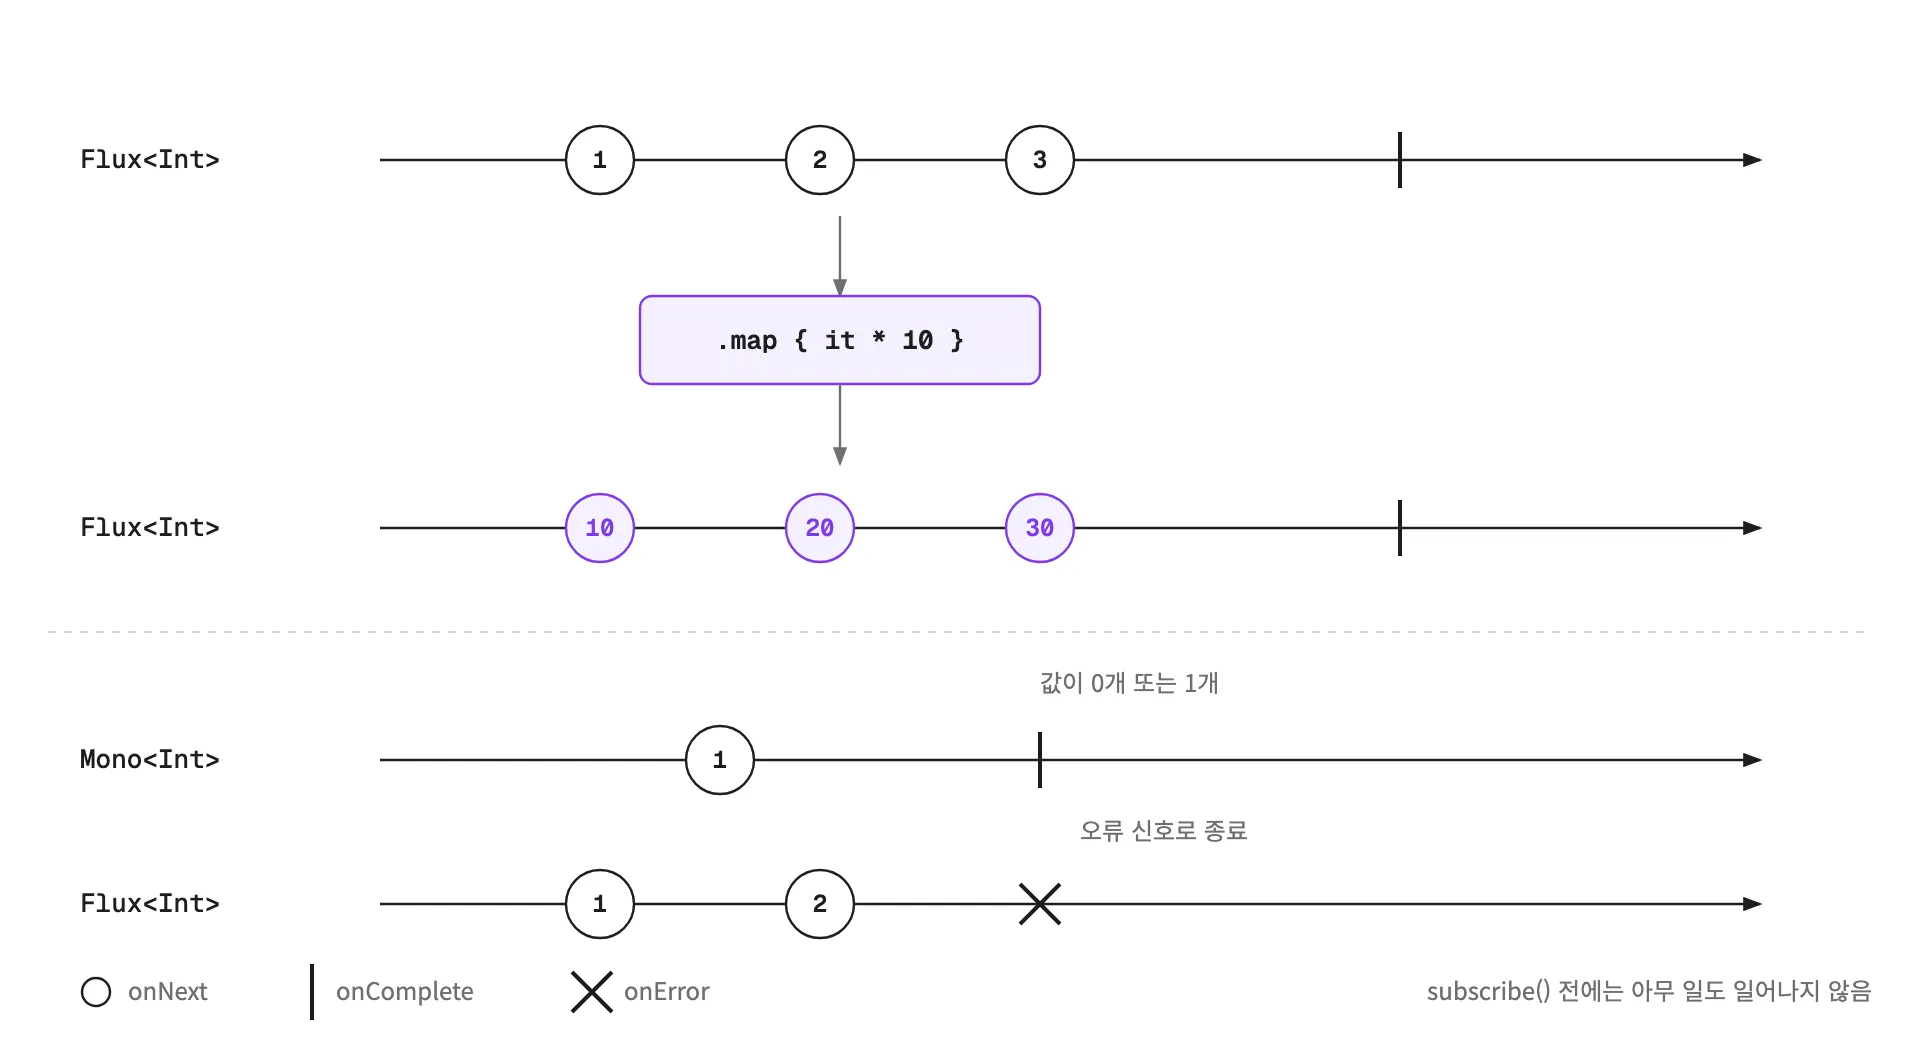
가장 먼저 부딪히는 특징은 게으름입니다. 연산자를 이어 붙이는 것은 처리 과정의 설명을 만드는 일이고 데이터는 구독하는 순간에야 흐르기 시작합니다.
val numbers: Flux<Int> = Flux.just(1, 2, 3).map { it * 10 }   // 아직 아무 일도 일어나지 않음
numbers.subscribe { println(it) }                              // 이 시점에 10, 20, 30 출력
WebFlux 컨트롤러에서는 프레임워크가 구독을 대신합니다. 컨트롤러는 Mono 나 Flux 를 돌려주기만 하면 됩니다.
컨트롤러, WebClient, R2DBC
WebFlux 의 프로그래밍 모델은 둘입니다. 하나는 spring-web 의 어노테이션을 그대로 쓰는 어노테이션 컨트롤러이고 다른 하나는 라우팅과 처리를 함수로 표현하는 함수형 엔드포인트(WebFlux.fn)입니다. 문서는 어노테이션 컨트롤러가 Spring MVC 와 같은 어노테이션을 쓰고 둘 다 reactive 반환 타입을 지원하기 때문에 겉으로 구분하기 쉽지 않다고 설명합니다.
서버가 논블로킹이면 서버가 호출하는 쪽도 논블로킹이어야 의미가 있습니다. HTTP 호출에는 WebClient, 관계형 DB 접근에는 R2DBC 가 그 자리를 맡습니다. WebClient 는 Reactor 기반의 함수형 fluent API 를 가진 완전한 논블로킹 클라이언트입니다. 실제 요청은 Reactor Netty, JDK HttpClient, Jetty Reactive HttpClient, Apache HttpComponents 같은 HTTP 클라이언트 라이브러리가 처리합니다. R2DBC(Reactive Relational Database Connectivity)는 관계형 DB 에 reactive API 를 제공하는 프로젝트입니다. Reactive Streams 를 기반으로 하고 드라이버 쪽 SPI 를 정의합니다. PostgreSQL, MySQL, MariaDB, H2, SQL Server, Oracle 등을 위한 드라이버가 있습니다. Spring Data R2DBC 는 그 위에서 R2dbcEntityTemplate 과 리포지토리 지원을 제공합니다. 문서는 R2dbcEntityTemplate 을 Spring Data R2DBC 의 중심 진입점으로 소개하며, 엔티티 단위로 조회·삽입·수정·삭제하는 메서드를 제공한다고 설명합니다.
data class User(@Id val id: Long?, val name: String)
data class Score(val value: Int)
data class Profile(val name: String, val score: Int)

interface UserRepository : ReactiveCrudRepository<User, Long>

@RestController
class ProfileController(builder: WebClient.Builder, private val users: UserRepository) {
    private val client = builder.baseUrl("https://api.example.com").build()

    @GetMapping("/profiles/{id}")
    fun profile(@PathVariable id: Long): Mono<Profile> =
        users.findById(id).flatMap { user ->
            client.get().uri("/scores/{name}", user.name)
                .retrieve()
                .bodyToMono(Score::class.java)
                .map { Profile(user.name, it.value) }
        }
}
사용자를 DB 에서 읽고 그 이름으로 외부 API 를 호출해 합친 결과를 돌려주는 흐름입니다. 두 I/O 모두 논블로킹이라 대기 시간 동안 스레드가 풀려 있습니다. WebFlux 는 Reactor 를 핵심 의존성으로 요구하지만 Reactive Streams 를 통해 다른 reactive 라이브러리와도 연동됩니다.
Kotlin 코루틴으로 쓰기
연산자 체인이 부담스러우면 코루틴으로 같은 코드를 순차 스타일로 쓸 수 있습니다. Spring 문서의 Kotlin 코루틴 항목에 따르면 kotlinx-coroutines-core 와 kotlinx-coroutines-reactor 가 클래스패스에 있을 때 코루틴 지원이 켜지며 어노테이션 컨트롤러에서 suspend 함수와 Flow 반환을 쓸 수 있습니다. 대응 관계는 Mono<T> 가 suspend fun(): T, Flux<T> 가 Flow<T> 입니다. 이 지원은 Spring MVC 와 WebFlux 의 어노테이션 컨트롤러에 모두 적용됩니다.
@RestController
class CoProfileController(builder: WebClient.Builder, private val users: UserRepository) {
    private val client = builder.baseUrl("https://api.example.com").build()

    @GetMapping("/co/profiles/{id}")
    suspend fun profile(@PathVariable id: Long): Profile {
        val user = users.findById(id).awaitSingleOrNull()
            ?: throw ResponseStatusException(HttpStatus.NOT_FOUND)
        val score = client.get().uri("/scores/{name}", user.name).retrieve().awaitBody<Score>()
        return Profile(user.name, score.value)
    }

    @GetMapping("/co/users")
    fun all(): Flow<User> = users.findAll().asFlow()
}
awaitSingleOrNull() 은 Mono 의 결과를, awaitBody() 는 WebClient 응답 본문을 일시 중단 지점에서 기다리는 확장 함수입니다. 사용자가 없으면 Mono 가 비어 있으므로 null 로 받아 404 로 바꿉니다. 문서는 Flow 가 push 기반이고 Flux 는 push-pull 혼합이며 Flow 의 backpressure 는 일시 중단 함수로 구현된다고 설명합니다.
이벤트 루프를 막는 호출
이 모델에서 가장 흔한 사고는 이벤트 루프 스레드에서 블로킹 호출을 하는 것입니다. 이벤트 루프 스레드는 코어 수 정도뿐이라, 거기서 Thread.sleep() 이나 JDBC 호출, 동기 HTTP 클라이언트처럼 막히는 코드가 실행되면 그 스레드가 맡은 모든 요청이 함께 멈춥니다. Reactor 는 기본 single 과 parallel 스케줄러 안에서 block() 같은 블로킹 API 를 부르면 IllegalStateException 을 던집니다. 다만 모든 블로킹 호출을 이런 식으로 막아 주지는 않습니다.
피할 수 없는 블로킹 라이브러리는 별도 스레드로 옮깁니다. Reactor 문서는 Schedulers.boundedElastic() 이 블로킹 작업에 자기 스레드를 주어 다른 자원을 붙잡지 않게 하는 방법이며 I/O 블로킹에 더 나은 선택이라고 설명합니다. Spring 문서도 publishOn 연산자로 다른 스레드에서 처리를 이어갈 수 있다고 소개하면서 그래도 블로킹 API 는 이 동시성 모델과 어울리지 않는다고 덧붙입니다.
fun wrapBlocking(legacy: LegacyClient, id: Long): Mono<String> =
    Mono.fromCallable { legacy.fetch(id) }          // 블로킹 라이브러리 호출
        .subscribeOn(Schedulers.boundedElastic())   // 전용 스레드 풀에서 실행
실수로 들어간 블로킹 호출은 BlockHound 로 찾습니다. BlockHound 는 JVM 클래스를 계측해 논블로킹으로 표시된 스레드(예를 들어 Schedulers.parallel() 의 스레드)에서 블로킹 호출이 일어나면 오류를 내는 Java 에이전트입니다. 테스트 의존성으로 추가하고 코드가 실행되기 전에 BlockHound.install() 을 호출하면, 잡힌 호출이 Blocking call! java.lang.Thread.sleep 같은 오류와 스택 트레이스로 보고됩니다. JDK 13 이상에서는 네이티브 메서드 재정의가 막혀 있어 테스트 실행에 -XX:+AllowRedefinitionToAddDeleteMethods JVM 인자가 필요하다고 README 는 안내합니다.
같은 이유로 문서는 WebFlux 애플리케이션에서 서블릿 필터를 매핑하거나 Servlet API 를 직접 다루는 것을 강하게 말립니다. 한 컨텍스트에서 블로킹 I/O 와 논블로킹 I/O 를 섞으면 런타임 문제가 생긴다고 경고합니다.
언제 WebFlux 를 쓰는가
공식 문서의 안내는 도입에 신중합니다. 잘 동작하는 Spring MVC 애플리케이션이 있다면 바꿀 이유가 없고 명령형 프로그래밍이 코드를 쓰고 이해하고 디버깅하기에 가장 쉽다고 말합니다. 판단의 출발점으로는 의존성 점검을 권합니다. JPA 나 JDBC 같은 블로킹 영속성 API, 또는 블로킹 네트워크 API 를 써야 한다면 적어도 일반적인 구조에서는 Spring MVC 가 가장 좋은 선택입니다. Reactor 와 RxJava 모두 블로킹 호출을 별도 스레드에서 수행하게 할 수는 있지만 논블로킹 스택의 이점을 제대로 누리지 못합니다.
성능에 대한 설명도 기대를 조정합니다. reactive 와 논블로킹이 애플리케이션을 더 빠르게 만들지는 않으며 WebClient 로 원격 호출을 병렬 실행하는 것처럼 빨라지는 경우가 있을 뿐입니다. 기대할 수 있는 핵심 이점은 작고 고정된 수의 스레드와 더 적은 메모리로 확장하는 능력입니다. 이 이점을 보려면 느리고 예측하기 어려운 네트워크 I/O 가 섞인 어느 정도의 지연 시간이 있어야 합니다. 팀 규모가 크다면 논블로킹, 함수형, 선언형으로 넘어가는 가파른 학습 곡선도 고려 대상입니다.
중간 지점도 있습니다. 원격 서비스를 호출하는 Spring MVC 애플리케이션이라면 리액티브 WebClient 를 먼저 써 볼 수 있습니다. MVC 컨트롤러 메서드가 Mono 나 Flux 를 직접 반환할 수도 있습니다. 이때 스트리밍 응답을 쓰는 동작은 여전히 블로킹이고 별도 스레드에서 실행된다는 점은 알아 두어야 합니다.
가상 스레드와의 관계
이 글을 쓰는 시점에 JDK 21 은 아직 출시 전입니다. OpenJDK 일정상 GA 는 2023년 9월 19일이고 가상 스레드(JEP 444)가 포함됩니다. 가상 스레드는 블로킹 코드를 유지한 채 스레드 수의 한계를 완화하려는 접근이라 위의 의존성 기준에 영향을 줄 수 있습니다. 다만 Spring Boot 3.1 이 가상 스레드를 지원한다고 문서로 확인되는 내용은 없어서 프레임워크 쪽 지원은 JDK 21 이 나온 뒤 릴리즈 노트로 확인해야 합니다. 다만 Spring 팀은 2022년 10월 블로그 글 「Embracing Virtual Threads」에서 JDK 19 프리뷰 기준으로 Tomcat 의 요청 처리 실행기를 가상 스레드로 바꾸는 설정 예를 보여 주었고, Loom 이 프리뷰를 벗어나면 정식 설정 옵션을 제공하겠다고 밝혔습니다.
참고 자료
- Spring Framework Reference: Spring WebFlux
- Spring Framework Reference: WebFlux Overview
- Spring Framework Reference: Reactive Core
- Spring Framework Reference: Functional Endpoints
- Spring Framework Reference: WebClient
- Spring Framework Reference: Coroutines
- Spring Framework Reference: Asynchronous Requests (Spring MVC)
- Spring Boot 3.1 Reference: Reactive Web Applications
- Spring Boot 3.1 Reference: System Requirements
- Spring Boot 3.1 Release Notes
- Spring Blog: Embracing Virtual Threads (2022-10-11)
- Spring Data Relational: R2DBC
- Spring Data R2DBC: Template API
- Reactor Reference: Introduction to Reactive Programming
- Reactor Reference: Core Features
- Reactor Reference: Threading and Schedulers
- Reactor BlockHound
- Reactive Streams
- R2DBC
- JDK 21