SOLID 는 객체지향 설계에서 클래스와 모듈이 서로를 얼마나 알아야 하는지를 다섯 가지로 나눈 원칙입니다. 그래서 이 글에서는 제가 혼자 만든 문서 리더 TeddReader의 코드를 기준으로 삼았습니다. 저장소 구조는 앞선 글에서 정리했고, 여기서는 그 구조를 원칙별로 다시 읽습니다. 인용한 코드는 마지막 푸시(2026-09-29) 시점의 저장소 그대로이며 길어서 줄인 곳에는 ...을 적었습니다. 지켜진 곳만 고르지 않으려고 원칙에서 벗어난 곳도 같이 적었습니다.
출처
SOLID 의 원칙들은 Robert C. Martin 이 정리했습니다. 2000년 논문 “Design Principles and Design Patterns”는 소프트웨어가 시간이 지나면 “rot” 해 간다는 문제의식에서 시작해, OCP, LSP, DIP, ISP 를 의존성 관리의 원칙으로 소개합니다. SRP 는 이 논문 본문에는 없고, Martin 의 책 Agile Software Development, Principles, Patterns, and Practices(2002) 9장에 해당하는 SRP 문서에서 “각 책임은 변경의 축”이라는 설명과 함께 나옵니다. 이 문서는 원칙의 뿌리를 Tom DeMarco 와 Meilir Page-Jones 의 응집도(cohesion)로 듭니다. 약어 SOLID 자체는 Wikipedia 의 SOLID 항목에 따르면 2004년경 Michael Feathers 가 붙였습니다.
개별 원칙에는 더 오래된 뿌리가 있습니다. OCP 는 Bertrand Meyer 가 1988년 책 Object-Oriented Software Construction에서 만들었고, Martin 은 이를 “소프트웨어 개체는 확장에는 열려 있고 수정에는 닫혀 있어야 한다”로 옮겼습니다. LSP 는 Barbara Liskov 가 1987년 OOPSLA 기조연설 “Data Abstraction and Hierarchy”에서 처음 제시했습니다. 1994년에는 Liskov 와 Jeannette Wing 이 논문 “A behavioral notion of subtyping”(ACM TOPLAS 16(6))에서 이를 형식화했습니다. 타입 T 의 객체에 대해 증명되는 성질은 T 의 하위 타입 S 의 객체에 대해서도 성립해야 한다는 요구입니다. Martin 의 2000년 논문은 LSP 를 “하위 클래스는 기반 클래스를 대체할 수 있어야 한다”고 한 줄로 쓰고, Meyer 의 계약에 의한 설계(Design by Contract)에서도 나온 개념이라고 덧붙입니다.
이 원칙들이 막으려는 것
Martin 의 논문은 설계가 썩어 가는 증상으로 경직성(rigidity), 취약성(fragility), 부동성(immobility), 점착성(viscosity) 네 가지를 들고, 그 원인을 모듈 사이의 잘못된 의존성 하나로 짚습니다. 이 글에서는 원칙이 지켜졌는지를 아래 세 가지로 확인합니다. 논문의 분류가 아니라 이 글이 정한 확인 기준입니다.
- 변경이 퍼지는 범위가 좁아집니다. 화면을 고쳐도 저장소 코드가 바뀌지 않아야 합니다.
- 테스트가 쉬워집니다. 협력 객체를 가짜로 바꿀 수 있어야 합니다.
- 구현을 바꿔 끼울 수 있습니다. Android 와 iOS 가 같은 호출 코드를 쓰면서 다른 구현을 받을 수 있어야 합니다.
아래에서 각 원칙이 TeddReader 의 어느 코드에서 이 세 가지로 나타나는지 봅니다.
SRP: 변경의 이유가 하나인 클래스
Martin 의 SRP 문서는 클래스를 바꿔야 하는 이유가 둘 이상이면 책임이 서로 얽혀서 한 책임의 변경이 다른 책임을 깨뜨릴 수 있다고 설명합니다. 기준은 “바꿔야 하는 이유가 하나”입니다.
ReaderRepositoryImpl은 읽던 위치 저장만 합니다. 생성자 인자가 DAO 하나입니다.
// core/data/.../repository/ReaderRepositoryImpl.kt
@Single(binds = [ReaderRepository::class])
class ReaderRepositoryImpl(
    private val progressDao: ReadingProgressDao,
) : ReaderRepository {
    override fun observeProgress(documentId: DocumentId): Flow<ReadingProgress?> =
progressDao.observeProgress(documentId.value).map { it?.toReadingProgress() }DocumentFormatDetector는 파일이 어떤 형식인지만 판별하고, 페이지 경계는 TextPageLayoutEngine만 정합니다.
비껴간 곳도 있습니다. DocumentRepositoryImpl.kt는 3507줄이고, DocumentRepositoryImpl의 생성자가 협력 객체 11개를 받습니다. DAO 세 개, 형식 감지기, 파서 다섯 개, 페이지 레이아웃 엔진, 파일 소스입니다. 파일 안에는 Mutex 필드가 여섯 개 있습니다. 문서 캐시, 페이지 나누기 이어 가기, EPUB 가져오기(세 개), CBZ 임시 파일용이고, 문서별 EPUB 가져오기 락 맵도 따로 있습니다. 표지는 DocumentCoverStore라는 별도 클래스로 이미 빠져 있지만, CBZ 표지는 페이지 요청과 같은 락을 써야 해서 이 클래스에 남아 있다고 KDoc 이 적습니다. 가져오기, 페이지 나누기, 폴더 관리가 한 클래스를 바꾸는 서로 다른 이유입니다.
SearchDocumentUseCase도 비껴간 예입니다. 이 유스 케이스는 문서가 텍스트 검색을 지원하는 형식인지 확인하고, 검색어를 다듬고 길이와 결과 수에 상한을 건 뒤 실제 검색을 SearchRepository에 넘깁니다. 다만 앞뒤 공백 제거, 빈 검색어 처리, limit의 하한은 SearchRepositoryImpl에도 똑같이 들어 있고, SearchRepository의 KDoc 은 이 정규화가 저장소 쪽 규칙이라고 적습니다. 같은 규칙이 두 계층에 있어서, 이 규칙을 바꾸려면 두 곳을 같이 고쳐야 합니다.
OCP: 코드를 고치지 않고 구현을 추가하는 자리
PDF 의 페이지 수와 표지를 읽는 일은 플랫폼마다 다릅니다. PdfDocumentParser는 그 부분을 PdfMetadataReader라는 fun interface로 받습니다.
// core/data/.../parser/PdfMetadataReader.kt
fun interface PdfMetadataReader {
    fun pageCount(location: DocumentLocation, bytes: ByteArray?): Int
    fun coverImageBytes(location: DocumentLocation, bytes: ByteArray?): ByteArray? = null
}

internal expect fun defaultPdfMetadataReader(): PdfMetadataReader

// core/data/.../parser/PdfDocumentParser.kt
@Single
class PdfDocumentParser(
    private val metadataReader: PdfMetadataReader = defaultPdfMetadataReader(),
)
기본값은 expect 함수가 정하고, androidMain의 actual은 AndroidPdfMetadataReader()를, iosMain의 actual은 IosPdfMetadataReader()를 돌려줍니다. 파서 코드는 어느 플랫폼에서도 같고 새 플랫폼 구현은 새 파일이 됩니다. Martin 의 2000년 논문이 OCP 를 설명하는 방식과 같은 모양입니다. 모듈이 고정된 추상에 의존하고, 그 추상의 구현이 새로 생기는 식으로 동작이 늘어납니다.
반대로 새 문서 형식을 추가하는 일은 OCP 를 따르지 않습니다. DocumentRepositoryImpl.importDocument는 감지한 형식으로 when을 열고 분기마다 해당 파서를 직접 부릅니다.
// core/data/.../repository/DocumentRepositoryImpl.kt
val format = formatDetector.detect(source.location, source.bytes)
val document = when (format) {
    DocumentFormat.TXT -> txtDocumentParser.parse(...)
    DocumentFormat.EPUB -> ...
    DocumentFormat.PDF -> pdfDocumentParser.parse(...)
    DocumentFormat.CBZ -> ...
    DocumentFormat.IMAGE -> imageDocumentParser.parse(...)
    DocumentFormat.UNKNOWN -> throw IllegalArgumentException(...)
}
다섯 파서는 공통 인터페이스가 없는 구체 클래스입니다. parse의 인자도 파서마다 다릅니다. TXT 는 디코딩한 문자열을, PDF 는 위치와 바이트를 받습니다. 그래서 형식 하나를 더하려면 DocumentFormat, DocumentFormatDetector, 이 when, 생성자 인자에 더해 getDocumentCover와 DocumentCoverStore.extract, 문서 정보 화면의 형식 레이블에 있는 when까지 손대야 합니다.
LSP: 바꿔 끼워도 호출하는 쪽이 모르는 구현
Martin 이 1996년 DIP 칼럼 서두에서 요약한 LSP 의 조건은, 하위 타입의 함수가 기반 타입이 요구한 것 이상을 요구하지 않고 약속한 것 이하를 약속하지 않는다는 것입니다. 그렇지 않으면 호출하는 쪽이 실제 타입을 확인해야 하고, 그것이 OCP 위반으로 이어진다고 설명합니다.
DocumentFileSource는 문서의 바이트에 닿는 방법을 추상화한 인터페이스이고 구현이 둘입니다. Android 의 AndroidDocumentFileSource는 file://이면 파일로, 그 밖에는 ContentResolver로 읽습니다. iOS 의 IosDocumentFileSource는 샌드박스 경로를 Okio 로 읽습니다. 인터페이스의 KDoc 은 readBytes가 문서에 더 이상 닿을 수 없을 때, 예를 들어 Android 에서 SAF 권한이 취소됐거나 파일이 옮겨지거나 지워졌을 때 IllegalStateException을 던진다고 적습니다. iOS 구현은 경로를 찾지 못하면 error()로 이 계약을 지킵니다. Android 구현은 경로나 스트림이 null일 때만 error()를 부르고, 파일이 사라진 file://이면 File.readBytes()가, 열 수 없는 content://이면 ContentResolver.openInputStream이 각자의 예외(FileNotFoundException, 권한이 없으면 SecurityException)를 그대로 올립니다. DocumentRepositoryImpl은 이 호출을 suspendRunCatching으로 감싸 취소 외의 모든 예외를 실패로 받기 때문에, 예외 타입이 달라도 지금은 동작에 차이가 없습니다.
// core/data/.../storage/DocumentFileSource.kt (계약)
/** @throws IllegalStateException [location]에 더 이상 도달할 수 없을 때 ... */
suspend fun readBytes(location: DocumentLocation): ByteArray

// core/data/src/androidMain/.../AndroidDocumentFileSource.kt
?: error("Cannot open document: ${location.sourceUri}")

// core/data/src/iosMain/.../IosDocumentFileSource.kt
val path = resolveExistingPath(location) ?: error("Cannot open document: ${location.sourceUri}")
Kotlin 의 error()는 IllegalStateException을 던집니다. materialize와 deleteMaterialized에는 아무것도 하지 않는 기본 구현이 인터페이스에 있고, 두 플랫폼 구현이 둘 다 덮어씁니다. KDoc 은 이 기본값을 앱 소유 사본을 만들지 않는 파일 소스를 위한 무동작이라고 적습니다. 같은 이유로 DocumentRepository의 일부 메서드도 기본 구현이 있고, KDoc 은 그 기본값이 “할 일 없음”과 “이 문서가 아님”을 오류 대신 isComplete = true로 돌려주는 응답이라고 설명합니다.
다만 DocumentFileSource를 쓰는 테스트는 저장소 테스트에 들어가는 가짜 소스 일곱 개(FakeDocumentFileSource, PartialFailingDocumentFileSource, MultiLocationDocumentFileSource, BatchCrudDocumentFileSource, AndroidFakeDocumentFileSource, CopyGatedFileSource, InMemoryFileSource)와, 원자 복사와 경로 규칙을 확인하는 DocumentFileSourceTest입니다. AndroidDocumentFileSource와 IosDocumentFileSource를 직접 검사하는 테스트는 없습니다. 위에서 본 예외 타입 차이도 테스트에 잡히지 않습니다.
ISP: 클라이언트마다 따로 좁게
ISP 는 Martin 이 1996년 C++ Report 칼럼에서 “클라이언트는 자신이 쓰지 않는 인터페이스에 의존하도록 강제되어서는 안 된다”로 정리했고, 2000년 논문에서는 “여러 개의 클라이언트별 인터페이스가 하나의 범용 인터페이스보다 낫다”고 썼습니다. 칼럼은 클라이언트가 쓰지 않는 인터페이스에 의존하면 그 인터페이스의 변경에 영향을 받는다고 설명합니다.
core:domain의 저장소 인터페이스는 대부분 한 가지 클라이언트 관심사별로 갈라져 있습니다.
| 인터페이스 | 멤버 |
|---|---|
SearchRepository | findInDocument 하나 |
ReadingStatsRepository | observeSessions, recordSession, getStats |
ReaderRepository | observeProgress, getProgress, saveProgress, deleteProgress |
BookmarkRepository | observeBookmarks, getBookmark, saveBookmark, deleteBookmark |
SearchRepository의 KDoc 은 쓰기를 일부러 넣지 않았다고 이유까지 적어 두었습니다. 검색이 읽는 테이블이 문서를 가져올 때 한 번만 기록되는 곳과 같아서, 두 번째 쓰기 경로가 있으면 저장된 문서를 덮어쓸 수 있기 때문입니다. 문서 정보 화면의 DocumentInfoViewModel은 GetDocumentInfoUseCase와 ReadingStatsRepository만 받으므로, 소스에서 북마크나 설정 저장소를 참조하지 않습니다. 다만 저장소 인터페이스가 모두 core:domain 한 모듈에 있고 유스 케이스가 DocumentRepository를 받으므로, 빌드 단위로는 여전히 함께 묶입니다.
비껴간 곳은 DocumentRepository입니다. 이 인터페이스에는 멤버 24개가 있습니다. 목록 구독, 표지, 임베디드 이미지와 글꼴, 페이지 창, 가져오기, 폴더 관리, 페이지 나누기 이어 가기까지입니다. HomeViewModel은 이 중 observeRecentDocuments, getDocumentCover, setDocumentsBookmarked, setDocumentsFolder, renameFolder, clearFolder, deleteDocuments 일곱 개만 씁니다. 대신 24개 중 16개에 기본 구현이 있어서 DocumentInfoViewModelTest의 FakeDocumentRepository는 기본 구현이 없는 8개만 덮어쓰면 되지만, 인터페이스 자체는 분리되지 않았습니다.
DIP: 의존성의 방향
Martin 의 1996년 DIP 칼럼은 원칙을 A, B 두 항목으로 씁니다. “A. High level modules should not depend upon low level modules. Both should depend upon abstractions. B. Abstractions should not depend upon details. Details should depend upon abstractions.” (원문은 대문자)
TeddReader 에서 이 방향은 모듈 의존성으로 드러납니다. 문서 정보 기능을 예로 그리면 아래와 같습니다. 화살표는 build-logic의 컨벤션 플러그인이 연결하는 의존성 중 이 설명에 필요한 것만 골라 그렸습니다. app:reader가 core:domain, core:room, core:datastore에도 직접 의존하는 선과 core:data → core:datastore는 생략했습니다.
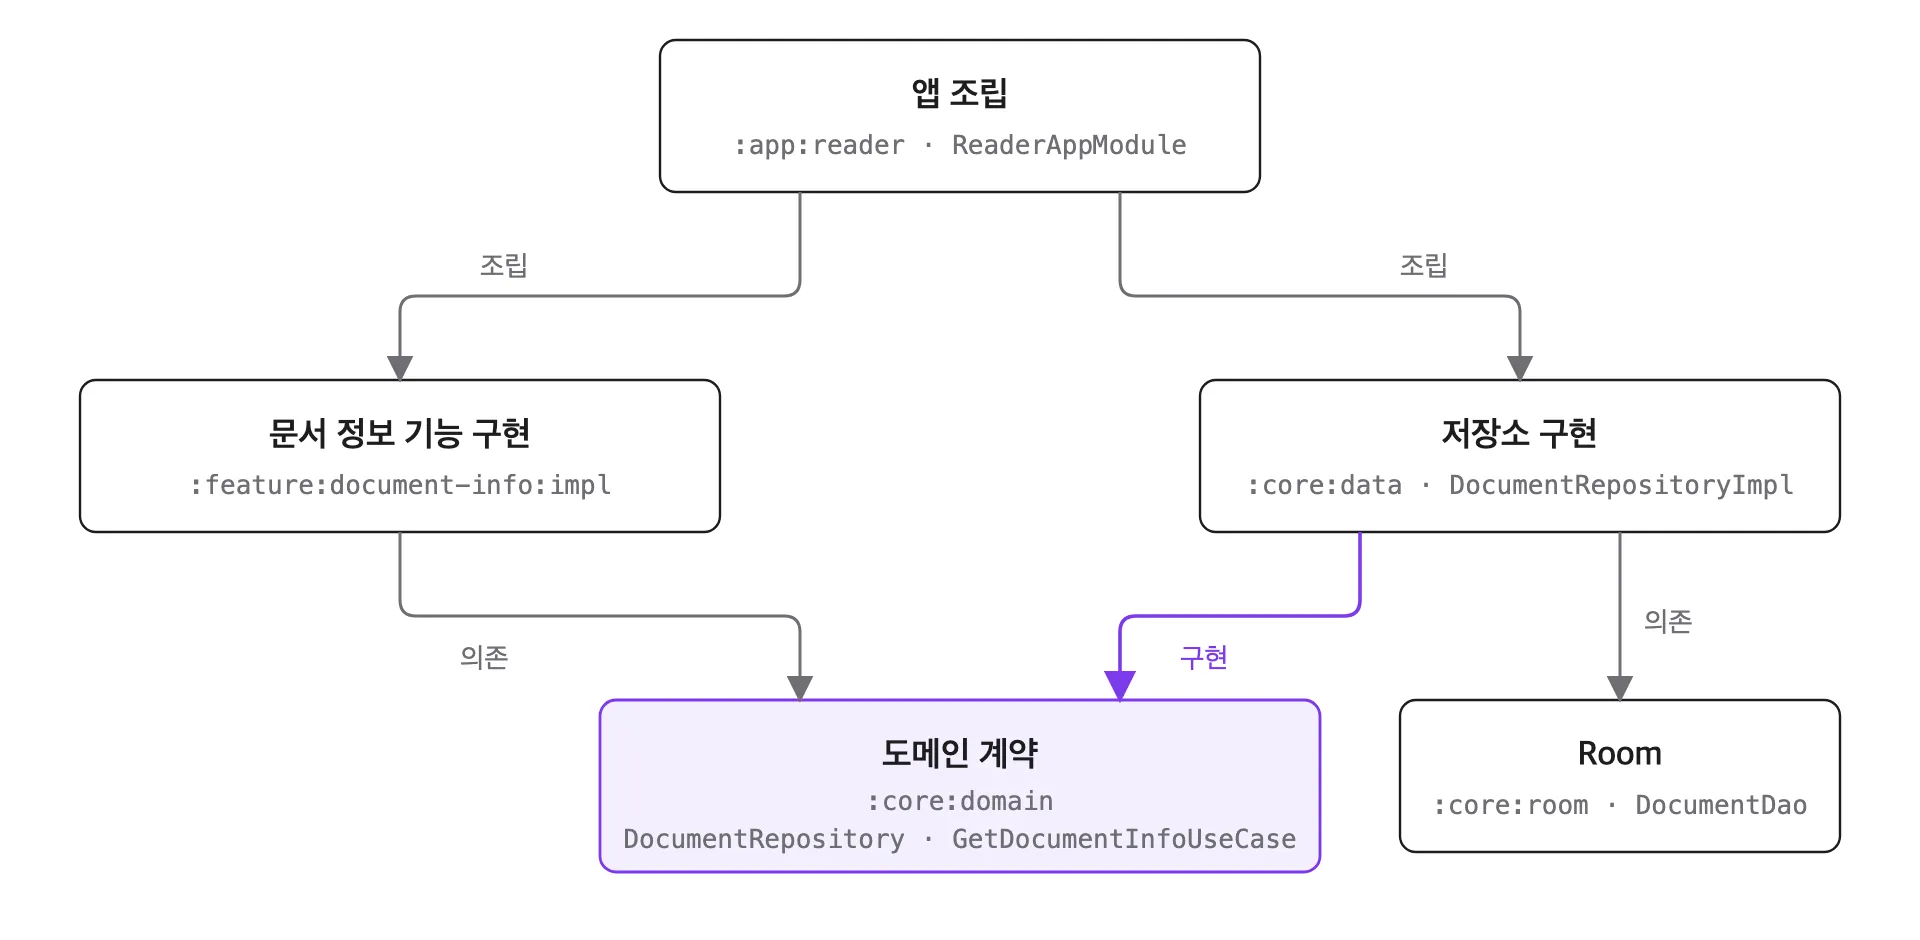
teddreader.feature.impl 플러그인은 implementation(project(":core:domain"))을 넣고 :core:data는 넣지 않습니다. 저장소 쪽 teddreader.core.data 플러그인은 반대로 api(project(":core:domain"))을 넣습니다. 높은 수준의 정책인 기능과 낮은 수준의 세부인 Room 접근이 둘 다 core:domain의 추상에 의존하고, 구현이 추상 쪽으로 화살표를 돌립니다.
코드에서는 생성자 인자 타입이 이 방향을 보여 줍니다.
// core/domain/.../usecase/GetDocumentInfoUseCase.kt
@Single
class GetDocumentInfoUseCase(
    private val documentRepository: DocumentRepository,
    private val readerRepository: ReaderRepository,
    private val readingStatsRepository: ReadingStatsRepository,
)
구현은 @Single(binds = [ReaderRepository::class]) 같은 어노테이션으로 인터페이스에 묶입니다. 플랫폼 구현은 PlatformReaderModule의 actual 쪽에서 구체 타입을 만든 뒤 인터페이스 타입으로 한 번 더 내보냅니다. iOS 는 iosDocumentFileSource()가 IosDocumentFileSource를 만들고 documentFileSource(source)가 같은 인스턴스를 DocumentFileSource로 노출합니다. 조립은 앞선 글에서 본 ReaderAppModule이 합니다.
테스트에서 이 구조를 확인할 수 있습니다. SearchDocumentUseCaseTest는 FakeDocuments와 RecordingSearchRepository만으로 유스 케이스를 만듭니다.
// core/domain/src/commonTest/.../SearchDocumentUseCaseTest.kt
val search = RecordingSearchRepository()
val useCase = SearchDocumentUseCase(FakeDocuments(DocumentFormat.EPUB), search)
val result = useCase(documentId, "  reader  ", limit = 0)
데이터베이스도 기기도 필요 없고 commonTest에서 JVM 과 iOS 시뮬레이터 양쪽으로 돌립니다. PdfDocumentParserTest도 같은 방식으로 object : PdfMetadataReader를 만들어 파서에 넘깁니다.
DIP 가 꺾인 곳도 있습니다. DocumentRepositoryImpl의 생성자는 TxtDocumentParser, EpubDocumentParser 같은 구체 클래스를 직접 받습니다. 같은 core:data 모듈 안의 일이라 모듈 경계 바깥에는 드러나지 않습니다. 위 OCP 에서 본 파서 구조와 같은 뿌리입니다.
요약 표
| 원칙 | 지켜진 곳 | 비껴간 곳 |
|---|---|---|
| SRP | ReaderRepositoryImpl, DocumentFormatDetector | DocumentRepositoryImpl (3507줄, 생성자 11개), SearchDocumentUseCase와 SearchRepositoryImpl의 같은 정규화 규칙 |
| OCP | PdfMetadataReader + expect/actual | 형식 분기 when, 공통 인터페이스 없는 파서 |
| LSP | DocumentFileSource 계약과 iOS 구현, 기본 구현이 있는 materialize/deleteMaterialized | Android 구현은 접근 실패 시 IllegalStateException 외 예외도 던짐, 실제 구현 테스트 없음 |
| ISP | SearchRepository 등 좁은 저장소 인터페이스 | DocumentRepository 24개 멤버, HomeViewModel은 7개 사용 |
| DIP | feature impl 이 core:domain 에만 의존, binds 로 구현 연결 | DocumentRepositoryImpl 의 구체 파서 의존 |
TeddReader 에서는 모듈 경계와 플랫폼 접점(PdfMetadataReader, DocumentFileSource, 저장소 인터페이스)에 원칙이 적용되어 있고, 가져오기 로직이 모인 DocumentRepositoryImpl에서는 SRP, OCP, DIP 가, 그 클래스가 구현하는 DocumentRepository 인터페이스에서는 ISP 가 비껴갑니다.
참고 자료
- Robert C. Martin, “Design Principles and Design Patterns” (2000)
- Robert C. Martin, “The Open-Closed Principle”, C++ Report (1996)
- Robert C. Martin, “The Dependency Inversion Principle”, C++ Report (1996)
- Robert C. Martin, “The Interface Segregation Principle”, C++ Report (1996)
- Robert C. Martin, “The Liskov Substitution Principle”, C++ Report (1996)
- Robert C. Martin, Agile Software Development, Principles, Patterns, and Practices (Prentice Hall, 2002), 9장 SRP
- Robert C. Martin, Clean Architecture (Pearson, 2018), p.58 (SOLID 약어 출처)
- Robert C. Martin, 9장 SRP 문서 “SRP: The Single Responsibility Principle”
- Barbara Liskov, “Data Abstraction and Hierarchy”, OOPSLA ‘87 Addendum
- Barbara Liskov, Jeannette Wing, “A behavioral notion of subtyping”, ACM TOPLAS 16(6), 1994
- Open–closed principle (Wikipedia) — Meyer, OOSC (1988) 출처 정리
- Kotlin stdlib: error()
- Kotlin stdlib: File.readBytes
- Android ContentResolver.openInputStream
- SOLID (Wikipedia)
- Liskov substitution principle (Wikipedia)
- TeddKo/TeddReader