Anthropic 이 자사 모노레포를 git 에서 직접 만든 시스템으로 옮겼다는 글을 읽었습니다. Redesigning source control at Anthropic 이라는 엔지니어링 포스트이고, 새 시스템의 이름이 Scion 입니다. 저는 Android 앱을 만드는 사람이라 이런 규모의 저장소와는 거리가 멉니다. 그래도 git 이 어디서부터 버거워지는지, 그 앞에서 어떤 선택지가 있는지는 읽을 가치가 있었습니다. 글은 Scion 이 어떻게 생겼는지보다 왜 git 이 맞지 않게 됐는지 에 더 많은 분량을 씁니다.
숫자로 본 문제
포스트가 먼저 꺼내는 주장은 코딩이 더 이상 병목이 아니라는 것입니다. 사람 규모에 맞춰 만든 개발 인프라, 그러니까 소스 컨트롤과 빌드와 CI 가 병목이 됐다고 합니다. 근거로 든 숫자는 이렇습니다.
- 하루에 머지되는 변경이 2026년 5월 약 2,500건에서 9월 3만 건 이상으로 늘었습니다.
- main 브랜치의 히스토리가 100 GB 에 가깝고, 압축한 작업 사본만 25 GB 를 넘습니다.
- CI 가 하루에 체크아웃을 약 2,500만 번 합니다. 개발 환경과 에이전트 샌드박스, 연구용 작업은 이 숫자에 들어 있지 않습니다.
- 그대로 가져오면 git 트래픽이 하루 600 PB 를 넘는다고 계산합니다.
git 의 설계와 이 상황이 어긋나는 지점도 짚습니다. git 은 분산형이라 clone 마다 저장소 전체를 갖고 오프라인에서도 일합니다. 대부분의 저장소에는 맞는 설계지만, 항상 네트워크에 붙어 있는 거대한 모노레포에는 낭비가 됩니다. Anthropic 도 shallow clone, sparse checkout, promisor remote, 내부 git 미러, blob 스토리지에 올려 둔 seed 같은 우회로를 썼다고 합니다. 한창일 때는 미러가 수백 대였고, 머지 속도가 오를수록 운영이 어려워졌으며 seed 는 main 의 끝에서 점점 뒤처졌다고 적혀 있습니다.
이 대목이 저에게는 가장 현실적으로 읽혔습니다. 규모가 다를 뿐 “clone 이 느려서 CI 에 캐시를 깔고, 캐시가 낡아서 또 무언가를 붙이는” 과정은 어느 팀에서나 겪는 일이니까요.
Scion 은 어떻게 생겼나
설계 원칙은 여섯 가지로 정리돼 있습니다. 클라이언트는 항상 온라인이라고 가정하고 필요한 데이터를 그때그때 가져옵니다. 히스토리, blame, 커밋, merge, rebase 는 서버가 맡고 클라이언트는 제한된 객체 캐시와 파일 배치, 파일시스템 감시만 합니다. 소스 컨트롤이 서비스라서 모든 조회를 API 로 열어 두고, 자동 bisect 나 revert 파이프라인이 이 API 에 기댑니다. 서버 어디에도 전체 복사본이 없고 packfile 이나 저장소 유지보수도 없습니다. 커밋은 서버에서 일어나므로 push 할 것이 없고, 비용이 저장소 크기가 아니라 변경 크기에 비례합니다. 작업 디렉터리는 선택 사항이어서 CI 가 체크아웃 없이 diff 를 받거나 API 로 쓰기를 할 수 있습니다.
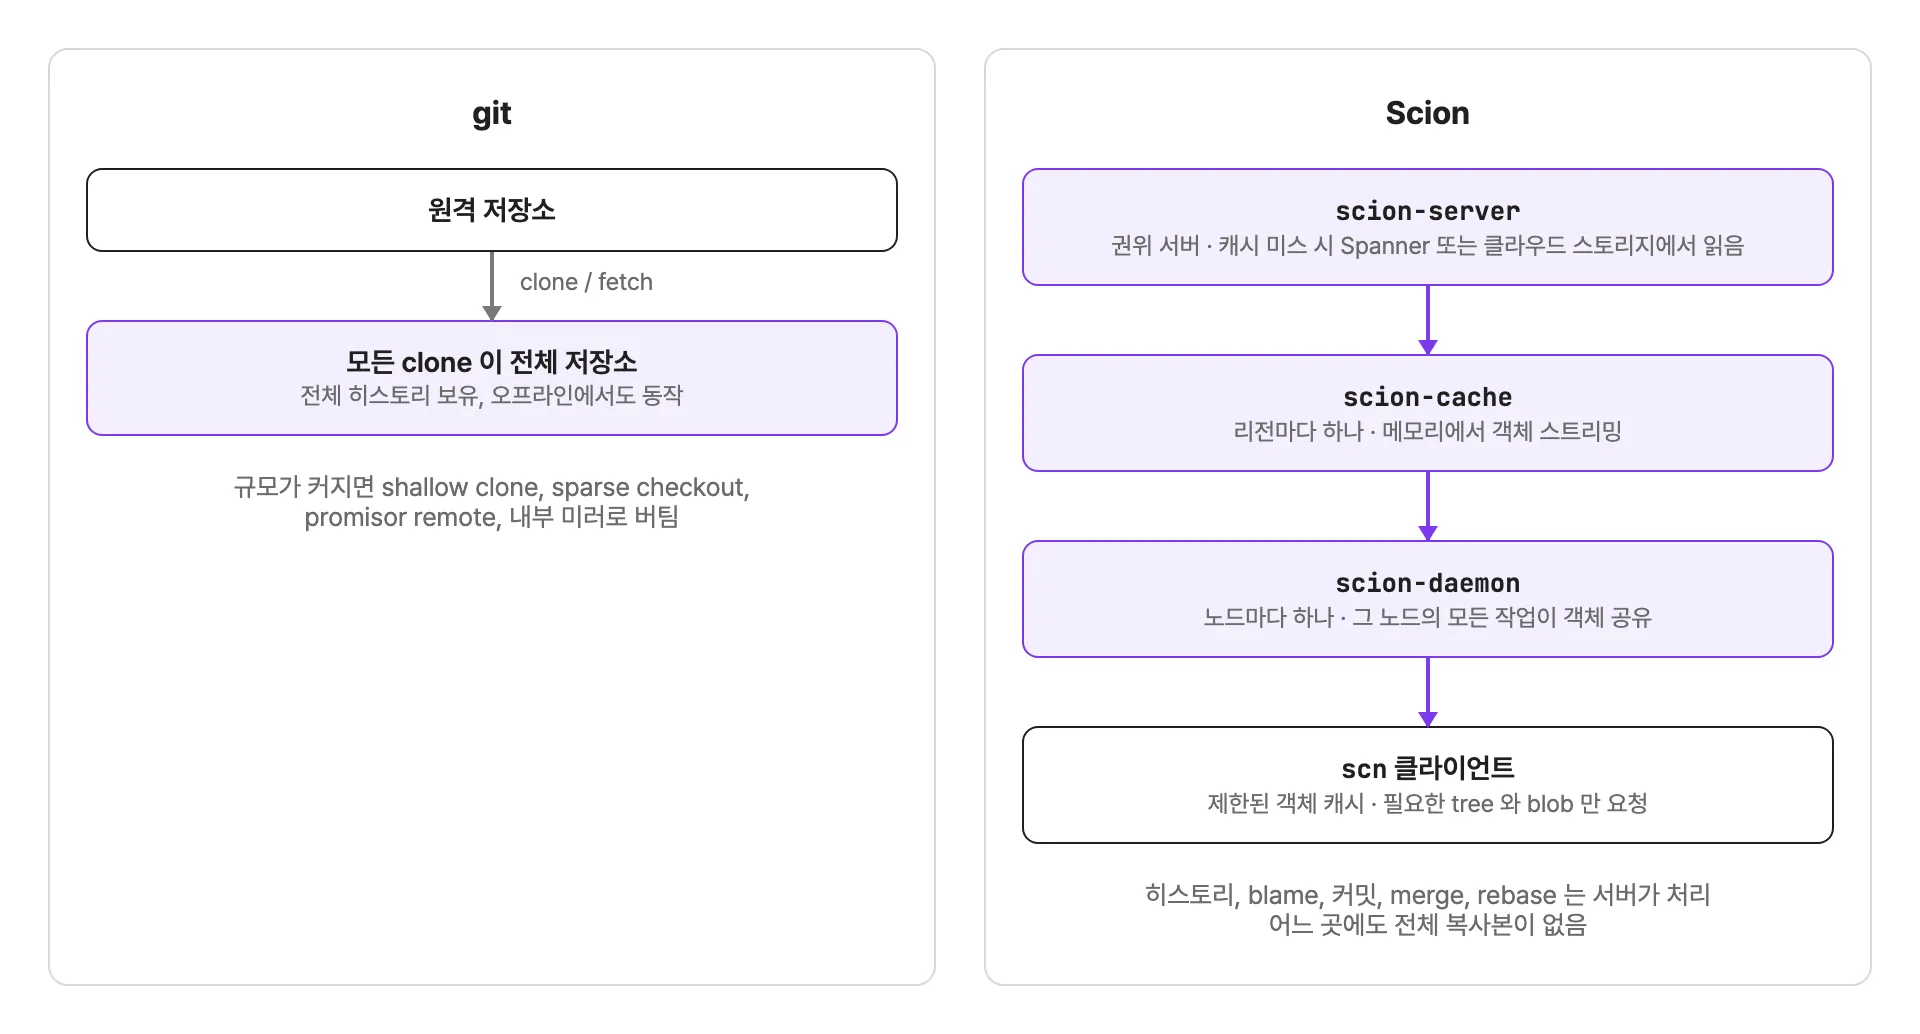
데이터 모델에서 눈에 띄는 건 changeset 입니다. write-ahead log 의 항목이고 서버에서 만들어져 만든 즉시 어디서나 보입니다. git 커밋이 트리 하나를 가리키는 것과 달리, changeset 은 첫 번째 부모를 기준으로 바뀐 파일의 목록과 압축된 blob 의 content-addressed 포인터를 들고 있습니다. ref 는 Spanner 의 한 행을 compare-and-swap 으로 갱신하는 작업이고 changeset 생성과 분리돼 있습니다. blame, 경로 히스토리, commit-graph 의 skip list, 복사 탐지, 경로 기반 파일 검색 같은 파생 데이터는 부모로부터 재귀적으로 계산하는 하나의 장치로 만듭니다.
가져오는 방식도 git 의 fetch 와 다릅니다. scn 클라이언트는 이미 가진 것을 서버와 대조하지 않고, 원하는 tree 와 blob 에 대해서만 협상합니다. 루트 tree 에서 시작해 없는 tree 를 재귀적으로 요청하고 그다음에 blob 을 받습니다. 요청이 전부 불변 객체 하나를 가리키기 때문에 어떤 캐시든 답할 수 있고, 거대한 packfile 이 없어서 전송이 효율적이고 이어받기도 됩니다.
서버 쪽은 세 계층입니다. 노드마다 scion-daemon 이 떠서 그 노드의 모든 작업이 쓰는 객체를 저장하고, 주기적으로 갱신되는 스냅샷에서 출발합니다. 리전마다 있는 scion-cache 는 daemon 의 디스크 형식 그대로 메모리에서 객체를 흘려 보냅니다. 권위 있는 scion-server 는 캐시에 없을 때 Spanner 나 클라우드 스토리지를 읽습니다. 세 계층이 같은 RPC 에 응답하고, 장애 영역을 나누려고 계층 건너뛰기를 엄격히 막는다고 합니다. 각 계층의 캐시 적중률은 99% 를 넘고 오래 유지되는 상태는 없다는 설명입니다.
결과로 공개한 수치는 이전 git 미러링 인프라 대비 CPU 와 메모리 사용이 약 200분의 1, CI 와 연구용 체크아웃이 분 단위에서 초 단위로, CI 의 CPU 여유가 약 25% 늘었다는 것입니다. 이 수치는 모두 Anthropic 자신의 측정이라는 점은 알고 읽어야 합니다.
다섯 달, 일곱 명
개발 과정 이야기도 있습니다. 일곱 명의 팀이 Scion 과 코드 리뷰 도구 Antique, 그 밖의 시스템 여섯 개 안팎을 만들고, 하루 머지가 10배 늘어나는 동안 다섯 달 만에 이관을 끝냈다고 합니다. Claude 와 함께 개발했고 사람의 역할은 설계 판단과 “아니오” 라고 말하는 일이었다고 적었습니다. 에이전트가 코드 리뷰 도구에 질의하지 않고 커밋 로그를 선형으로 훑거나, 있지도 않은 우려에 대비해 방어적 검증을 과하게 넣은 예가 나옵니다. 초기에 손으로 쓴 git-to-Scion 수집 프로토타입을 내부 Claude 모델이 다시 쓰자 메모리는 20분의 1, 속도는 4배가 됐다는 일화도 있습니다.
운영 쪽에는 눈여겨볼 문장이 하나 있습니다. 전역 락을 쓰는 전통적 머지 큐는 에이전트 규모에 맞지 않아서, 머지 이후와 배포 이전 단계의 테스트에 더 투자했다고 합니다. 충돌은 동시 변경에서 생길 수 있지만 Claude 가 보통 빨리 고친다는 설명이 붙습니다. 머지 큐 자체의 상세 설계는 글에 나오지 않습니다.
스스로 밝힌 한계
가장 중요한 부분은 Anthropic 이 직접 적어 둔 단서입니다. Scion 은 git 의 범용 대체재가 아니고, 아주 큰 모노레포이거나 에이전트 무리를 돌리는 경우에만 의미가 있다고 합니다. git 과 갈라진 시스템이라 도입하려면 코드 리뷰, 코드 검색, CI 도 함께 옮겨야 하는데 사내 도구가 전부 맞춤 제작이라는 이야기도 나옵니다. 내부 토큰 사용량이 대부분의 기업이 쓰는 양을 훨씬 웃돈다는 점도 맥락으로 밝힙니다.
그래서 Scion 을 다른 조직이 그대로 쓸 수 있는 형태로 내놓기는 어렵다고 봅니다. 대신 git 사용자가 모델의 일부를 가져다 쓸 수 있도록 아이디어를 공유한다는 입장이고, 새로운 서버 구조, 포지 사이에서 표준화될 수도 있는 포괄적인 서버 측 RPC, 다른 협상 프로토콜, 서로 잘 어울리는 sparse 와 shallow 기능을 방향으로 제시합니다. GitHub, GitLab, 오픈소스 커뮤니티와 일하고 싶다는 말도 있습니다. git 과의 상호 운용이 어떻게 되는지는 이 정도 외에는 글에 나오지 않습니다.
비슷한 시스템들과 놓아 보면
글은 선행 사례로 Google 의 Piper 와 Meta 의 Sapling 을 듭니다. 특히 Sapling 의 서버 Mononoke 가 개척한 Bonsai 데이터 모델을 Scion 이 참고했다고 밝힙니다. 제가 앞서 Sapling 과 jj 를 정리한 글에서 다룬 것은 클라이언트 sl 쪽이었는데, 이번에는 서버 쪽이 주인공입니다.
Sapling 의 README 에 따르면 구성은 클라이언트, 서버 Mononoke, 가상 파일시스템 EdenFS 입니다. Mononoke 와 EdenFS 는 Meta 안에서는 운영 중이지만 외부 사용은 아직 지원하지 않는다고 적혀 있습니다. Meta 가 Sapling 을 공개하며 쓴 글은 서버와 가상 파일시스템을 함께 쓰면 수천만 개의 파일, 커밋, 브랜치로 확장된다고 하고, 가상 파일시스템은 저장소 전체가 있는 것처럼 보이게 해서 clone 과 체크아웃을 빠르게 한다고 설명합니다. 서버가 push 때 rebase 를 대신한다는 점도 Scion 이 서버에 일을 몰아주는 방향과 닮았습니다.
한편 git 자체도 같은 방향으로 움직여 왔습니다. partial clone 은 clone 과 fetch 때 필요 없는 객체를 건너뛰고 필요해지면 promisor remote 에서 가져오는 기능입니다. git clone --filter=blob:none 처럼 서버에 필터를 넘기고, 체크아웃 같은 일괄 작업은 필요한 blob 을 한 번에 미리 받습니다. 대신 없는 객체가 필요해질 때마다 네트워크가 필요하고, 하나씩 가져오면 느릴 수 있다고 문서에 적혀 있습니다. sparse-checkout 은 작업 트리를 파일 일부로 줄여서, 지정한 경로 밖의 파일은 디스크에 쓰지 않습니다. 기본인 cone 모드는 디렉터리를 지정하는 방식이고, 문서는 패턴을 쓰는 non-cone 모드를 확장성이 떨어진다며 비권장으로 적습니다. 이 둘을 설정까지 묶어 주는 것이 Scalar 입니다. scalar clone 은 commit 과 tree 만 가져오고 기본으로 sparse-checkout 을 켜며 백그라운드 유지보수를 등록합니다.
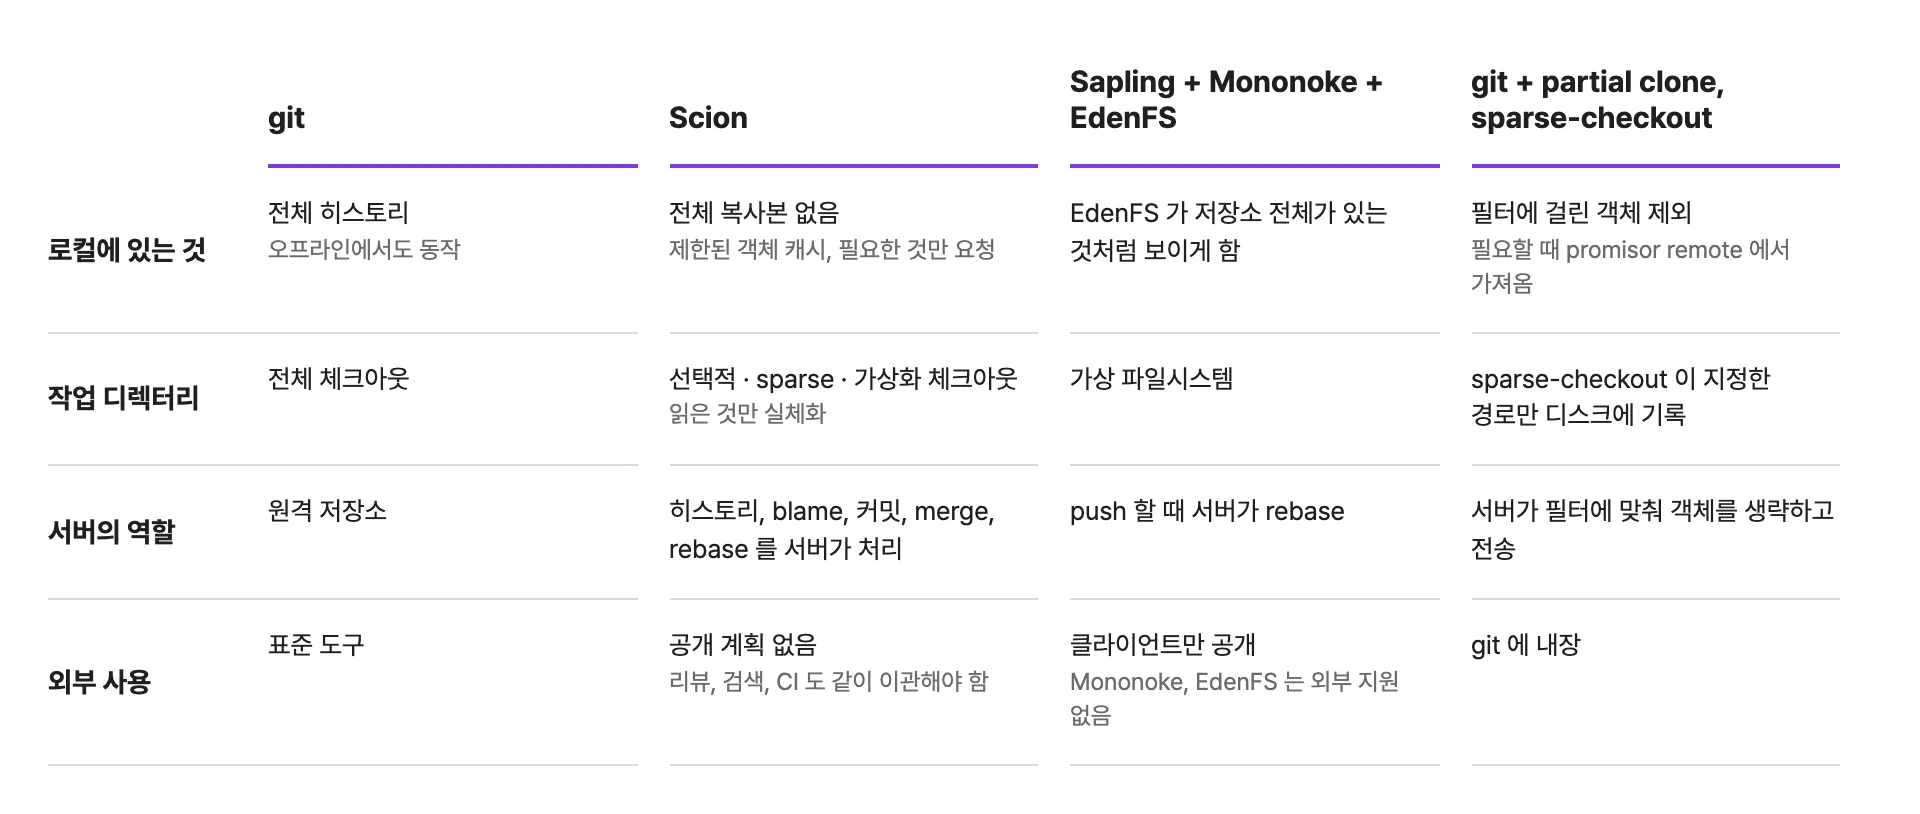
표로 놓고 보면 세 시스템이 같은 방향의 서로 다른 지점에 서 있다는 느낌입니다. 로컬에 전부 두지 않고, 필요한 것만 가져오고, 서버가 더 많은 일을 맡는다는 점은 같습니다. 차이는 어디까지 가느냐입니다. partial clone 은 git 의 데이터 모델을 그대로 두고 전송량만 줄입니다. Scion 은 서버 어디에도 전체 복사본이 없고 packfile 도 없는, 처음부터 다시 그린 구조입니다.
일반 팀이 가져갈 것
Scion 이 우리에게 필요한가 하면, 거의 확실히 아닙니다. Anthropic 스스로 아주 큰 모노레포나 에이전트 무리가 있을 때에만 의미가 있다고 적었고, 도입하면 리뷰와 검색과 CI 까지 갈아엎어야 합니다. 이 글에서 현실적으로 가져갈 것은 시스템이 아니라 방향입니다.
저장소가 느려졌다면 순서는 비슷할 겁니다. 먼저 CI 에서 전체 히스토리가 꼭 필요한지 봅니다. 많은 경우 필요 없어서 shallow clone 이나 --filter=blob:none 만으로 체크아웃이 눈에 띄게 줄어듭니다. 모듈이 많은 Android 프로젝트라면 sparse-checkout 의 cone 모드로 내가 만지는 모듈만 받는 것도 방법입니다. 여러 사람이 큰 저장소를 쓴다면 Scalar 가 이 설정들을 한꺼번에 해 주니 직접 조합하기 전에 한 번 볼 만합니다. 모노레포 쪽 이야기는 서버 모노레포 글에서 영향 범위 빌드 중심으로 적은 적이 있는데, 저장소 크기 문제는 빌드와 별개로 따로 옵니다.
머지 큐는 조금 다르게 읽어야 합니다. Anthropic 이 전역 락 머지 큐를 버린 이유는 하루 3만 건이라는 머지 속도와 에이전트 때문입니다. 사람이 하루에 열 몇 건을 머지하는 팀에서는 머지 큐가 오히려 main 을 깨지 않게 지켜 주는 쪽의 이득이 큽니다. 브랜치 전략을 정하는 문제와도 이어집니다. gitflow 글에서 다룬 것처럼 브랜치가 길어질수록 통합 비용이 커지는데, Scion 이 ref 를 main 과 릴리스 브랜치 정도로만 두라고 권하는 것도 같은 맥락입니다. 스택 PR 도구들은 변경을 작게 쪼개 자주 올리는 쪽을 돕고, merge 와 rebase 를 비교한 글에서 적은 “내 history 는 깨끗하게” 원칙을 실수 없이 지키게 해 줍니다.
Scion 글에서 제가 정말로 가져가고 싶은 건 설계 원칙 하나입니다. 도구가 사람 규모를 전제로 만들어졌다면, 그 전제가 깨지는 지점에서 먼저 터지는 것은 코드가 아니라 클론, 미러, 캐시, 큐 같은 주변부입니다. 에이전트가 팀에 들어오기 시작하면 커밋과 CI 실행이 늘어나는 속도가 우리 도구의 가정을 시험할 수 있습니다. 그때 해야 할 일은 git 을 버리는 것이 아니라 어느 가정이 먼저 깨지는지 재 보는 것이라고 생각합니다.